flowchart TD
    R(("Fatos<br/>Estilizados"))
    R --> A["<b>Caudas pesadas</b><br/>Excesso de curtose<br/>Eventos extremos frequentes"]
    R --> B["<b>Clusters de volatilidade</b><br/>Períodos calmos e turbulentos<br/>Volatilidade persistente"]
    R --> C["<b>Efeito alavancagem</b><br/>Quedas geram mais volatilidade<br/>Medo > Euforia"]
    R --> D["<b>Sem autocorrelação nos retornos</b><br/>r_t quase i.i.d.<br/>Mas r_t² tem forte ACF!"]

    classDef root fill:#E50505,stroke:#3F3F3F,stroke-width:2px,color:#fff
    classDef fact fill:#ffffff,stroke:#3F3F3F,stroke-width:1.5px,color:#3F3F3F
    class R root
    class A,B,C,D fact

    linkStyle default stroke:#3F3F3F,stroke-width:1.5px
Ponte para Finanças: Preços, Retornos e Fatos Estilizados
Por que séries financeiras pedem modelos próprios
Objetivos de Aprendizagem
- Calcular retornos simples e log-retornos a partir de preços (ajustados)
- Agregar retornos no tempo e entre ativos, e anualizar médias e volatilidades
- Identificar os fatos estilizados de séries financeiras em dados reais
- Relacionar a hipótese de mercado eficiente com o que é (e o que não é) previsível
De Séries Temporais para Finanças
Até agora, trabalhamos com séries que tipicamente têm tendência e sazonalidade (vendas, PIB, inflação). Séries financeiras (retornos de ações, câmbio, commodities) são fundamentalmente diferentes. Os retornos geralmente não têm tendência nem sazonalidade forte, mas apresentam fenômenos que exigem novos modelos.
Esta aula é a ponte entre as duas partes do curso: reaproveitamos o vocabulário da Parte 1 (estacionariedade, random walk, ACF) e o aplicamos a preços e retornos. Tudo o que vem depois (volatilidade, VaR, CAPM, portfólios) é construído sobre a série de retornos, e não sobre a série de preços.
Preço, Preço Ajustado e Retorno
Qual preço usar?
O preço de fechamento “bruto” de uma ação sofre saltos que não são ganho nem perda para o investidor: pagamento de dividendos e JCP (o preço cai no dia ex), desdobramentos e grupamentos. O preço ajustado corrige a série histórica para esses eventos, de modo que a variação percentual entre dois dias reflita o retorno total de quem manteve o ativo.
AvisoRegra prática
Para calcular retornos, use sempre o preço ajustado (no yfinance, auto_adjust=True, que é o padrão nas versões recentes). Para FIIs e ações boas pagadoras de dividendos, a diferença acumulada em poucos anos chega a dezenas de pontos percentuais.
Retorno e Log-Retorno
Retorno simples \[R_t = \frac{P_t - P_{t-1}}{P_{t-1}} = \frac{P_t}{P_{t-1}} - 1\]
Log-retorno (retorno continuamente composto) \[r_t = \ln\left(\frac{P_t}{P_{t-1}}\right) = \ln(P_t) - \ln(P_{t-1})\]
DicaPor que usar log-retorno?
- Aditividade temporal: \(r_{t:t+k} = r_t + r_{t+1} + \cdots + r_{t+k}\), o que facilita os cálculos
- Simetria: uma queda de 50% (\(R = -0.5\)) exige alta de 100% (\(R = +1.0\)) para recuperar, mas em log são \(-0.69\) e \(+0.69\)
- Aproximação: para retornos pequenos (\(|R_t| < 0.1\)), \(r_t \approx R_t\)
- Conexão com a Parte 1: \(\ln P_t\) é (aproximadamente) uma random walk, e \(r_t\) é exatamente a sua primeira diferença
Agregação: no tempo e entre ativos
Os dois tipos de retorno têm propriedades complementares, e é comum usar os dois no mesmo projeto:
| Agregação | Log-retorno \(r_t\) | Retorno simples \(R_t\) |
|---|---|---|
| No tempo (dia → mês → ano) | Soma: \(r_{\text{mês}} = \sum_{d} r_d\) | Produto: \(1 + R_{\text{mês}} = \prod_d (1 + R_d)\) |
| Entre ativos (carteira) | Não é a média ponderada | Média ponderada: \(R_{p,t} = \sum_i w_i R_{i,t}\) |
Por isso, a otimização de carteiras (Aula de CAPM e Portfólios) usa retornos simples, enquanto modelos de volatilidade costumam usar log-retornos.
Anualização
Com \(n\) períodos por ano (252 dias úteis, 52 semanas, 12 meses) e supondo retornos aproximadamente i.i.d.:
Média e volatilidade anualizadas \[\mu_{\text{anual}} \approx n\,\bar r, \qquad \sigma_{\text{anual}} \approx \sqrt{n}\;\sigma_{\text{diário}}\]
A regra da raiz (\(\sqrt{n}\)) volta na aula de VaR, para mudar o horizonte do risco. Ela depende da hipótese de independência, e é exatamente essa hipótese que os fatos estilizados abaixo colocam em xeque.
Fatos Estilizados de Séries Financeiras
Estas são regularidades empíricas observadas em praticamente todos os mercados financeiros ao redor do mundo:
Na prática: o Ibovespa
O código abaixo baixa o Ibovespa diário e verifica três dos quatro fatos estilizados.
Código
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import yfinance as yf
from scipy import stats
from statsmodels.graphics.tsaplots import plot_acf

precos = yf.download("^BVSP", start="2010-01-01", end="2026-10-01",
                     auto_adjust=True, progress=False)["Close"].squeeze().dropna()
r = np.log(precos).diff().dropna() * 100   # log-retorno diário, em %

resumo = pd.Series({
    "Observações": len(r),
    "Média diária (%)": r.mean(),
    "Volatilidade diária (%)": r.std(),
    "Volatilidade anualizada (%)": r.std() * np.sqrt(252),
    "Assimetria": stats.skew(r),
    "Curtose (normal = 3)": stats.kurtosis(r, fisher=False),
}).round(3)
resumo.to_frame("Ibovespa (log-retorno diário)")| Ibovespa (log-retorno diário) | |
|---|---|
| Observações | 4151.000 |
| Média diária (%) | 0.024 |
| Volatilidade diária (%) | 1.450 |
| Volatilidade anualizada (%) | 23.016 |
| Assimetria | -0.764 |
| Curtose (normal = 3) | 14.975 |
Código
fig, axes = plt.subplots(2, 1, figsize=(10, 6), sharex=True)
axes[0].plot(precos.index, precos, color="#3F3F3F", lw=0.8)
axes[0].set_ylabel("Pontos")
axes[0].set_title("Ibovespa: preço")
axes[1].plot(r.index, r, color="#E50505", lw=0.5)
axes[1].set_ylabel("Log-retorno (%)")
axes[1].set_title("Ibovespa: log-retorno diário")
for ax in axes:
    ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()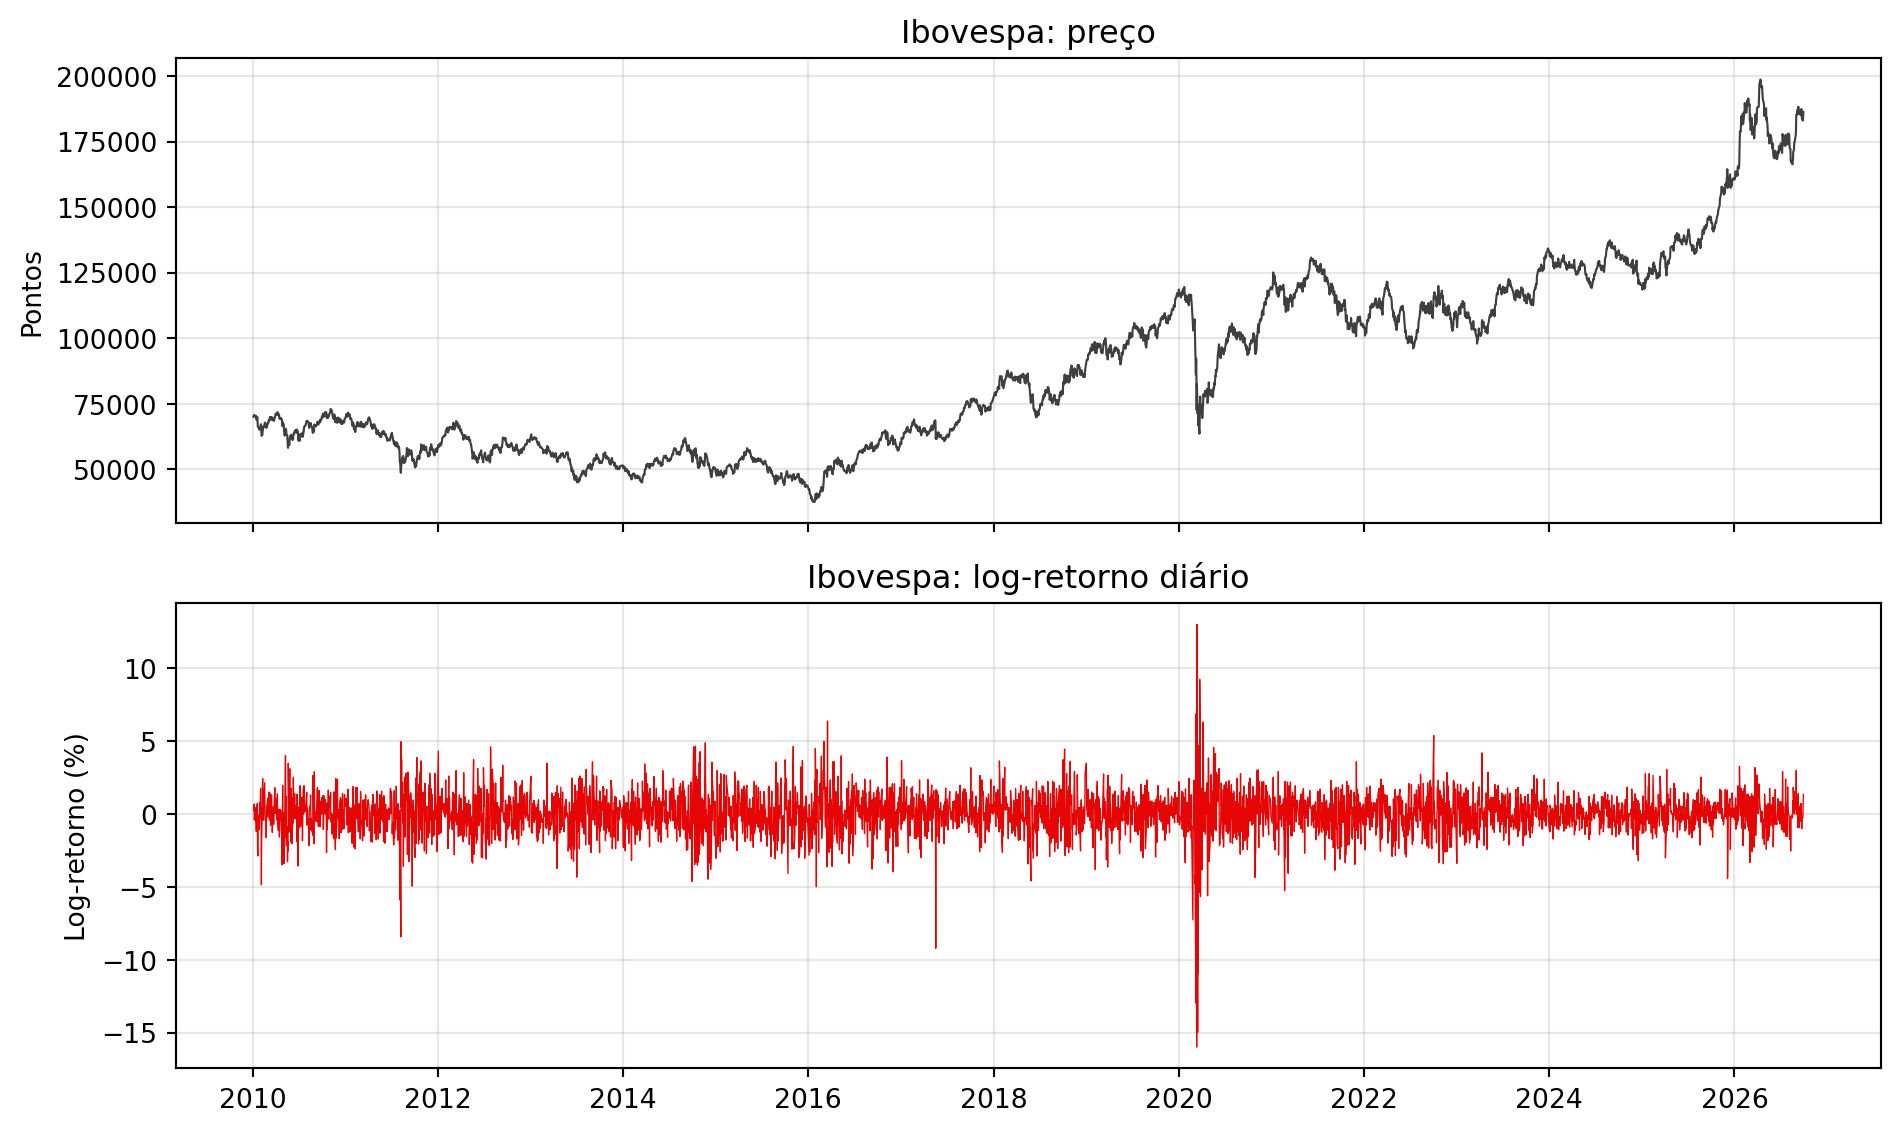
Código
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
x = np.linspace(r.min(), r.max(), 400)
axes[0].hist(r, bins=120, density=True, color="#DCDCDC", edgecolor="#3F3F3F", lw=0.3)
axes[0].plot(x, stats.norm.pdf(x, r.mean(), r.std()), color="#E50505", lw=1.5, label="Normal")
axes[0].set_xlim(-8, 8)
axes[0].legend()
axes[0].set_title("Histograma vs. normal")
stats.probplot(r, dist="norm", plot=axes[1])
axes[1].get_lines()[0].set_markersize(2)
axes[1].set_title("Q-Q plot contra a normal")
plt.tight_layout()
plt.show()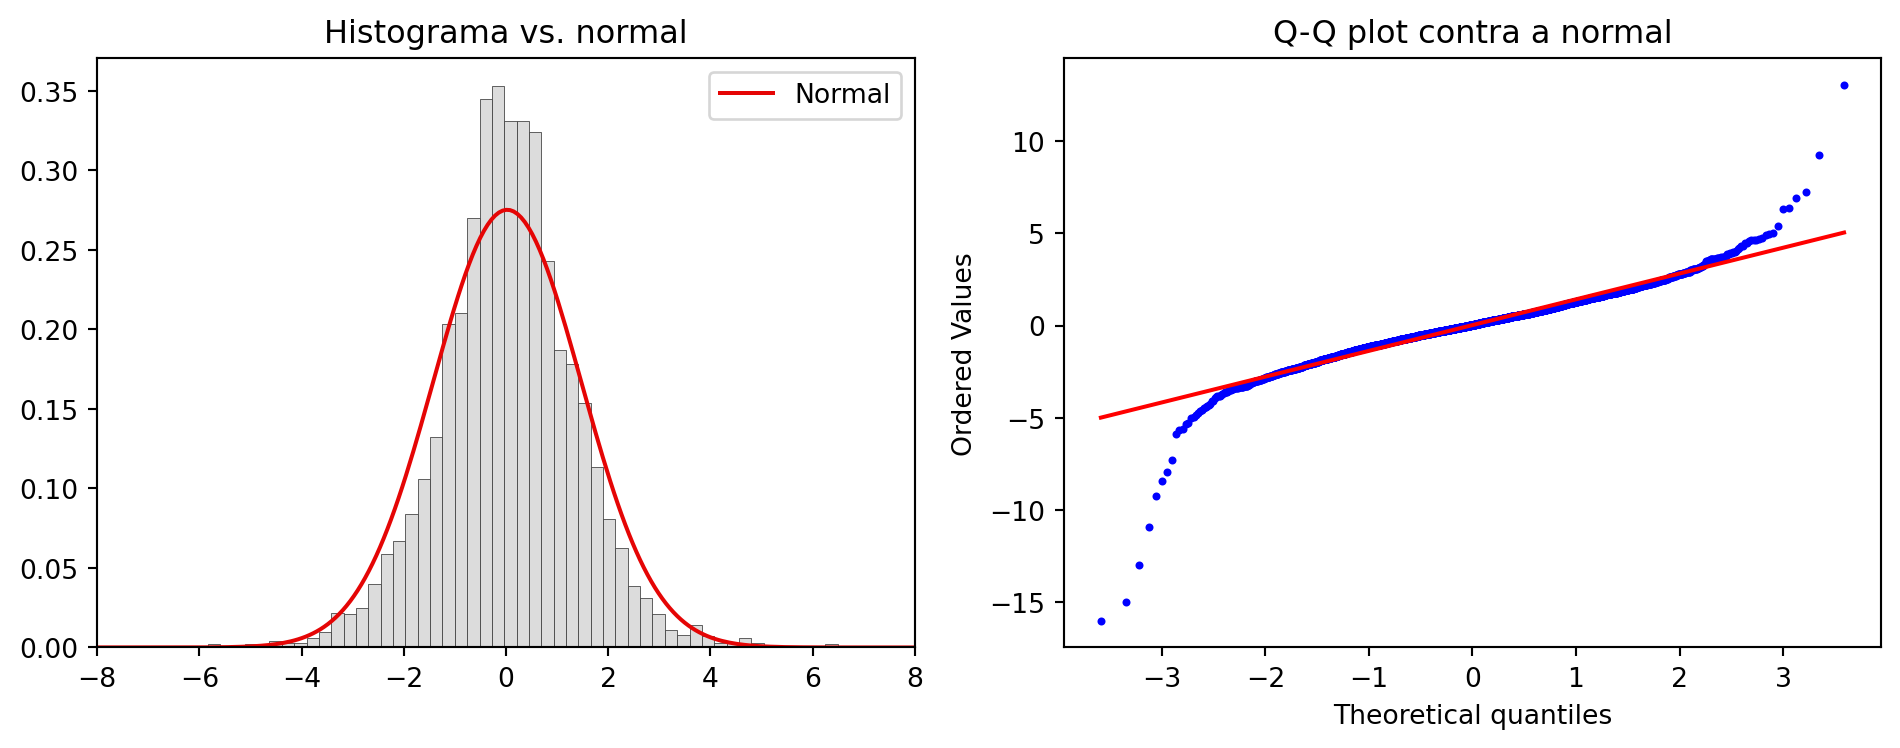
Código
fig, axes = plt.subplots(1, 2, figsize=(10, 3.5))
plot_acf(r, lags=40, ax=axes[0], zero=False, title="ACF de $r_t$")
plot_acf(r**2, lags=40, ax=axes[1], zero=False, title="ACF de $r_t^2$")
for ax in axes:
    ax.set_ylim(-0.1, 0.4)
plt.tight_layout()
plt.show()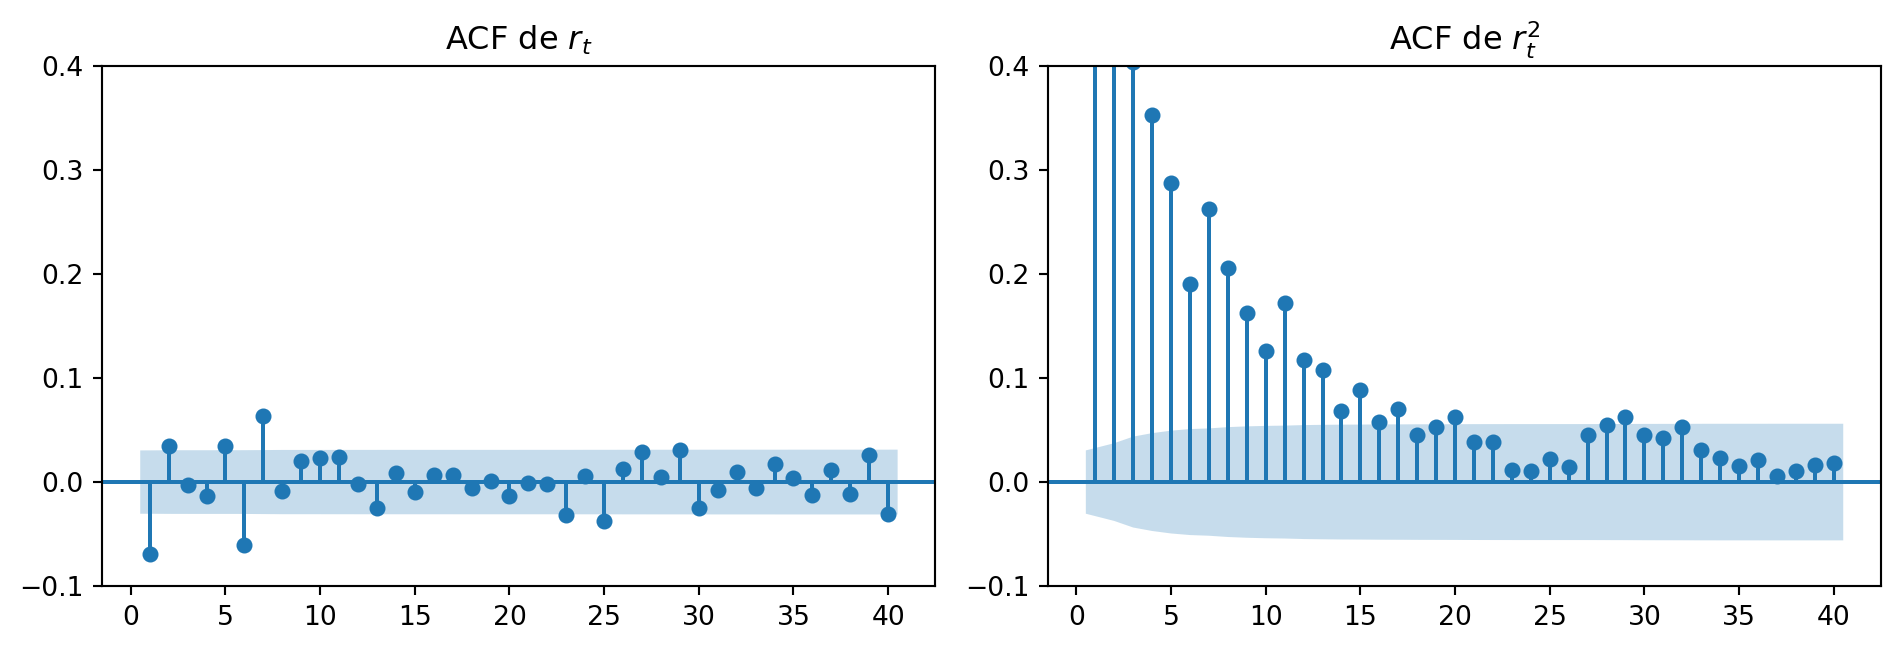
NotaO que observar
- Preço com cara de random walk; retorno oscilando em torno de zero, mas com períodos agitados (2020, por exemplo) e períodos calmos.
- Curtose bem acima de 3: eventos de 4 ou 5 desvios-padrão acontecem muito mais do que a normal prevê.
- ACF de \(r_t\) praticamente dentro das bandas; ACF de \(r_t^2\) alta e decaindo devagar. É essa memória na magnitude que os modelos GARCH vão capturar.
Mercado eficiente, random walk e volatilidade
Vale conectar o quarto fato estilizado, a ausência de autocorrelação nos retornos, com um conceito que apareceu já em Fundamentos (random walk) e que é a base conceitual de praticamente toda finanças moderna: a hipótese do mercado eficiente (EMH).
Na sua versão mais comum (forma fraca), a EMH afirma que o preço atual já incorpora toda a informação contida no histórico de preços. A consequência estatística é simples e poderosa: se fosse possível prever a direção do próximo retorno a partir dos retornos passados, haveria uma oportunidade de arbitragem; traders a explorariam, e o padrão desapareceria. Em equilíbrio, portanto, a série de retornos deve ser aproximadamente não-autocorrelacionada.
Isso é exatamente o que observamos nos dados: a ACF dos retornos é tipicamente indistinguível de ruído branco. Equivalentemente, o preço segue aproximadamente uma random walk (a forma mais simples de processo não-estacionário, vista em Fundamentos), já que
\[P_t = P_{t-1} \exp(r_t), \qquad r_t \approx \text{ruído}.\]
Mas, e aqui está o ponto central para a próxima aula, ausência de autocorrelação não é o mesmo que independência. Duas variáveis podem ser não-correlacionadas e ainda assim estatisticamente dependentes através de momentos de ordem mais alta. É exatamente isso que acontece com retornos financeiros: \(\text{Corr}(r_t, r_{t-k}) \approx 0\), mas \(\text{Corr}(r_t^2, r_{t-k}^2) \gg 0\).
O Paradoxo Fundamental
A EMH proíbe prever a direção do próximo retorno, mas não proíbe prever sua magnitude. Os retornos são quase não-correlacionados (compatível com mercado eficiente), mas os retornos ao quadrado têm ACF forte e persistente. Podemos prever a incerteza de amanhã, mesmo sem saber o sinal. Essa é a brecha que os modelos GARCH exploram: eles não quebram a EMH, eles operam exatamente no espaço que a EMH deixa livre.
De onde vêm os dados?
Nesta aula usamos o yfinance: gratuito e prático, mas sem garantia de qualidade (o Yahoo pode mudar ou bloquear a API a qualquer momento, e ajustes por proventos de ativos brasileiros às vezes têm falhas). Em uma empresa, a análise costuma partir de uma base profissional, como Bloomberg, Refinitiv/LSEG, Economatica ou S&P Capital IQ Pro.
O Insper licencia o S&P Capital IQ Pro pela Biblioteca Telles. Segundo a página da Biblioteca, a plataforma reúne “dados de mais de 109 mil empresas de capital aberto, 60 milhões de empresas privadas, transações de mercado, dados macroeconômicos, ESG, crédito e mercado de capitais”, e o acesso é feito via OpenAthens, no DataLab da Biblioteca ou remotamente, mediante solicitação a biblioteca@insper.edu.br.
O que ela agrega em relação ao yfinance, para os temas da Parte 2:
| Necessidade | yfinance |
S&P Capital IQ Pro |
|---|---|---|
| Preços e retornos diários | Sim (preço ajustado do Yahoo) | Sim, incluindo dados de dividendos |
| Fundamentos (receita, dívida, margens) | Parcial, poucos anos | Demonstrações padronizadas entre países, em base anual, trimestral e LTM |
| Contexto para o storytelling | Não | Notícias, transcrições de conference calls, ratings de crédito, relatórios setoriais |
| Encontrar ativos com um perfil | Não | Screening (ex.: empresas da B3 de um setor, por valor de mercado e alavancagem) |
DicaExemplo: do Capital IQ Pro para o notebook
Um fluxo típico para quem quer usar a base no próprio projeto:
- Screening na plataforma web: por exemplo, empresas listadas na B3 do setor elétrico, com valor de mercado acima de R$ 5 bilhões. O resultado é uma lista de empresas com identificadores e métricas, exportável para Excel.
- Plug-in do Excel (Windows): fórmulas
=CIQ(identificador, código_do_campo, ...)trazem campos para células. A sintaxe documentada por bibliotecas universitárias é, por exemplo,=CIQ("GV_001690", "IQ_COMPANY_NAME"); o Formula Builder do plug-in mostra o código exato de cada campo (preço de fechamento, valor de mercado, beta etc.), e os tickers da B3 seguem o padrão bolsa:código. - Leitura no Python: a planilha exportada vira um
DataFramee segue o mesmo pipeline desta aula.
import numpy as np
import pandas as pd

# Planilha exportada do Capital IQ Pro: uma coluna de datas e uma coluna de
# preço de fechamento ajustado por ativo (os nomes dependem da exportação)
precos = (pd.read_excel("capiq_precos.xlsx", parse_dates=["Data"])
            .set_index("Data")
            .sort_index())

retornos = np.log(precos).diff().dropna()      # log-retornos, como acima
retornos.std() * np.sqrt(252)                  # volatilidade anualizada por ativo
Vale a regra de sempre: documente a fonte e a data de extração, e confira algumas datas contra uma segunda fonte (o próprio yfinance serve) antes de modelar.
O que vem a seguir
flowchart LR
    A["Retornos<br/>(esta aula)"] --> B["Volatilidade<br/>ARCH / GARCH"]
    B --> C["Risco<br/>VaR e ES"]
    A --> D["Retorno esperado<br/>CAPM"]
    C --> E["Carteira<br/>Markowitz"]
    D --> E

    classDef hoje fill:#E50505,stroke:#3F3F3F,color:#fff
    classDef prox fill:#ffffff,stroke:#3F3F3F,color:#3F3F3F
    class A hoje
    class B,C,D,E prox
- Volatilidade e GARCH: como modelar \(\sigma_t\) que muda no tempo.
- VaR e Gestão de Risco: como transformar \(\sigma_t\) em uma medida de perda.
- CAPM e Portfólios: como combinar ativos considerando retorno e risco.
Quizzes: Teste seu Entendimento
CuidadoQuestão 1: Uma ação caiu 20% em um dia e subiu 20% no dia seguinte. O investidor está no zero a zero?
Não. Com retornos simples, \((1 - 0{,}2)(1 + 0{,}2) = 0{,}96\): perda de 4%. Em log-retornos, \(\ln(0{,}8) + \ln(1{,}2) = -0{,}223 + 0{,}182 = -0{,}041\), que é o log de 0,96. A assimetria dos retornos simples desaparece em log, e por isso log-retornos somam no tempo.
CuidadoQuestão 2: A volatilidade diária de um ativo é 2%. Qual a volatilidade anual aproximada? Qual hipótese você usou?
\(2\% \times \sqrt{252} \approx 31{,}7\%\) ao ano. A conta supõe retornos independentes e identicamente distribuídos. Com clusters de volatilidade, a volatilidade dos próximos dias depende do regime atual, e a regra da raiz é só uma aproximação.
CuidadoQuestão 3: Por que não modelamos diretamente o preço com um ARIMA para prever o mercado?
O log-preço se comporta como uma random walk: o ARIMA escolheria algo como ARIMA(0,1,0), cuja melhor previsão é “amanhã igual a hoje”. Isso é consistente com a forma fraca da EMH. O que é previsível nas séries financeiras é a magnitude dos movimentos (volatilidade), não a sua direção.
CuidadoQuestão 4: A curtose amostral dos retornos de um ativo é 9. O que isso implica para o risco?
Curtose 9 (contra 3 da normal) indica caudas pesadas: perdas extremas são muito mais frequentes do que a normal sugere. Um VaR calculado com a normal vai subestimar o risco de cauda, e por isso usaremos distribuições como a \(t\) de Student nas próximas aulas.
CuidadoQuestão 5: Por que usar preço ajustado em vez de preço de fechamento para calcular retornos de um FII?
FIIs distribuem rendimentos mensalmente, e o preço cai na data ex. Usando o fechamento bruto, essas quedas aparecem como perdas, e o retorno (e o Sharpe) do FII fica sistematicamente subestimado. O preço ajustado reincorpora os proventos e mede o retorno total do investidor.
Para Saber Mais
- Cont, R. (2001). Empirical properties of asset returns: stylized facts and statistical issues. Quantitative Finance, 1(2), 223-236.
- Tsay, R.S. (2010). Analysis of Financial Time Series, Cap. 1. Wiley.
- Morettin, P.A. (2017). Econometria Financeira, Cap. 1-2. Blucher.
- S&P Global Market Intelligence. S&P Capital IQ Pro. Acesso pela Biblioteca Telles do Insper.
- Fama, E. (1970). Efficient Capital Markets: A Review of Theory and Empirical Work. Journal of Finance, 25(2).