---
title: "Lab 3 (versão alternativa): blue-chips e fronteira por otimização"
subtitle: "Pipeline completo com 8 ações líquidas, GARCH e fronteira via scipy.optimize"
jupyter: python3
---
::: {.callout-note}
## Versão alternativa
Esta é a **versão alternativa** do Lab 3, com 8 blue-chips da B3 e a fronteira eficiente
resolvida por otimização (`scipy.optimize`). A
versão **oficial** do laboratório usa fundos imobiliários, fronteira por Monte Carlo, VaR
via t de Student e CAPM: veja [Lab 3 oficial](lab03-financeiras.qmd).
:::
::: {.objetivos}
#### Objetivos do Lab
- [Aplicar]{.bloom-badge .bloom-aplicar} download e tratamento de dados financeiros com `yfinance`
- [Analisar]{.bloom-badge .bloom-analisar} fatos estilizados em ativos brasileiros
- [Criar]{.bloom-badge .bloom-criar} modelos GARCH e portfólios otimizados
- [Avaliar]{.bloom-badge .bloom-avaliar} carteiras de mínima variância e máximo Sharpe pela relação risco-retorno
:::
::: {.callout-tip}
## Estrutura do Lab
O Lab 3 é dividido em dois blocos complementares sobre o **mesmo pool de ativos**, para você sair com o pipeline end-to-end de séries financeiras.
- **Bloco 3.1**: Séries financeiras e GARCH. Preços → log-retornos → fatos estilizados → modelos GARCH → previsão de volatilidade.
- **Bloco 3.2**: Portfólios. Retorno/risco por ativo → matriz de covariância → fronteira eficiente → carteiras de mínima variância e máximo Sharpe.
:::
## Setup compartilhado
```{python}
import yfinance as yf
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import plotly.express as px
import plotly.graph_objects as go
from plotly.subplots import make_subplots

from arch import arch_model
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf
from scipy import stats
from scipy.optimize import minimize

import warnings
warnings.filterwarnings('ignore')

plt.rcParams.update({
    'figure.figsize': (12, 5),
    'axes.spines.top': False,
    'axes.spines.right': False,
    'font.size': 12,
})

INSPER_RED = '#E50505'
INSPER_TURQUESA = '#3ACC9F'
INSPER_AMARELO = '#FFCC00'
INSPER_ROXO = '#730D9F'
INSPER_GRAY = '#5B5B5B'
```
```{python}
# Pool de ativos compartilhado entre 3.1 e 3.2
ativos = ['PETR4.SA', 'VALE3.SA', 'ITUB4.SA', 'WEGE3.SA',
          'ABEV3.SA', 'RENT3.SA', 'BBAS3.SA', 'SUZB3.SA']
benchmark = '^BVSP'
nomes = {
    'PETR4.SA': 'Petrobras', 'VALE3.SA': 'Vale', 'ITUB4.SA': 'Itaú',
    'WEGE3.SA': 'WEG', 'ABEV3.SA': 'Ambev', 'RENT3.SA': 'Localiza',
    'BBAS3.SA': 'BB', 'SUZB3.SA': 'Suzano', '^BVSP': 'Ibovespa',
}
start_date = '2018-01-01'

todos = ativos + [benchmark]
precos = yf.download(todos, start=start_date, auto_adjust=False, progress=False)['Adj Close'].dropna()

bench_precos = precos[benchmark]
precos = precos[ativos]

retornos = np.log(precos / precos.shift(1)).dropna()
ret_bench = np.log(bench_precos / bench_precos.shift(1)).dropna()

print(f"Período: {precos.index.min().date()} a {precos.index.max().date()}")
print(f"Observações: {len(precos)} dias úteis")
precos.head()
```
# Bloco 3.1: Séries Financeiras e GARCH
## Parte 1: Preços e log-retornos
```{python}
precos_norm = (precos / precos.iloc[0]) * 100

fig = px.line(
    precos_norm, y=precos_norm.columns,
    title='Preços Normalizados (Base 100)',
    labels={'value': 'Índice', 'variable': 'Ativo'},
    template='plotly_white'
)
fig.update_layout(font_family='Inter', hovermode='x unified')
fig.show()
```
```{python}
desc = retornos.describe().T
desc['skewness'] = retornos.skew()
desc['kurtosis'] = retornos.kurtosis()
desc['jarque_bera_p'] = [stats.jarque_bera(retornos[col])[1] for col in retornos.columns]

desc[['mean', 'std', 'skewness', 'kurtosis', 'jarque_bera_p']].round(4)
```
::: {.callout-note}
## Interprete a Tabela
- **Curtose > 0**: caudas mais pesadas que a normal (esperado!)
- **Assimetria < 0**: cauda esquerda mais pesada (quedas mais extremas)
- **Jarque-Bera p < 0.05**: rejeita normalidade
:::
## Parte 2: Fatos estilizados
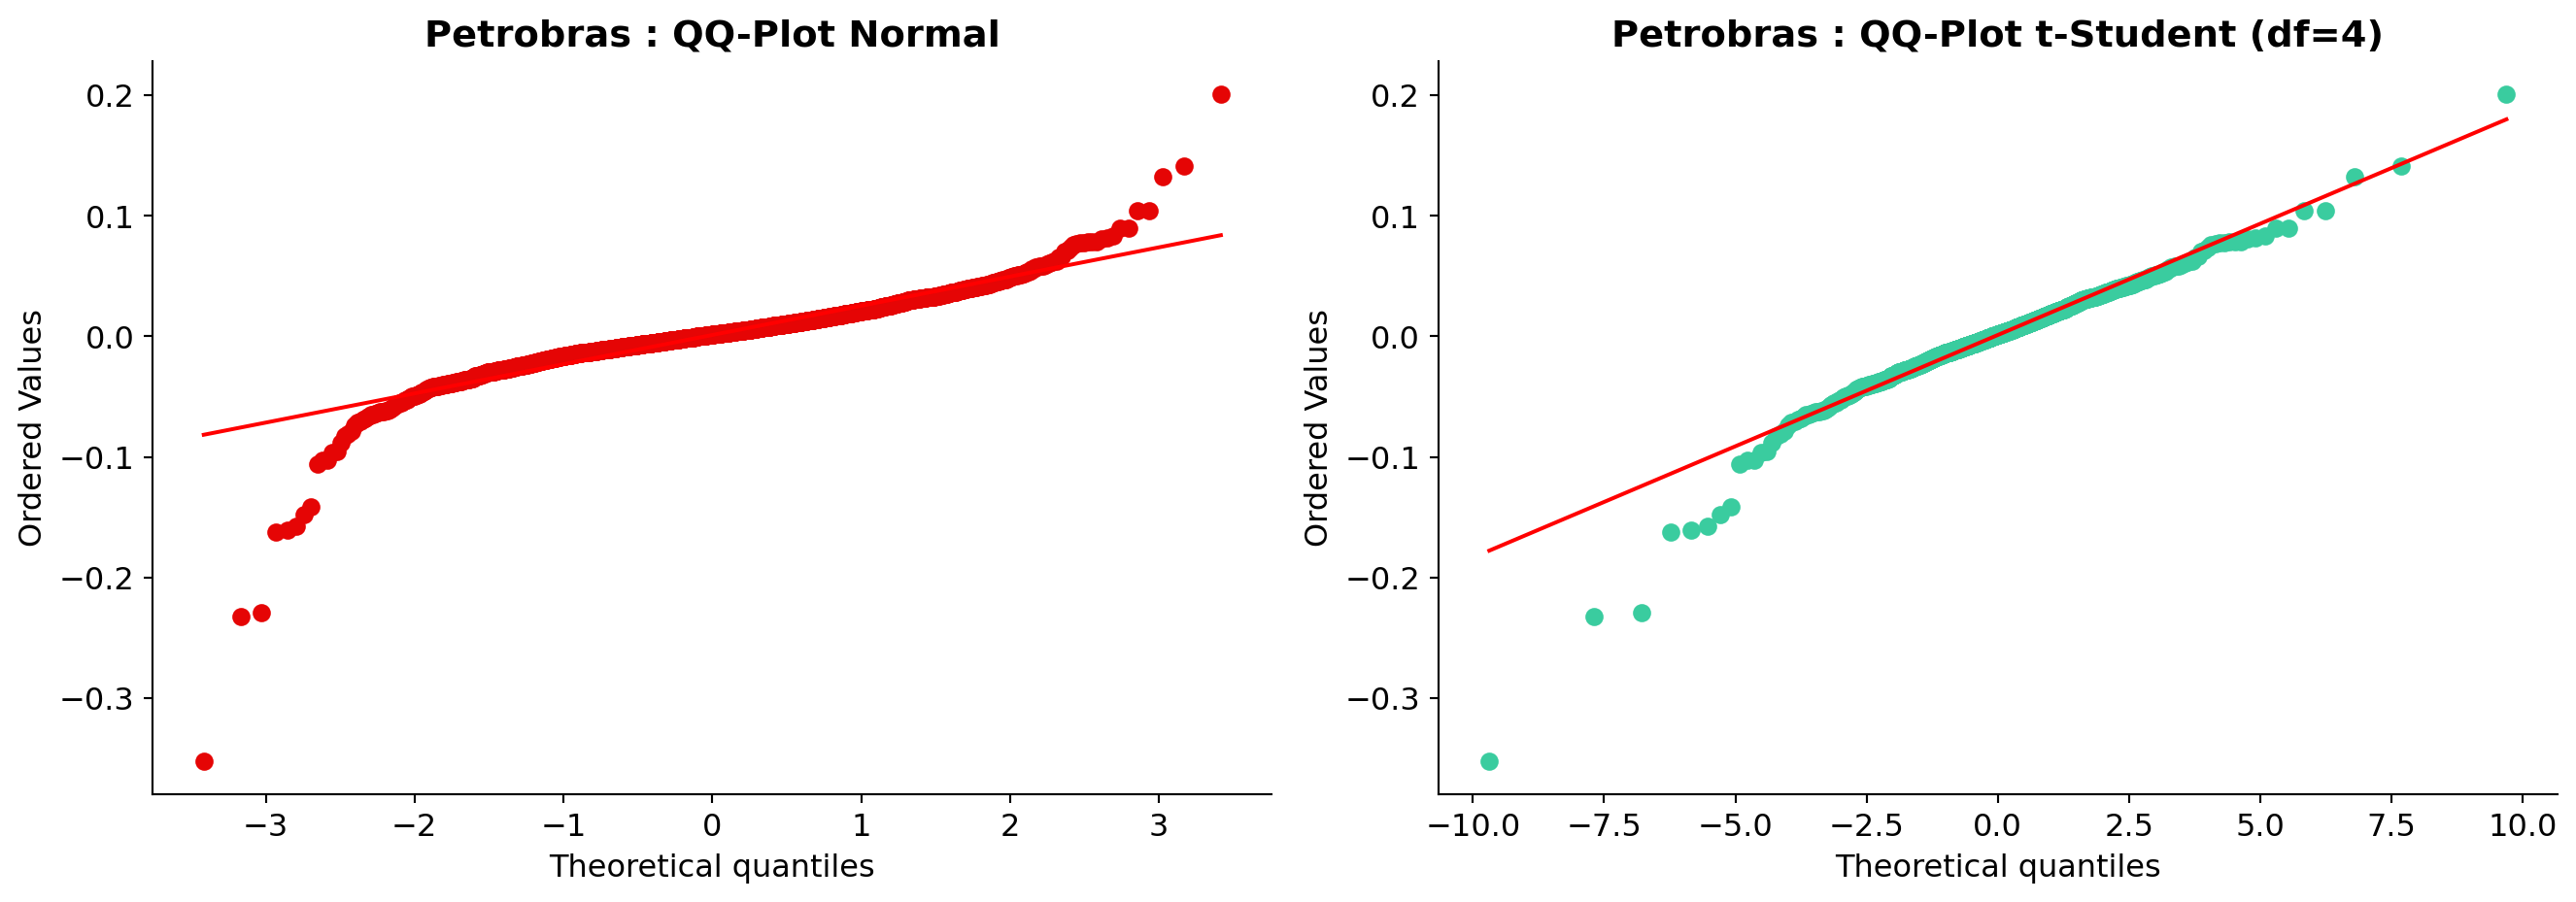
### Caudas pesadas
```{python}
ativo_foco = 'PETR4.SA'
ret = retornos[ativo_foco].values

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

stats.probplot(ret, dist="norm", plot=axes[0])
axes[0].set_title(f'{nomes[ativo_foco]} : QQ-Plot Normal', fontweight='bold')
axes[0].get_lines()[0].set_color(INSPER_RED)

stats.probplot(ret, dist="t", sparams=(4,), plot=axes[1])
axes[1].set_title(f'{nomes[ativo_foco]} : QQ-Plot t-Student (df=4)', fontweight='bold')
axes[1].get_lines()[0].set_color(INSPER_TURQUESA)

plt.tight_layout()
plt.show()
```
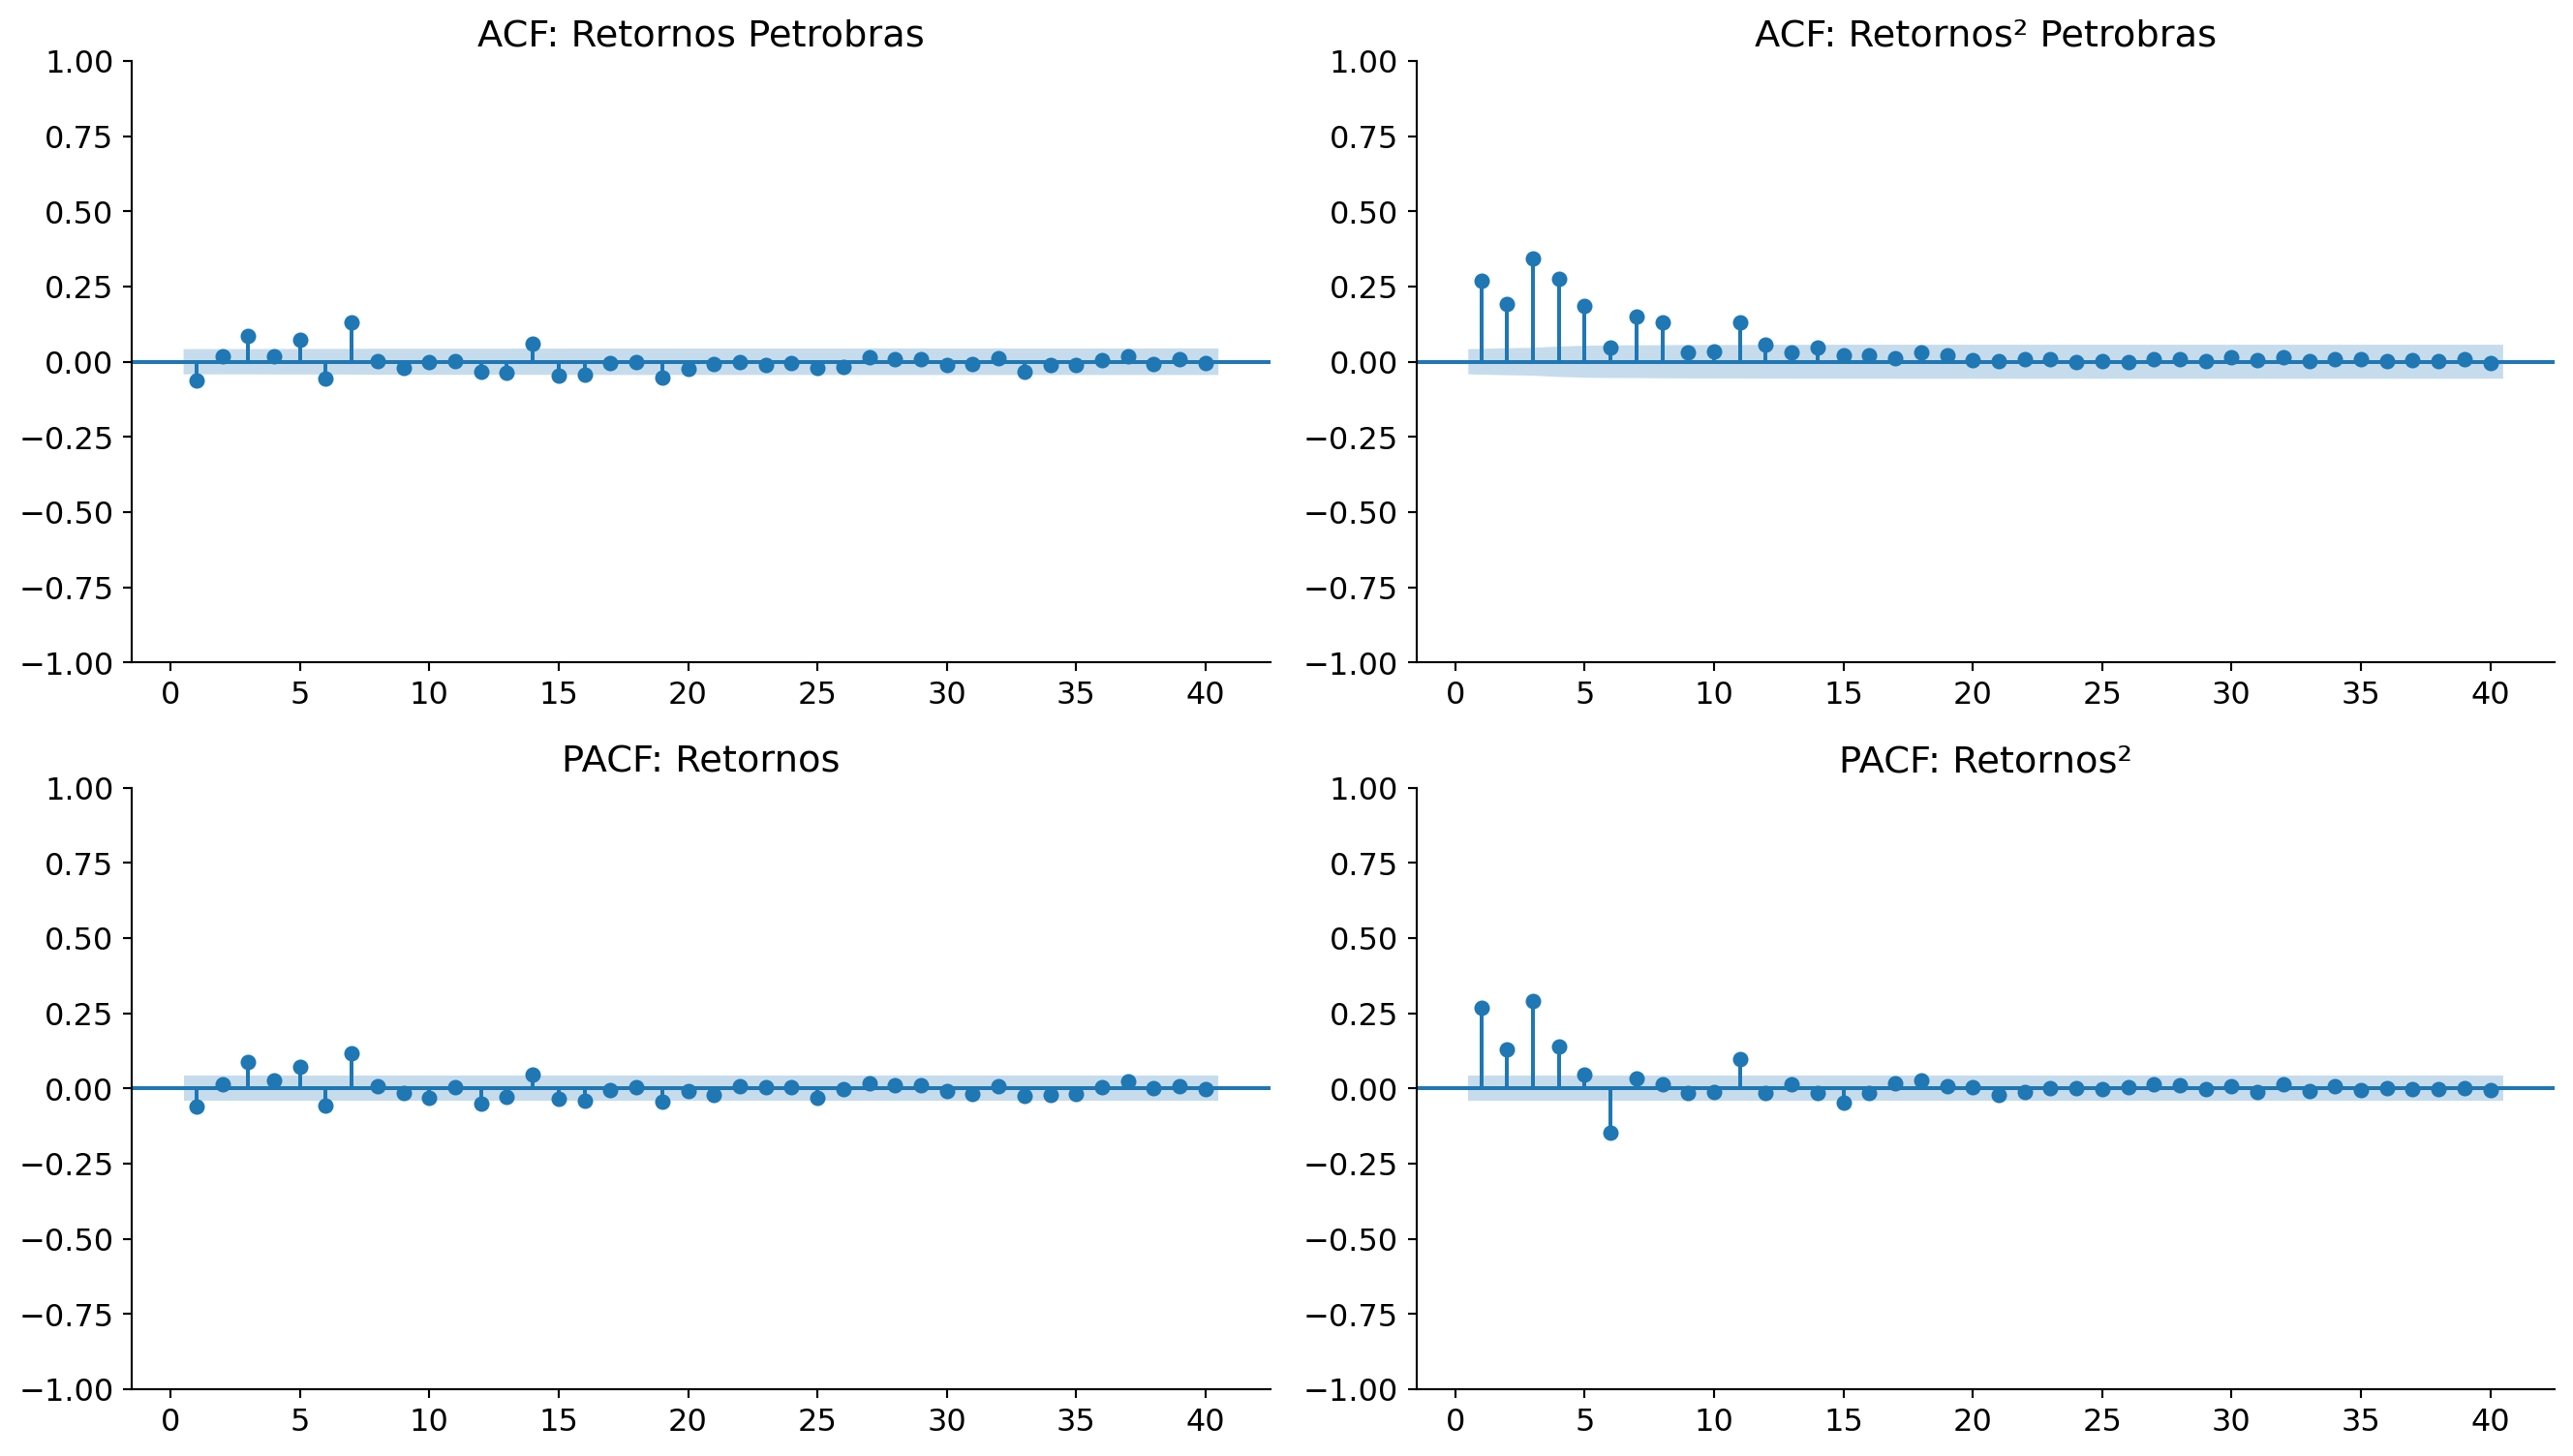
### Clusters de volatilidade
```{python}
fig, axes = plt.subplots(2, 2, figsize=(14, 8))

plot_acf(retornos[ativo_foco].dropna(), ax=axes[0,0], lags=40, zero=False,
         title=f'ACF: Retornos {nomes[ativo_foco]}')
plot_acf(retornos[ativo_foco].dropna()**2, ax=axes[0,1], lags=40, zero=False,
         title=f'ACF: Retornos² {nomes[ativo_foco]}')
plot_pacf(retornos[ativo_foco].dropna(), ax=axes[1,0], lags=40, zero=False,
          title='PACF: Retornos')
plot_pacf(retornos[ativo_foco].dropna()**2, ax=axes[1,1], lags=40, zero=False,
          title='PACF: Retornos²')

plt.tight_layout()
plt.show()
```
::: {.callout-caution collapse="true"}
## Exercício: Interpretação
1. **Os retornos têm autocorrelação significativa? E os retornos ao quadrado?** Os retornos simples geralmente não têm autocorrelação significativa (mercado eficiente). Mas os retornos ao quadrado têm autocorrelação forte e persistente: isso indica clusters de volatilidade.
2. **O que a ACF dos retornos ao quadrado está nos dizendo?** Que a **variância** (volatilidade) muda ao longo do tempo de forma previsível. Períodos de alta volatilidade tendem a ser seguidos por mais alta volatilidade.
3. **O QQ-Plot com distribuição t se ajusta melhor?** Sim: a t com graus de liberdade baixos (4-8) se ajusta melhor às caudas dos retornos financeiros.
:::
## Parte 3: Modelos GARCH
```{python}
ret_pct = retornos[ativo_foco] * 100  # `arch` trabalha em retornos percentuais

modelo_garch = arch_model(ret_pct, vol='Garch', p=1, q=1, dist='t')
resultado_garch = modelo_garch.fit(disp='off')
print(resultado_garch.summary())
```
```{python}
vol_condicional = resultado_garch.conditional_volatility / 100

fig = make_subplots(rows=2, cols=1, shared_xaxes=True,
                    subplot_titles=[f'Retornos: {nomes[ativo_foco]}',
                                    'Volatilidade Condicional (GARCH)'])
fig.add_trace(go.Scatter(x=retornos.index, y=retornos[ativo_foco],
                         mode='lines', line=dict(color=INSPER_GRAY, width=0.5),
                         name='Retornos'), row=1, col=1)
fig.add_trace(go.Scatter(x=retornos.index, y=vol_condicional,
                         mode='lines', line=dict(color=INSPER_RED, width=1),
                         name='Volatilidade GARCH'), row=2, col=1)
fig.update_layout(height=600, template='plotly_white', font_family='Inter',
                  showlegend=False)
fig.show()
```
### Comparando variantes
```{python}
modelos = {
    'GARCH(1,1)':     {'vol': 'Garch',  'p': 1, 'q': 1},
    'GARCH(2,1)':     {'vol': 'Garch',  'p': 2, 'q': 1},
    'EGARCH(1,1)':    {'vol': 'EGARCH', 'p': 1, 'q': 1},
    'GJR-GARCH(1,1)': {'vol': 'Garch',  'p': 1, 'o': 1, 'q': 1},
}

resultados = {}
for nome, params in modelos.items():
    try:
        fit = arch_model(ret_pct, dist='t', **params).fit(disp='off')
        resultados[nome] = {'AIC': fit.aic, 'BIC': fit.bic, 'Log-Lik': fit.loglikelihood}
    except Exception as e:
        print(f"Erro em {nome}: {e}")

pd.DataFrame(resultados).T.sort_values('AIC').round(2)
```
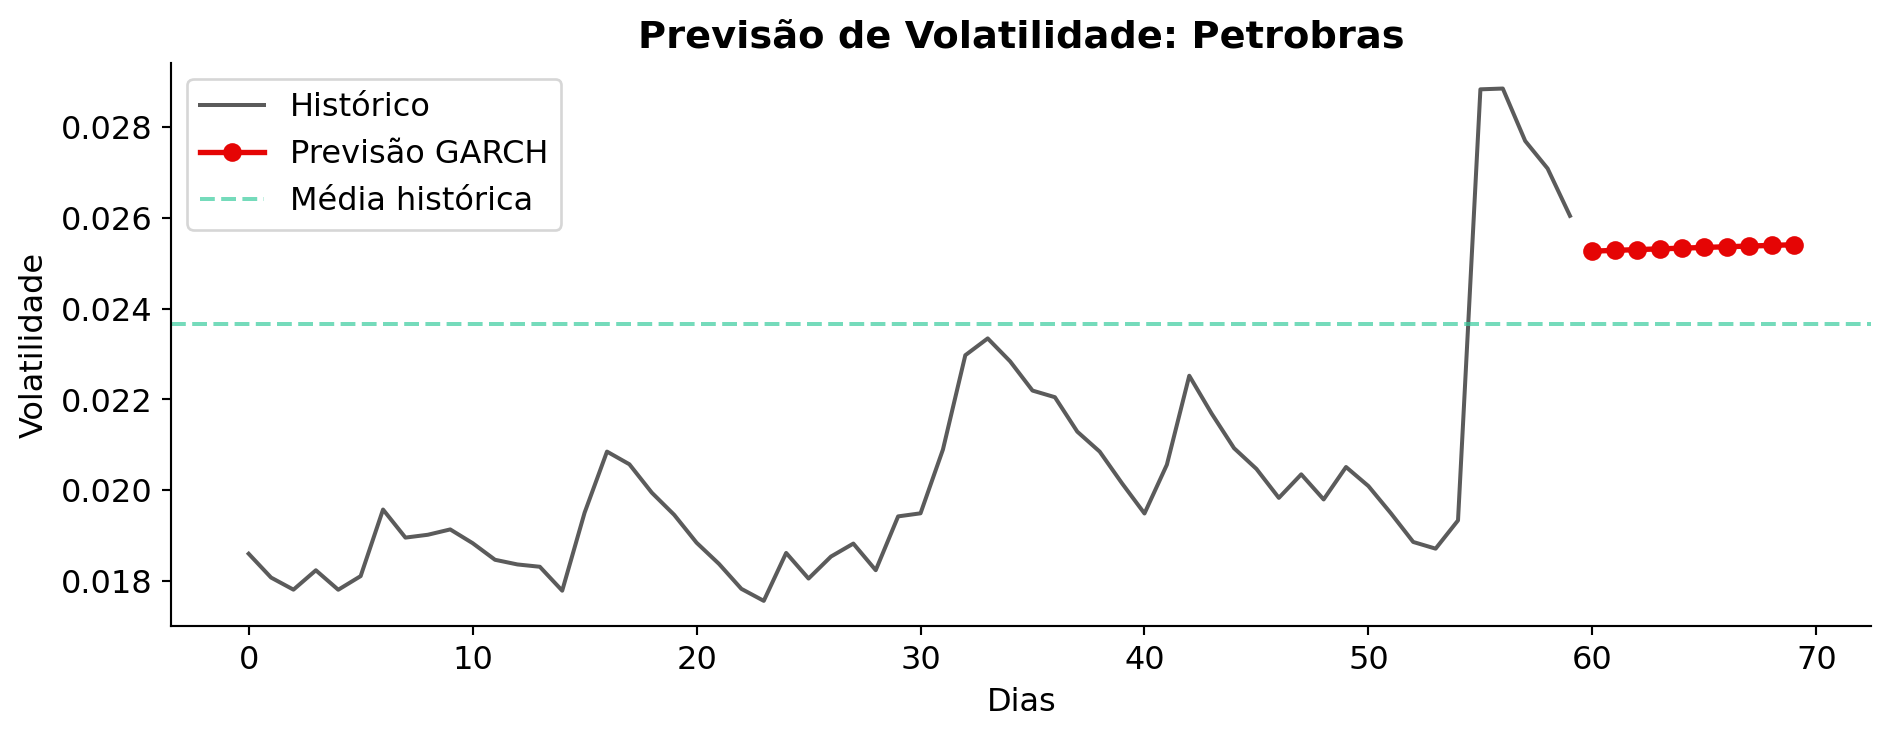
### Previsão de volatilidade
```{python}
h = 10
forecast = resultado_garch.forecast(horizon=h, reindex=False)
vol_futura = np.sqrt(forecast.variance.values[-1, :]) / 100

fig, ax = plt.subplots(figsize=(10, 4))
hist_vol = vol_condicional[-60:]
ax.plot(range(len(hist_vol)), hist_vol.values, color=INSPER_GRAY, label='Histórico')
ax.plot(range(len(hist_vol), len(hist_vol) + h), vol_futura,
        color=INSPER_RED, linewidth=2, marker='o', label='Previsão GARCH')
ax.axhline(y=vol_condicional.mean(), color=INSPER_TURQUESA,
           linestyle='--', label='Média histórica', alpha=0.7)
ax.set_title(f'Previsão de Volatilidade: {nomes[ativo_foco]}', fontweight='bold')
ax.set_xlabel('Dias'); ax.set_ylabel('Volatilidade'); ax.legend()
plt.tight_layout()
plt.show()
```
# Bloco 3.2: Portfólios
## Parte 4: Retorno, risco e correlação
```{python}
ret_anual = retornos.mean() * 252
risco_anual = retornos.std() * np.sqrt(252)

resumo = pd.DataFrame({
    'Retorno Anual (%)': ret_anual * 100,
    'Risco Anual (%)':   risco_anual * 100,
    'Sharpe':            ret_anual / risco_anual,
}).round(3)
resumo.sort_values('Sharpe', ascending=False)
```
```{python}
fig = px.scatter(
    resumo, x='Risco Anual (%)', y='Retorno Anual (%)',
    text=resumo.index.str.replace('.SA', ''),
    title='Retorno vs. Risco: Ativos Individuais',
    template='plotly_white'
)
fig.update_traces(textposition='top center', marker=dict(size=12, color=INSPER_RED))
fig.update_layout(font_family='Inter')
fig.show()
```
```{python}
corr = retornos.corr()
fig = px.imshow(
    corr, text_auto='.2f',
    color_continuous_scale=['#3ACC9F', '#FFFFFF', '#E50505'],
    title='Matriz de Correlação', template='plotly_white'
)
fig.update_layout(font_family='Inter')
fig.show()
```
## Parte 5: Fronteira eficiente
```{python}
n_ativos = len(ativos)
mu = ret_anual.values
sigma = (retornos.cov() * 252).values

def portfolio_stats(weights, mu, sigma):
    ret = weights @ mu
    risk = np.sqrt(weights @ sigma @ weights)
    return ret, risk

def neg_sharpe(weights, mu, sigma, rf=0.10):
    ret, risk = portfolio_stats(weights, mu, sigma)
    return -(ret - rf) / risk

def portfolio_variance(weights, sigma):
    return weights @ sigma @ weights

constraints = [{'type': 'eq', 'fun': lambda w: np.sum(w) - 1}]
bounds = [(0, 0.30)] * n_ativos

w0 = np.ones(n_ativos) / n_ativos
res_minvar = minimize(portfolio_variance, w0, args=(sigma,),
                      method='SLSQP', bounds=bounds, constraints=constraints)
res_sharpe = minimize(neg_sharpe, w0, args=(mu, sigma, 0.10),
                      method='SLSQP', bounds=bounds, constraints=constraints)

print("Portfólio Mínima Variância:")
for ativo, peso in zip(ativos, res_minvar.x):
    if peso > 0.01:
        print(f"  {ativo}: {peso:.1%}")

print("\nPortfólio Máximo Sharpe:")
for ativo, peso in zip(ativos, res_sharpe.x):
    if peso > 0.01:
        print(f"  {ativo}: {peso:.1%}")
```
```{python}
rf = 0.10

# Simulamos carteiras (Monte Carlo) sob a MESMA restricao da otimizacao:
# long-only e peso maximo de 30% por ativo. Assim a nuvem e os pontos otimos
# vivem no mesmo conjunto de carteiras possiveis.
rng = np.random.default_rng(42)
n_random = 5000
pesos_random = []
while len(pesos_random) < n_random:
    w = rng.dirichlet(np.ones(n_ativos), size=2000)
    w = w[(w <= 0.30).all(axis=1)]   # mantem so as que respeitam o teto de 30%
    pesos_random.extend(w)
pesos_random = np.array(pesos_random[:n_random])

ret_random = pesos_random @ mu
risk_random = np.sqrt(np.einsum('ij,jk,ik->i', pesos_random, sigma, pesos_random))
sharpe_random = (ret_random - rf) / risk_random

r_mv, s_mv = portfolio_stats(res_minvar.x, mu, sigma)
r_ms, s_ms = portfolio_stats(res_sharpe.x, mu, sigma)

fig = go.Figure()
fig.add_trace(go.Scatter(
    x=risk_random*100, y=ret_random*100, mode='markers',
    marker=dict(size=4, color=sharpe_random, colorscale='Viridis',
                colorbar=dict(title='Sharpe'), opacity=0.5),
    name='Carteiras simuladas', hoverinfo='skip'))
fig.add_trace(go.Scatter(x=[s_mv*100], y=[r_mv*100], mode='markers',
                         marker=dict(size=16, color=INSPER_TURQUESA, symbol='star',
                                     line=dict(color='black', width=1)),
                         name='Mín. Variância'))
fig.add_trace(go.Scatter(x=[s_ms*100], y=[r_ms*100], mode='markers',
                         marker=dict(size=16, color=INSPER_AMARELO, symbol='star',
                                     line=dict(color='black', width=1)),
                         name='Máx. Sharpe'))
fig.add_trace(go.Scatter(x=risco_anual.values*100, y=ret_anual.values*100,
                         mode='markers+text',
                         text=[a.replace('.SA', '') for a in ativos],
                         textposition='top center',
                         marker=dict(size=10, color=INSPER_ROXO),
                         name='Ativos individuais'))
fig.update_layout(title='Simulação de carteiras (Monte Carlo)',
                  xaxis_title='Risco Anual (%)', yaxis_title='Retorno Anual (%)',
                  template='plotly_white', font_family='Inter',
                  legend=dict(yanchor='top', y=0.99, xanchor='left', x=0.01))
fig.show()
```
::: {.callout-note}
## Onde está a fronteira eficiente?
A **fronteira eficiente** é a borda superior-esquerda da nuvem: para cada nível de risco, a carteira de maior retorno possível. Aqui ela aparece como o próprio contorno da nuvem (note como as carteiras de Sharpe mais alto, em amarelo, se alinham nessa borda), sem precisar desenhar uma curva separada.
Optamos por não traçar uma curva analítica por cima da nuvem. Quando se faz isso é fácil cometer uma inconsistência: a curva costuma ser calculada com a restrição de peso máximo de 30% por ativo, enquanto a nuvem é sorteada sem esse teto. Como são conjuntos de carteiras diferentes, alguns pontos sorteados acabam "fora" da curva. Aqui sorteamos a nuvem sob a mesma restrição usada na otimização (long-only, teto de 30%), então as duas estrelas (mínima variância e máximo Sharpe) caem naturalmente na borda da nuvem.
:::
### Pesos das carteiras ótimas
```{python}
labels = [a.replace('.SA', '') for a in ativos]

fig = make_subplots(rows=1, cols=2, shared_yaxes=True,
                    subplot_titles=['Mínima Variância', 'Máximo Sharpe'])
fig.add_trace(go.Bar(x=labels, y=res_minvar.x*100,
                     marker_color=INSPER_TURQUESA, text=[f'{p:.0%}' for p in res_minvar.x],
                     textposition='outside'), row=1, col=1)
fig.add_trace(go.Bar(x=labels, y=res_sharpe.x*100,
                     marker_color=INSPER_AMARELO, text=[f'{p:.0%}' for p in res_sharpe.x],
                     textposition='outside'), row=1, col=2)
fig.update_yaxes(title_text='Peso (%)', row=1, col=1)
fig.update_layout(title='Pesos das carteiras ótimas (teto de 30% por ativo)',
                  template='plotly_white', font_family='Inter', showlegend=False)
fig.show()
```
## Fecho
Você passou pelo pipeline completo: preços, log-retornos, fatos estilizados, GARCH, previsão de volatilidade e construção das carteiras de mínima variância e máximo Sharpe sob restrições realistas.
Para a versão oficial do laboratório (fundos imobiliários, fronteira por Monte Carlo, VaR via t de Student e CAPM) veja o [Lab 3 oficial](lab03-financeiras.qmd). Para montar e comparar carteiras de forma interativa, use o [app Monte sua Carteira](app-carteira.qmd).