Código
library(fpp3)
library(rugarch)
library(yfR)
library(dplyr)
library(tidyr)
library(purrr)
library(tibble)
library(ggplot2)
library(patchwork)
library(timetk)
library(broom)
library(scales)
library(forcats)Mesma trilha do lab oficial, em R: fatos estilizados, GARCH, fronteira, VaR e CAPM
yfRrugarch) e portfólios pela fronteira eficienteEste é o espelho em R do laboratório, fiel ao script de referência. A versão oficial em Python está em Lab 3 oficial, e há ainda uma versão alternativa com blue-chips e fronteira por otimização. Os três cobrem o mesmo pipeline: escolha a linguagem com que você se sente mais à vontade.
O pool são quatro FIIs que o monitor já teve na carteira (HGRE11, BTLG11, HGRU11, VGIR11). A pergunta de negócio é honesta: foi um péssimo investimento ou apenas ruim? FIIs costumam ter beta baixo contra o Ibovespa, então a parte de CAPM rende boa discussão.
library(fpp3)
library(rugarch)
library(yfR)
library(dplyr)
library(tidyr)
library(purrr)
library(tibble)
library(ggplot2)
library(patchwork)
library(timetk)
library(broom)
library(scales)
library(forcats)start_date <- "2018-01-01"
# Fundos imobiliários que o monitor já teve na carteira.
ativos <- c("HGRE11.SA", "BTLG11.SA", "HGRU11.SA", "VGIR11.SA")Trabalhamos tanto com os dados em formato de tibble quanto de tsibble.
da <- yfR::yf_get(
  ativos,
  first_date = start_date,
  type_return = "log",
  freq_data = "daily",
  do_complete_data = TRUE
)

da_tsibble <- da |>
  as_tsibble(key = ticker, index = ref_date, regular = FALSE)

# Data mínima comum a todas as séries (alguns FIIs listaram depois de 2018)
data_corte <- da |>
  dplyr::group_by(ticker) |>
  dplyr::filter(ref_date == min(ref_date)) |>
  dplyr::ungroup() |>
  with(max(ref_date))

da_train <- da |>
  dplyr::filter(ref_date > data_corte)

data_corte
[1] "2018-07-31"da_tsibble |>
autoplot(price_close, colour = "black") +
facet_wrap(~ticker, scales = "free_y", ncol = 1) +
labs(x = NULL, y = "Preço de fechamento")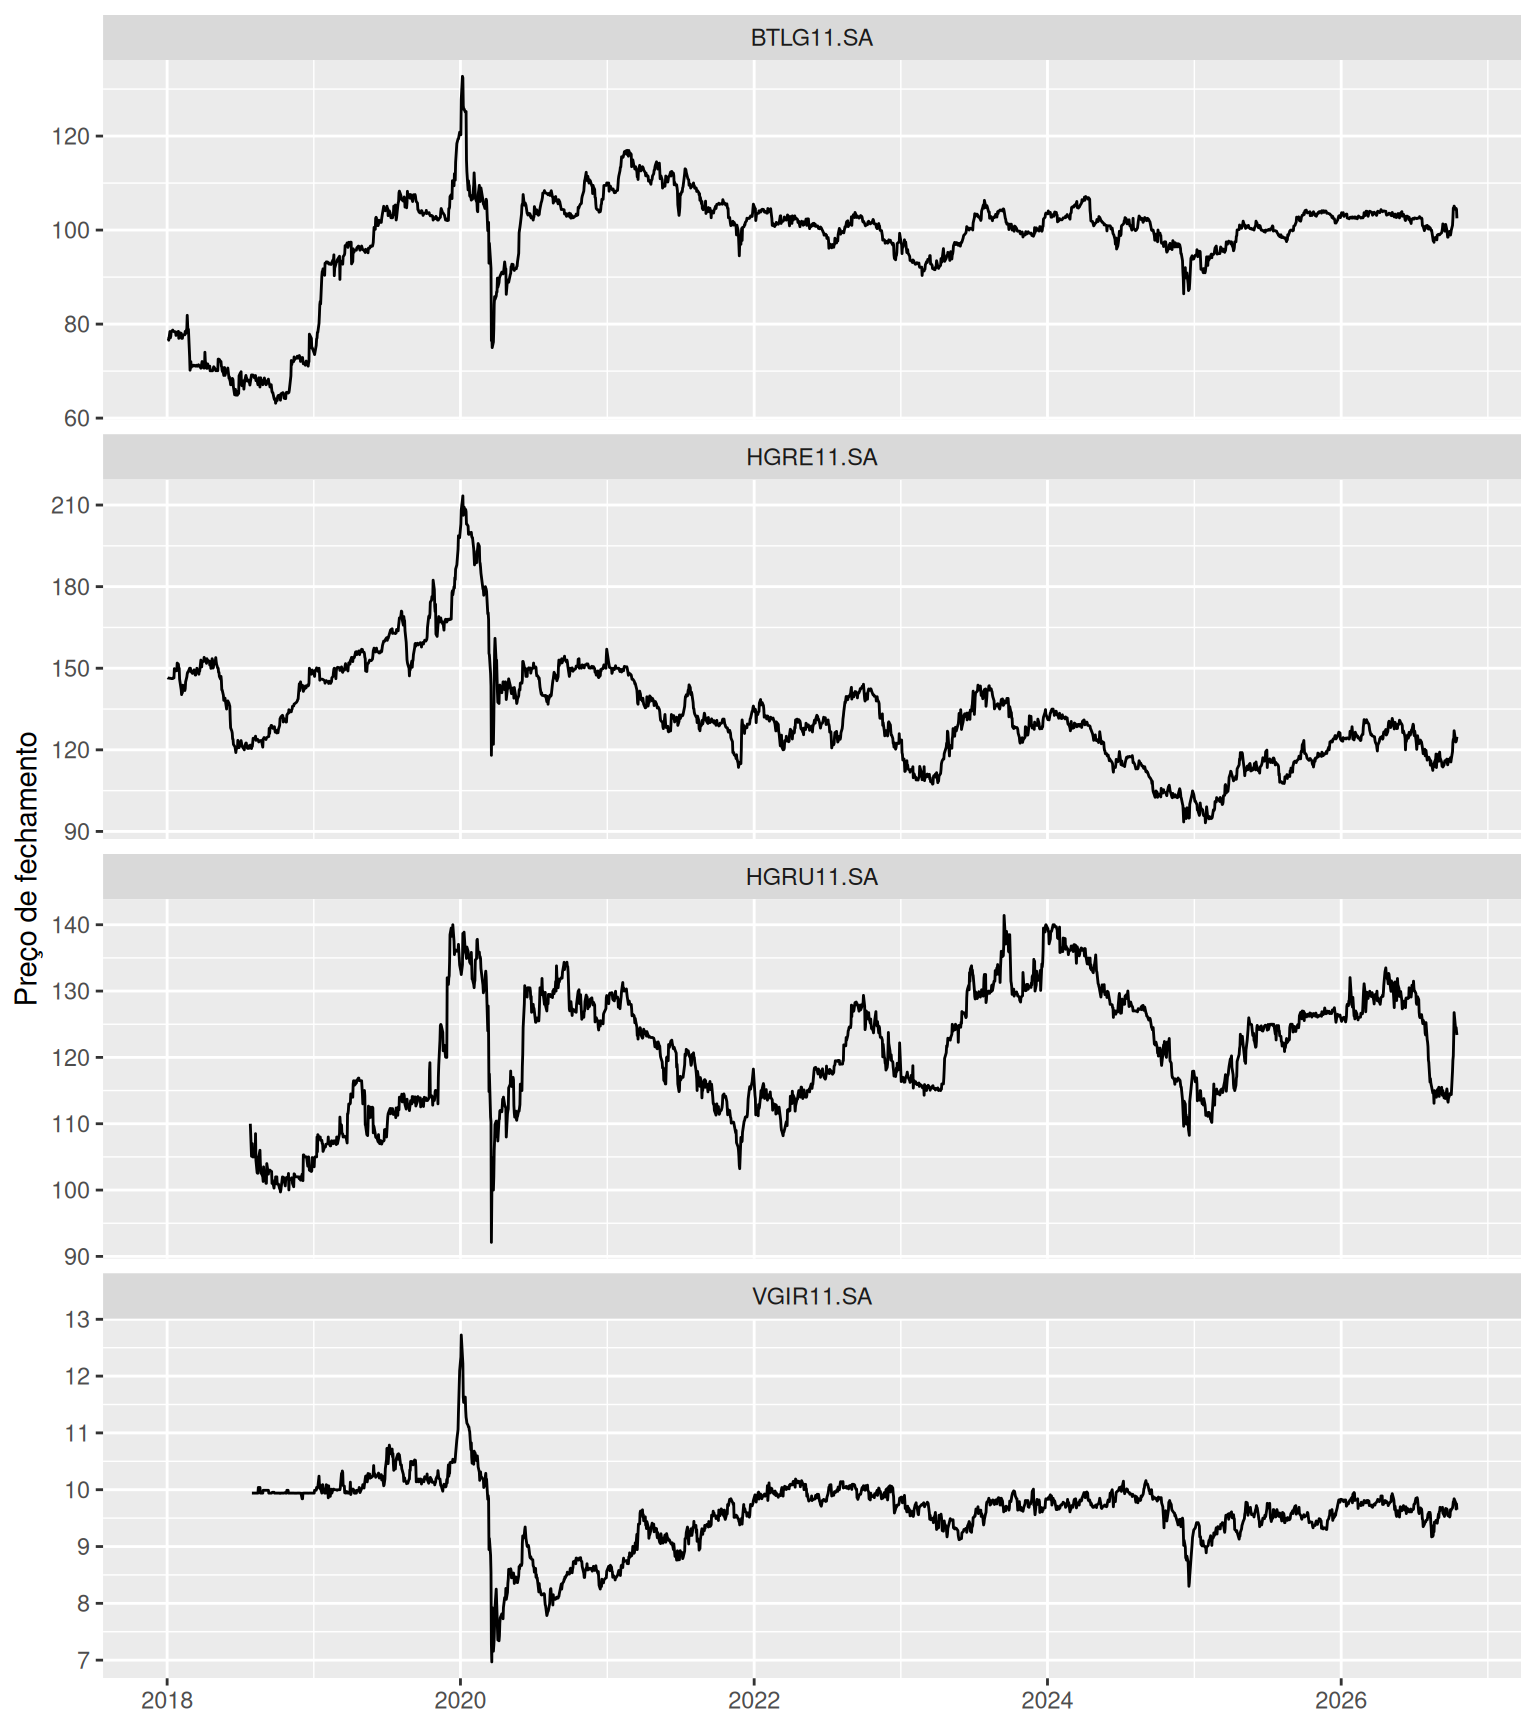
da_tsibble |>
  autoplot(ret_adjusted_prices, colour = "black") +
  facet_wrap(~ticker, scales = "free_y", ncol = 1) +
  labs(x = NULL, y = "Log-retorno")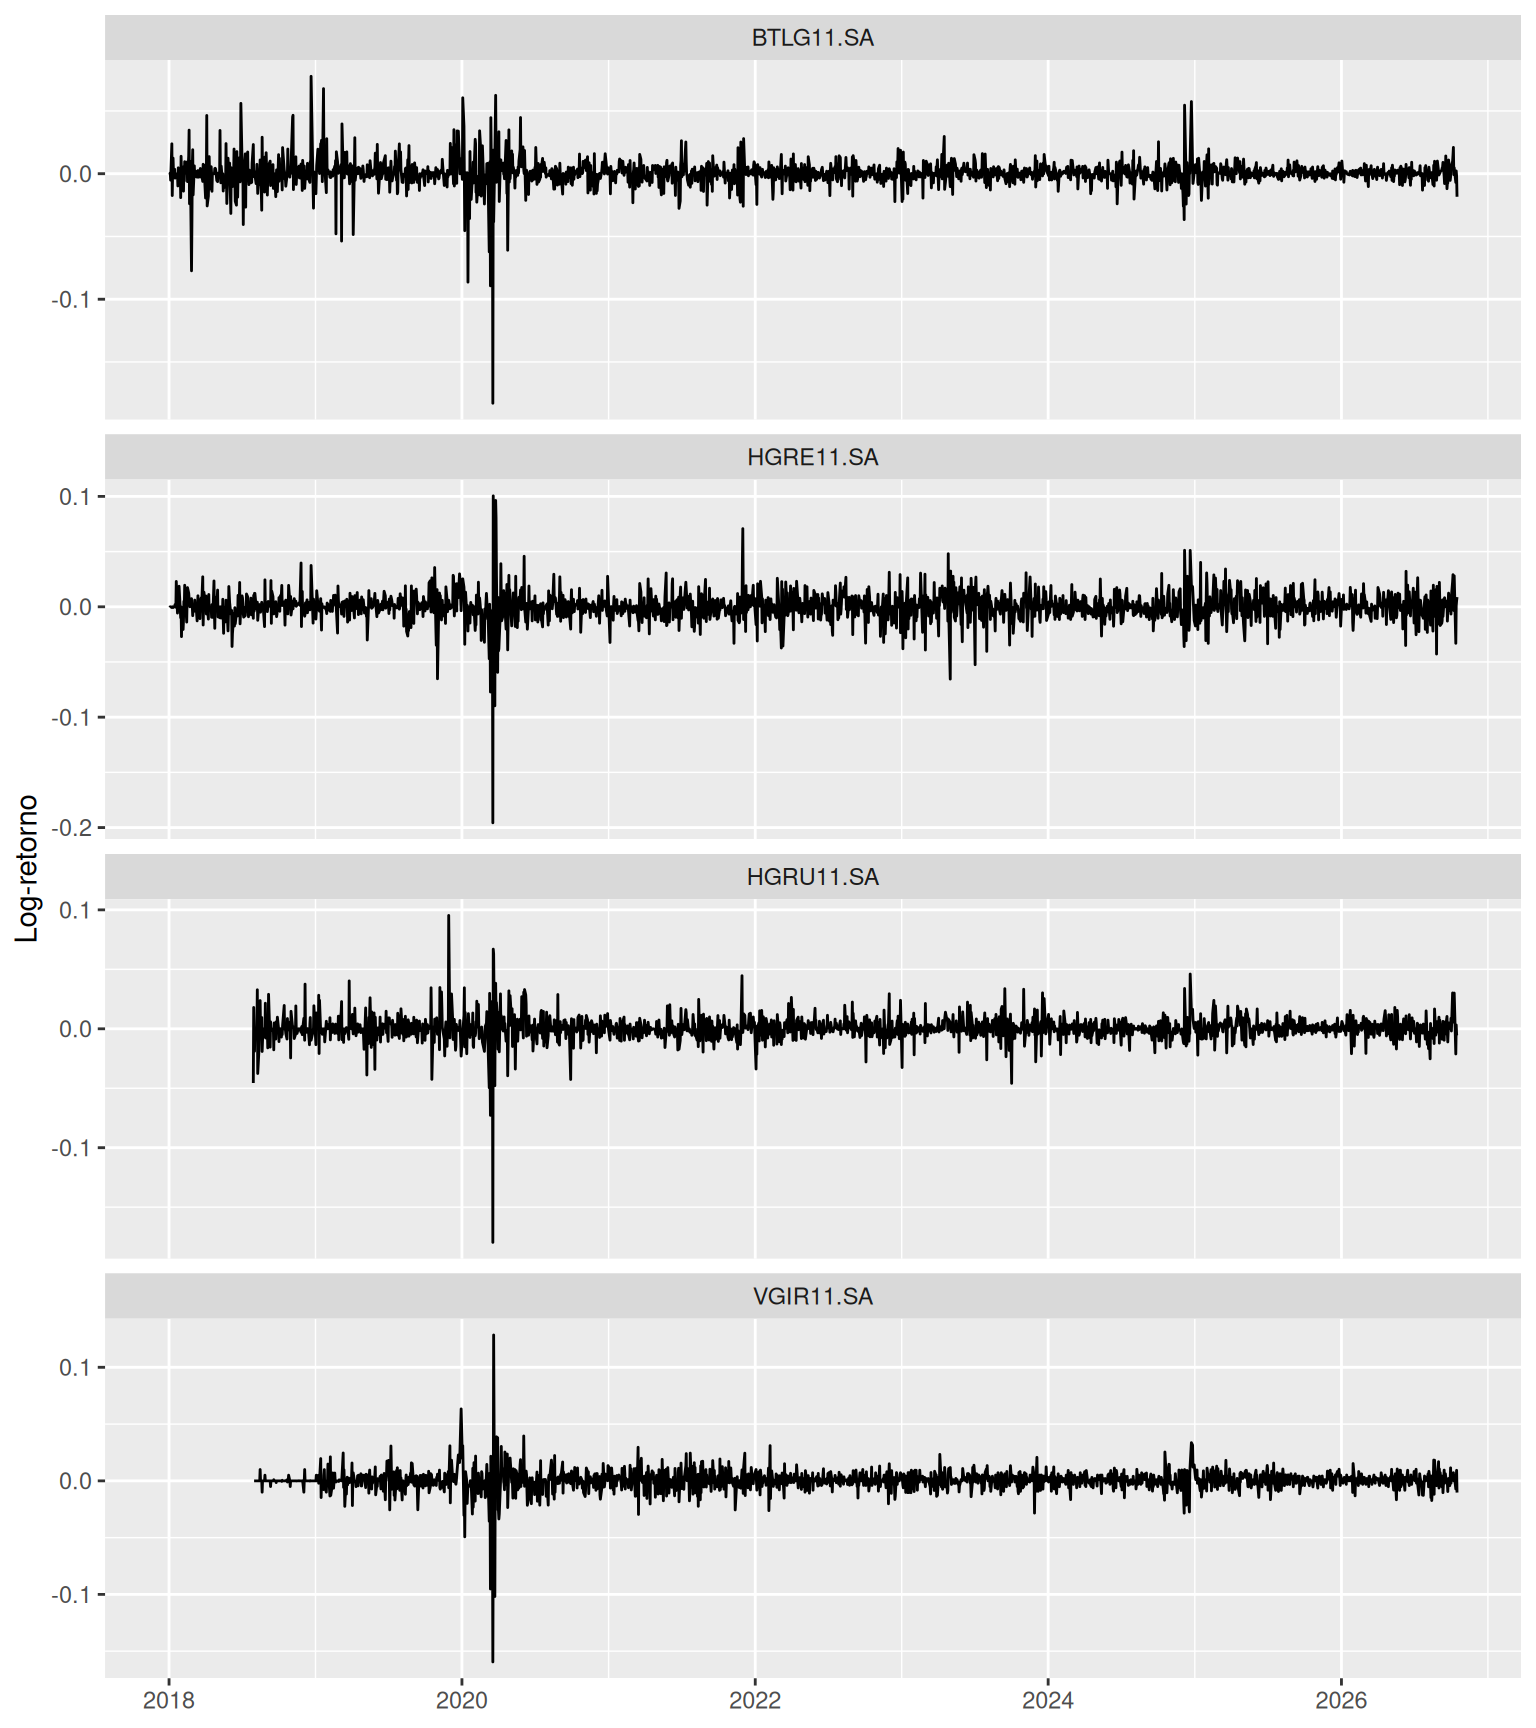
ACF e PACF dos retornos e dos retornos ao quadrado, mais a checagem de normalidade.
da_tsibble |>
  ACF(ret_adjusted_prices) |>
  autoplot() +
  labs(title = "ACF dos retornos")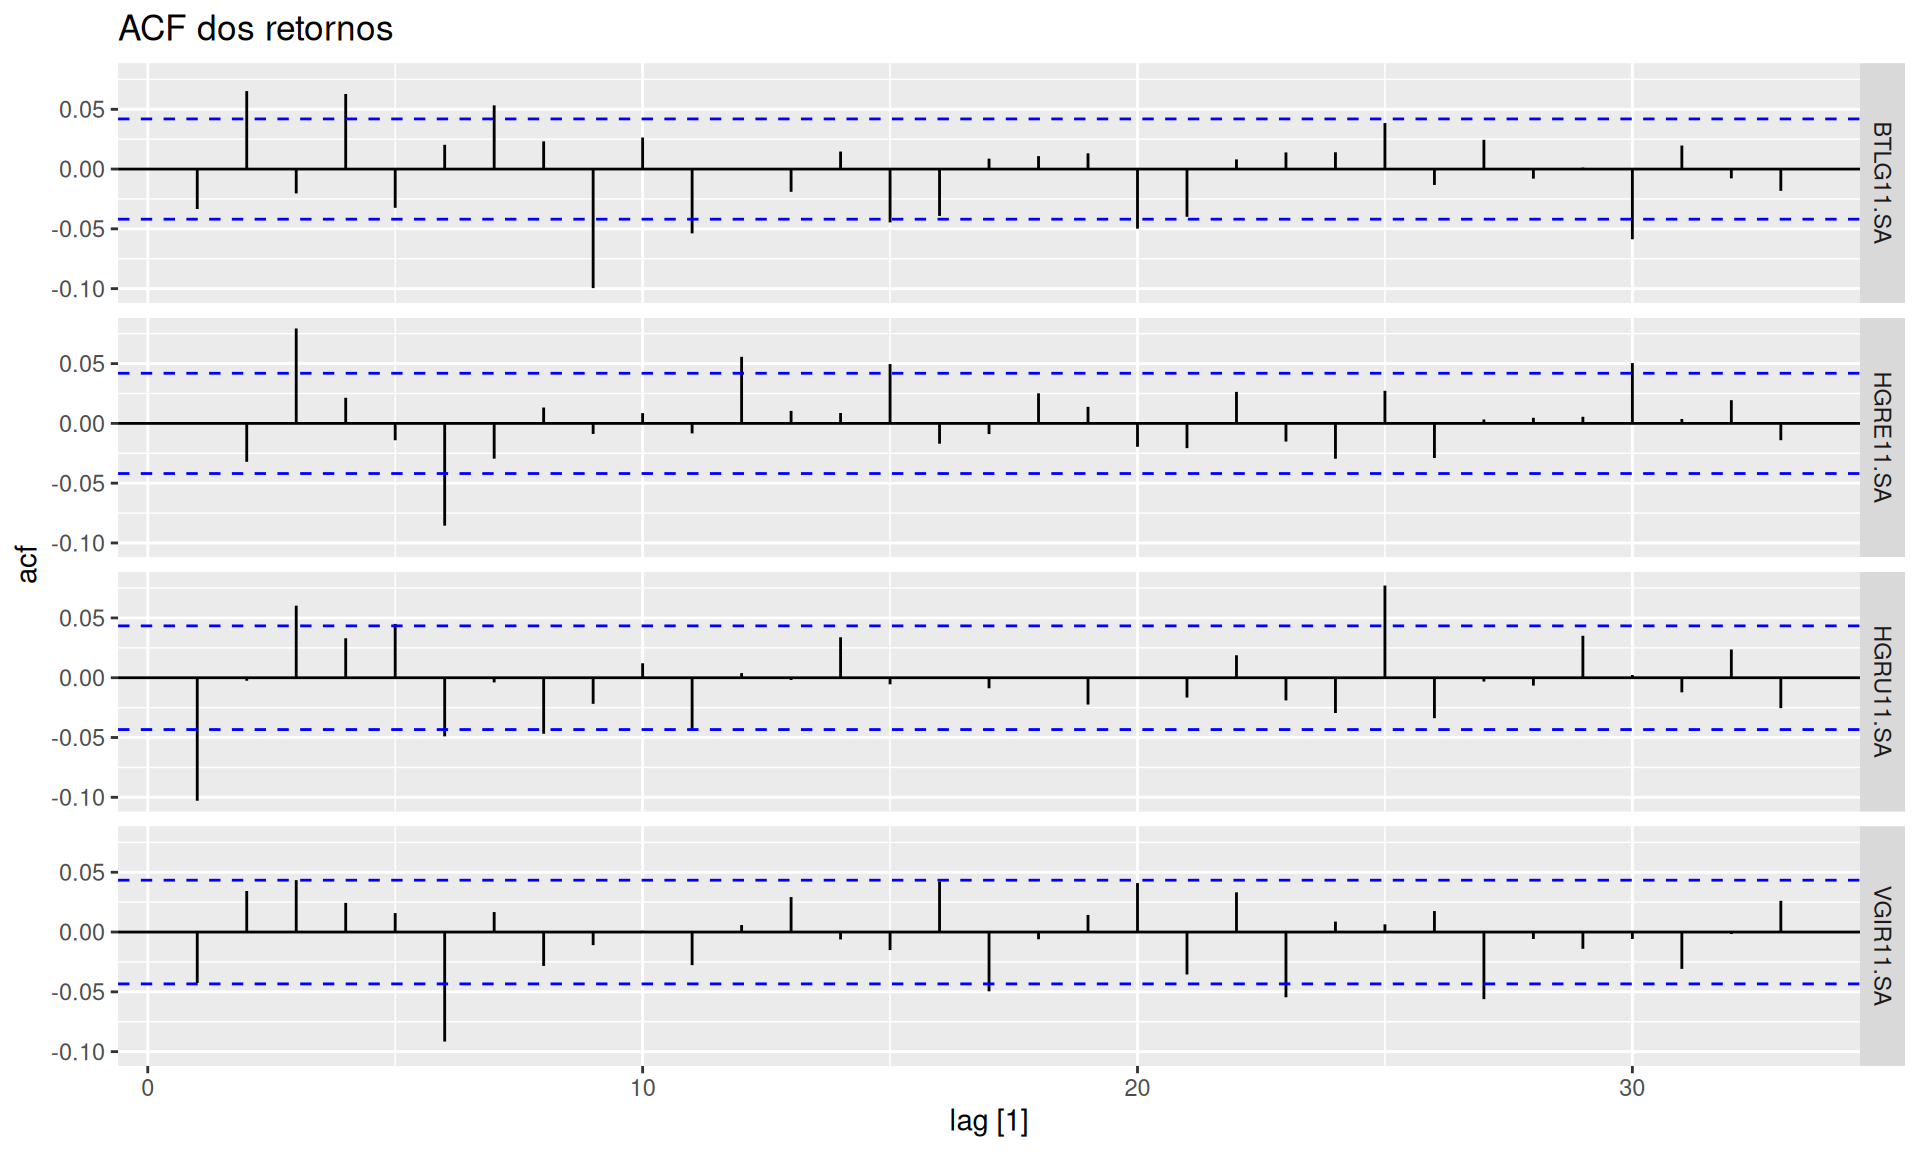
da_tsibble |>
  dplyr::mutate(ret2 = ret_adjusted_prices^2) |>
  ACF(ret2) |>
  autoplot() +
  labs(title = "ACF dos retornos ao quadrado")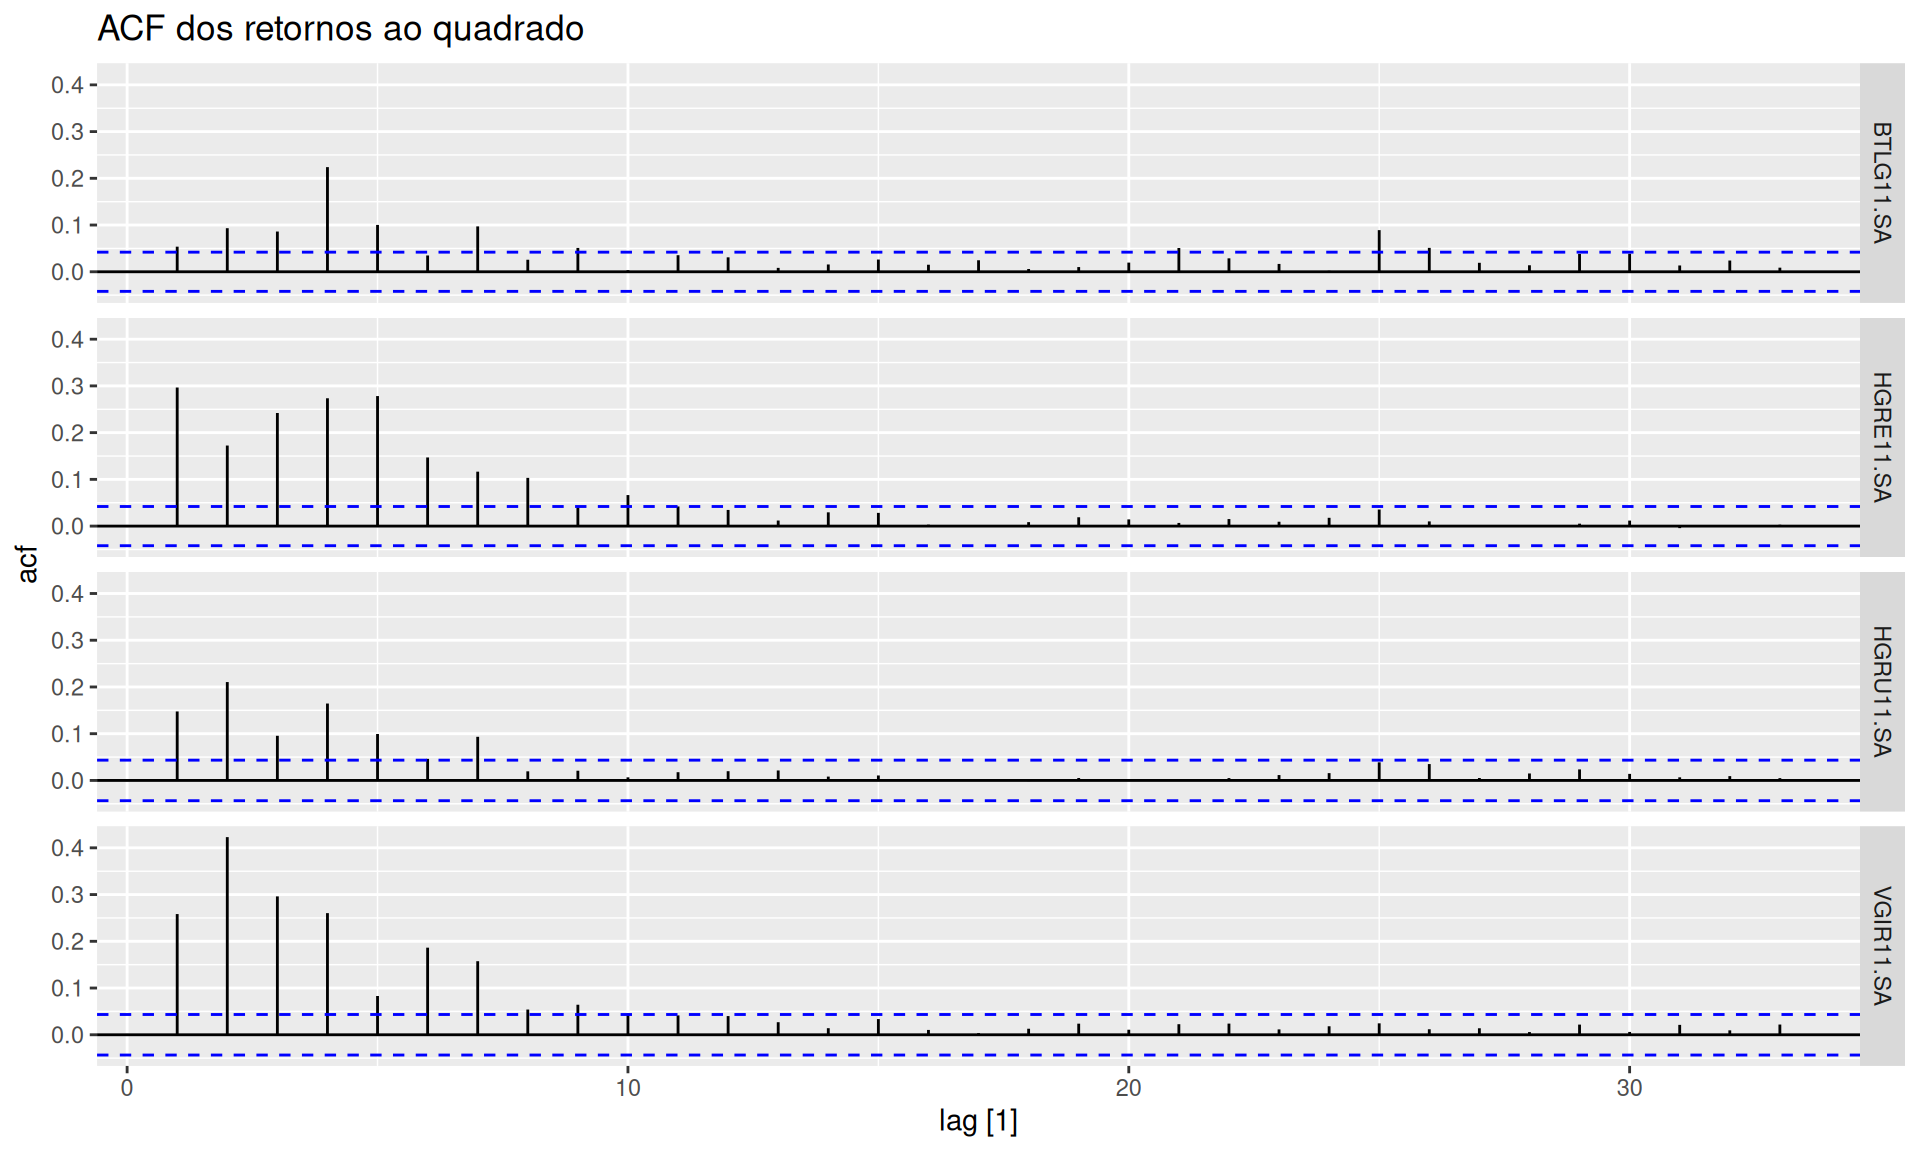
da_tsibble |>
  dplyr::mutate(ret2 = ret_adjusted_prices^2) |>
  PACF(ret2) |>
  autoplot() +
  labs(title = "PACF dos retornos ao quadrado")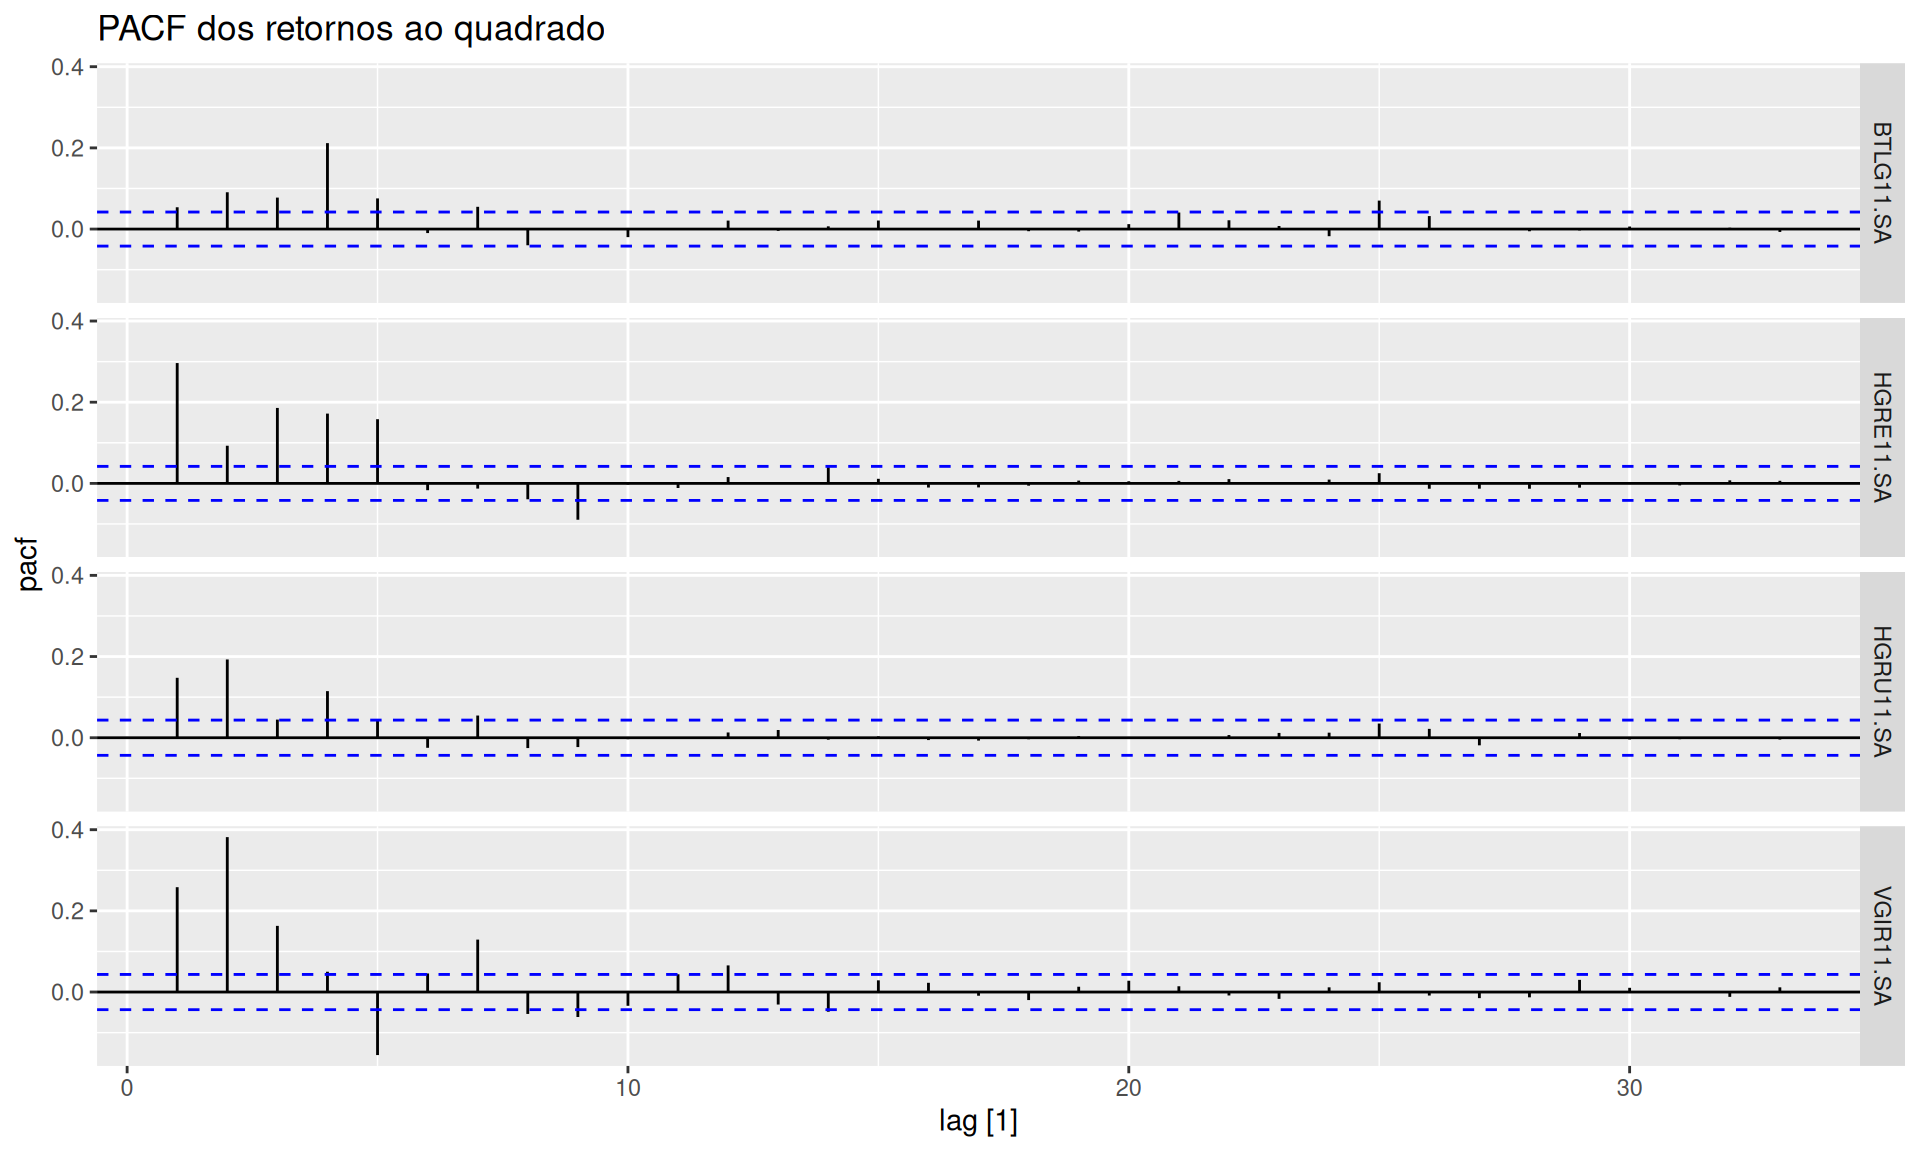
da_train |>
  ggplot(aes(x = ret_adjusted_prices)) +
  geom_histogram(bins = 90) +
  facet_wrap(~ticker, ncol = 2) +
  labs(x = "Log-retorno", y = NULL, title = "Distribuição dos retornos")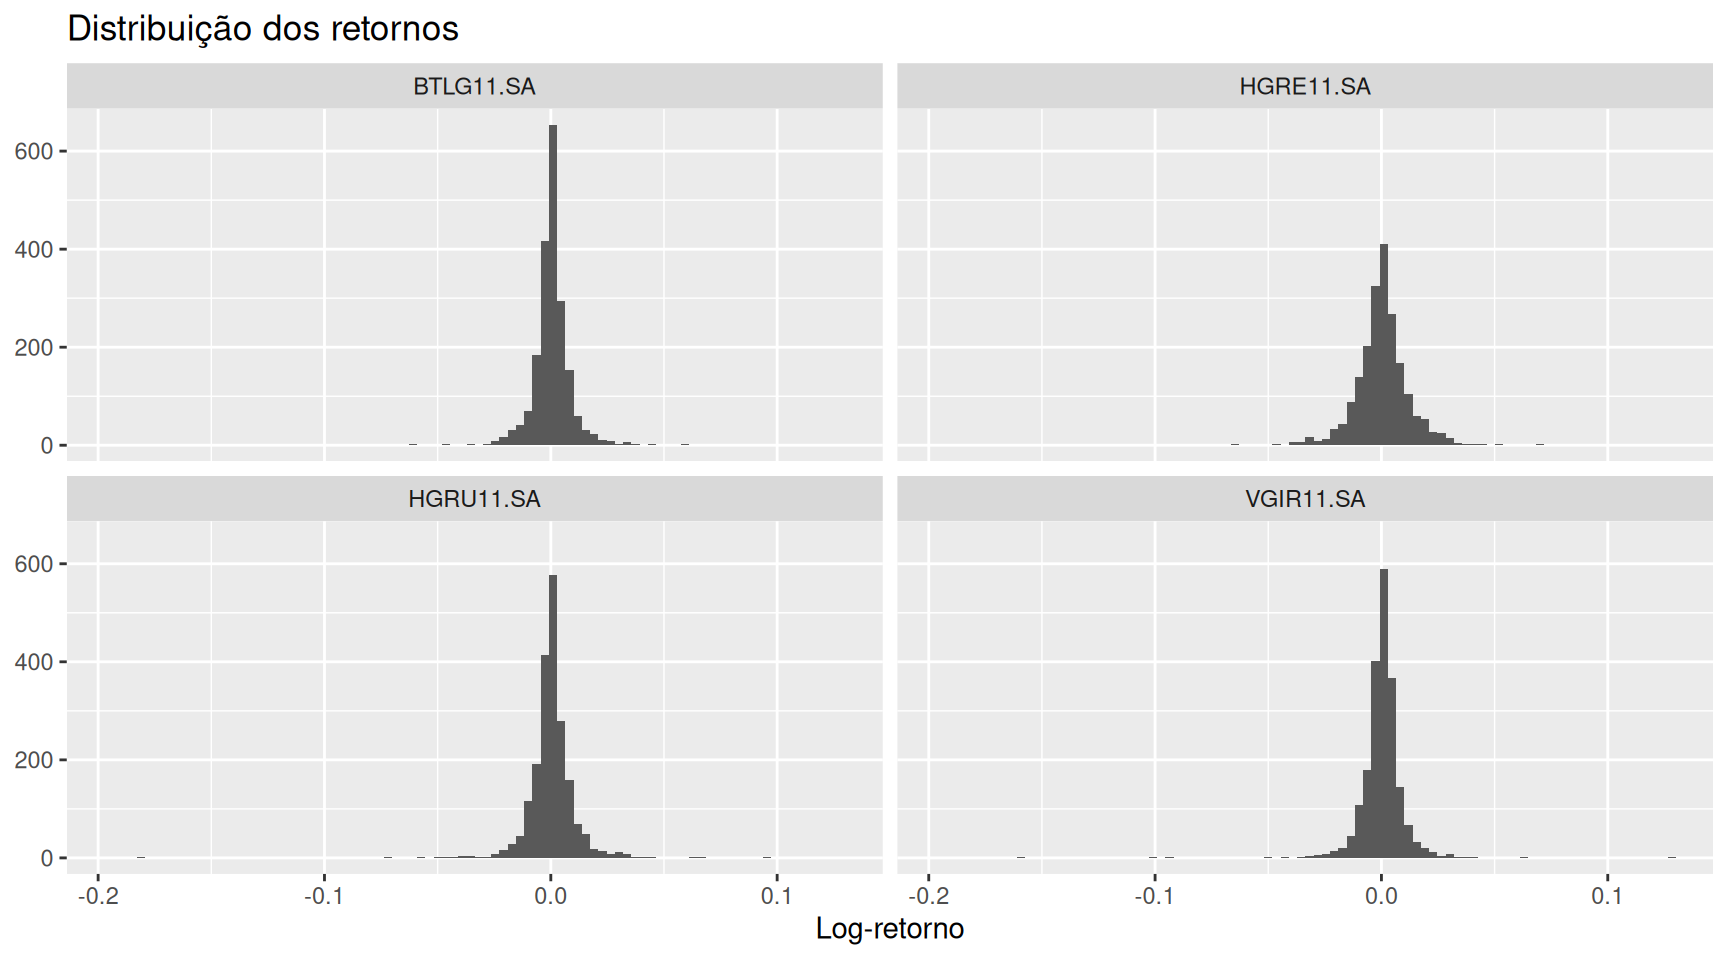
QQ-plot contra a normal e contra a t de Student (3 graus de liberdade).
da_train |>
  group_by(ticker) |>
  summarise(
    gg = list(
      ggplot(pick(everything()), aes(sample = ret_adjusted_prices)) +
        geom_qq() +
        geom_qq_line() +
        labs(title = cur_group()$ticker, x = NULL, y = NULL)
    )
  ) |>
  dplyr::pull(gg) |>
  patchwork::wrap_plots() +
  patchwork::plot_annotation(title = "QQ-plot vs. Normal")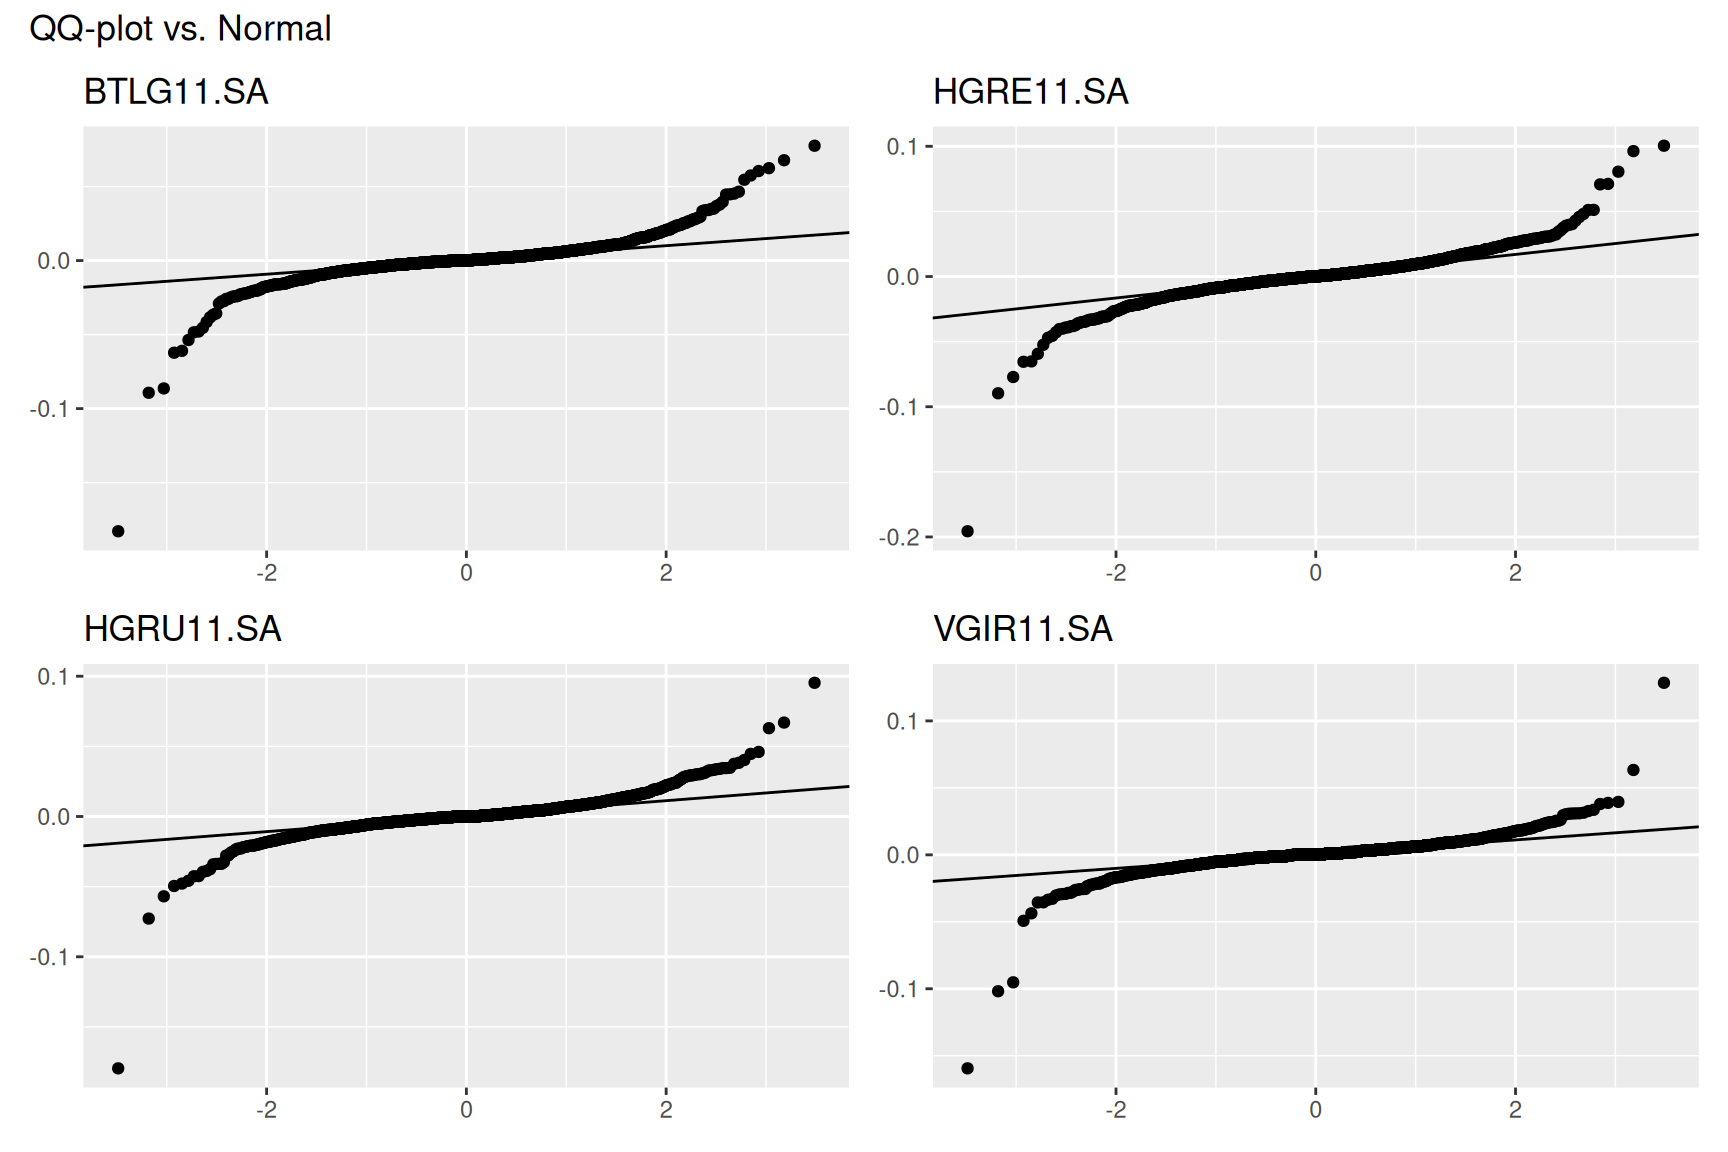
da_train |>
  group_by(ticker) |>
  summarise(
    gg = list(
      ggplot(pick(everything()), aes(sample = ret_adjusted_prices)) +
        geom_qq(distribution = qt, dparams = list(df = 3)) +
        geom_qq_line(distribution = qt, dparams = list(df = 3)) +
        labs(title = cur_group()$ticker, x = NULL, y = NULL)
    )
  ) |>
  dplyr::pull(gg) |>
  patchwork::wrap_plots() +
  patchwork::plot_annotation(title = "QQ-plot vs. t de Student (df = 3)")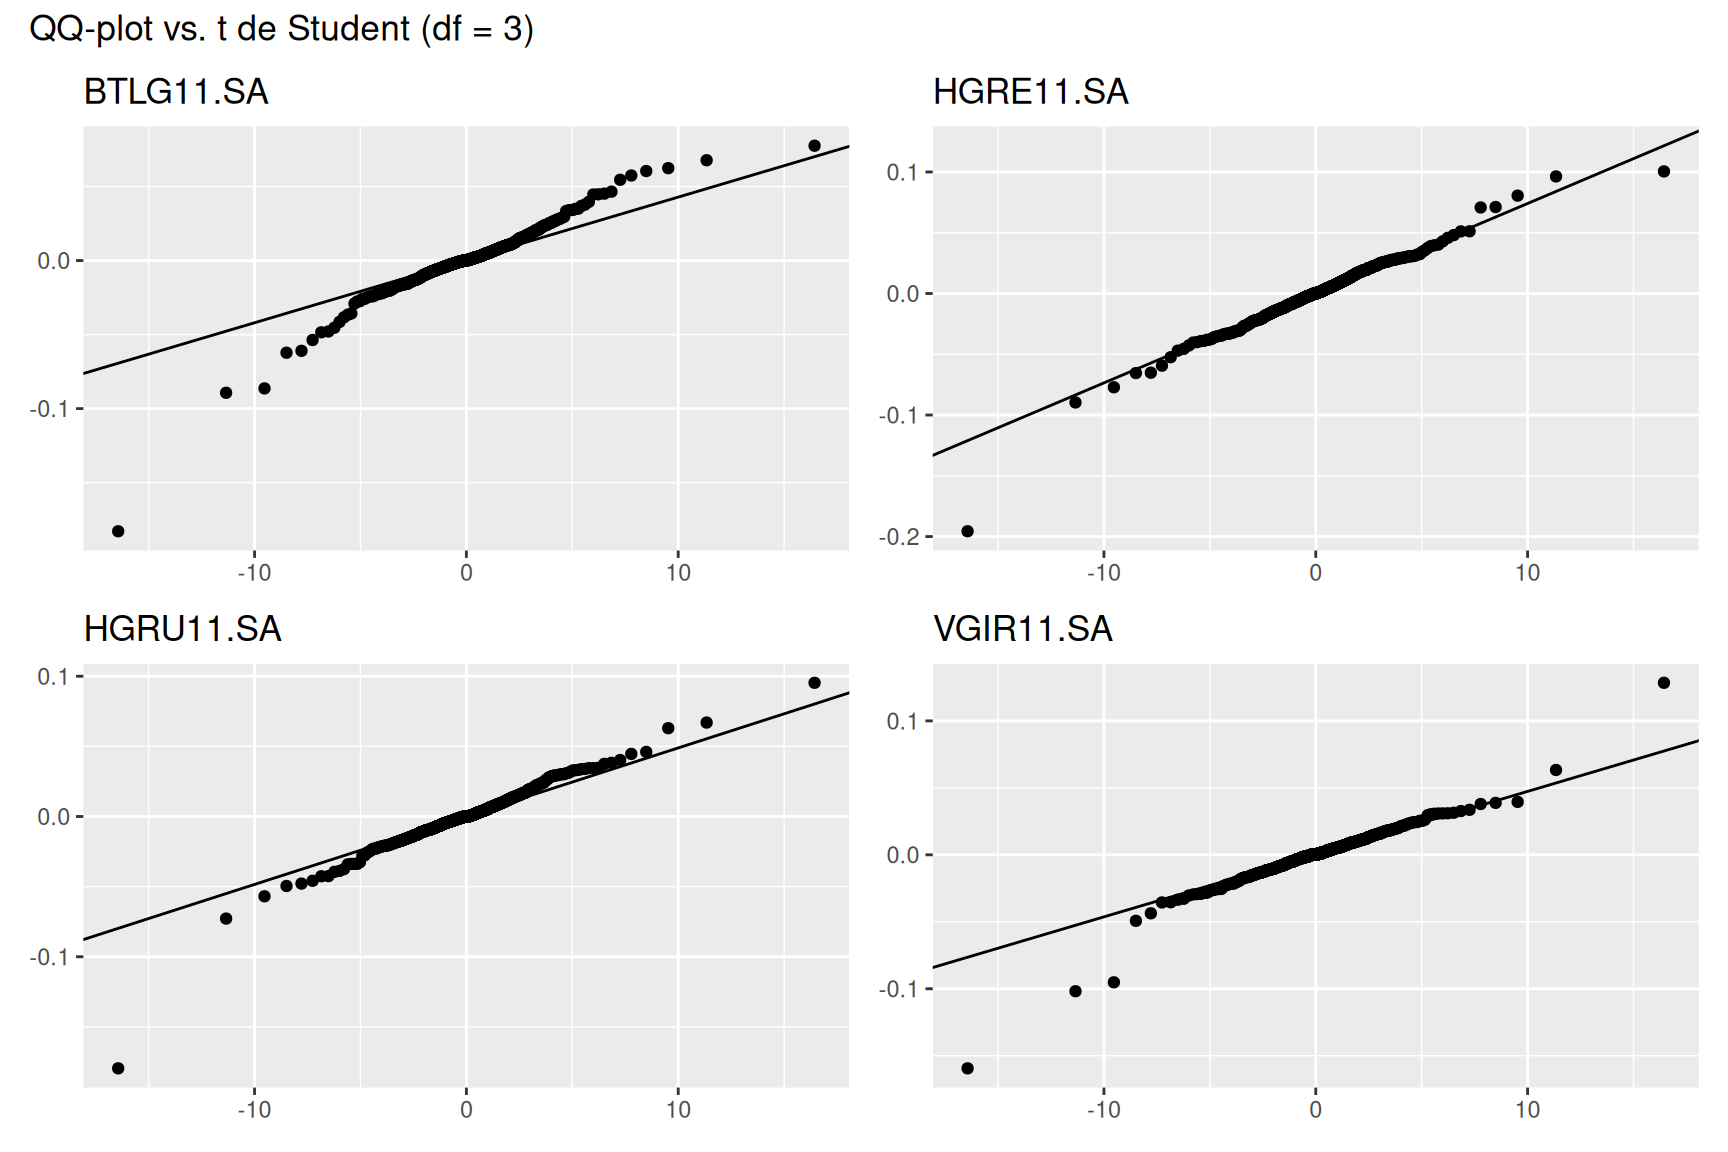
Função que ajusta um GARCH com a especificação do rugarch. A média é um ARMA simples (p, q) e a variância um GARCH de ordem (m, n).
garch_individual <- function(parms, ret, prog = NULL) {
  if (!is.null(prog)) {
    prog()
  }
  garch_model <- ugarchspec(
    variance.model = list(
      model = "fGARCH",
      submodel = "GARCH",
      garchOrder = c(parms$m, parms$n)
    ),
    mean.model = list(
      armaOrder = c(parms$p, parms$q),
      include.mean = TRUE
    ),
    distribution.model = parms$dist
  )
  # às vezes não converge
  suppressWarnings({
    fit <- tryCatch(
      ugarchfit(garch_model, data = ret),
      error = function(e) NULL
    )
  })
  fit
}
Testando para um ativo:
library(rugarch)
fit_exemplo <- garch_individual(
  parms = list(p = 0, q = 0, m = 1, n = 1, dist = "std"),
  ret = da_train |>
    dplyr::filter(ticker == "HGRE11.SA") |>
    pull(ret_adjusted_prices)
)
fit_exemplo
*---------------------------------*
*          GARCH Model Fit        *
*---------------------------------*

Conditional Variance Dynamics
-----------------------------------
GARCH Model : fGARCH(1,1)
fGARCH Sub-Model    : GARCH
Mean Model  : ARFIMA(0,0,0)
Distribution    : std

Optimal Parameters
------------------------------------
        Estimate  Std. Error  t value Pr(>|t|)
mu      0.000076    0.000190  0.40025 0.688972
omega   0.000020    0.000005  3.88728 0.000101
alpha1  0.262916    0.054760  4.80126 0.000002
beta1   0.665633    0.056707 11.73817 0.000000
shape   3.498776    0.313788 11.15012 0.000000

Robust Standard Errors:
        Estimate  Std. Error  t value Pr(>|t|)
mu      0.000076    0.000220  0.34437 0.730567
omega   0.000020    0.000005  3.69937 0.000216
alpha1  0.262916    0.053603  4.90489 0.000001
beta1   0.665633    0.060954 10.92030 0.000000
shape   3.498776    0.298690 11.71375 0.000000

LogLikelihood : 6409.096

Information Criteria
------------------------------------

Akaike       -6.2754
Bayes        -6.2617
Shibata      -6.2755
Hannan-Quinn -6.2704

Weighted Ljung-Box Test on Standardized Residuals
------------------------------------
                        statistic p-value
Lag[1]                     0.5865  0.4438
Lag[2*(p+q)+(p+q)-1][2]    0.6023  0.6475
Lag[4*(p+q)+(p+q)-1][5]    5.4731  0.1194
d.o.f=0
H0 : No serial correlation

Weighted Ljung-Box Test on Standardized Squared Residuals
------------------------------------
                        statistic p-value
Lag[1]                     0.1765  0.6744
Lag[2*(p+q)+(p+q)-1][5]    1.7066  0.6891
Lag[4*(p+q)+(p+q)-1][9]    6.4932  0.2454
d.o.f=2

Weighted ARCH LM Tests
------------------------------------
            Statistic Shape Scale P-Value
ARCH Lag[3]   0.04172 0.500 2.000 0.83815
ARCH Lag[5]   2.05431 1.440 1.667 0.45936
ARCH Lag[7]   6.72970 2.315 1.543 0.09923

Nyblom stability test
------------------------------------
Joint Statistic:  2.2794
Individual Statistics:
mu     0.4387
omega  0.8891
alpha1 0.2854
beta1  0.6474
shape  1.1222

Asymptotic Critical Values (10% 5% 1%)
Joint Statistic:         1.28 1.47 1.88
Individual Statistic:    0.35 0.47 0.75

Sign Bias Test
------------------------------------
                   t-value   prob sig
Sign Bias           1.3593 0.1742
Negative Sign Bias  0.5515 0.5814
Positive Sign Bias  1.0584 0.2900
Joint Effect        2.0629 0.5595


Adjusted Pearson Goodness-of-Fit Test:
------------------------------------
  group statistic p-value(g-1)
1    20     23.98     0.196999
2    30     36.76     0.152439
3    40     50.23     0.107391
4    50     76.71     0.006903


Elapsed time : 0.3655093 Em vez de chutar a ordem e a distribuição, varremos uma grade de (m, n, dist) e escolhemos pelo menor AIC. É o melhor_garch que ficava omitido no script de referência.
melhor_garch <- function(ativo, prog = NULL) {
  if (!is.null(prog)) {
    prog()
  }
  ret <- da_train |>
    dplyr::filter(ticker == ativo) |>
    dplyr::pull(ret_adjusted_prices)

  grid <- tidyr::expand_grid(
    p = 0,
    q = 0, # média (ARMA) simples
    m = 1:2,
    n = 1:2, # ordem do GARCH
    dist = c("norm", "std") # normal e t de Student
  )

  purrr::pmap(grid, function(p, q, m, n, dist) {
    parms <- list(p = p, q = q, m = m, n = n, dist = dist)
    fit <- garch_individual(parms, ret)
    ic <- tryCatch(rugarch::infocriteria(fit), error = function(e) NULL)
    if (is.null(ic)) {
      return(NULL)
    }
    tibble::tibble(
      p = p,
      q = q,
      m = m,
      n = n,
      dist = dist,
      aic = ic["Akaike", 1],
      bic = ic["Bayes", 1]
    )
  }) |>
    dplyr::bind_rows() |>
    dplyr::arrange(aic)
}melhores_por_ativo <- ativos |>
purrr::set_names() |>
purrr::map(melhor_garch, .progress = TRUE) |>
dplyr::bind_rows(.id = "ticker")
# Melhor modelo (menor AIC) por ativo
parametros_melhores <- melhores_por_ativo |>
dplyr::group_by(ticker) |>
dplyr::slice_head(n = 1) |>
dplyr::ungroup()
parametros_melhores# A tibble: 4 × 8
ticker p q m n dist aic bic
<chr> <dbl> <dbl> <int> <int> <chr> <dbl> <dbl>
1 BTLG11.SA 0 0 1 2 std -7.18 -7.16
2 HGRE11.SA 0 0 1 1 std -6.28 -6.26
3 HGRU11.SA 0 0 1 2 std -6.95 -6.94
4 VGIR11.SA 0 0 2 2 std -7.26 -7.24Reajustamos o modelo escolhido de cada ativo e projetamos a volatilidade alguns passos à frente. Guardamos o shape (graus de liberdade da t) para reusar no VaR.
prever_volatilidade <- function(parms, n_steps = 5) {
  ret <- da_train |>
    dplyr::filter(ticker == parms$ticker) |>
    pull(ret_adjusted_prices)

  garch_model <- ugarchspec(
    variance.model = list(
      model = "fGARCH",
      submodel = "GARCH",
      garchOrder = c(parms$m, parms$n)
    ),
    mean.model = list(armaOrder = c(parms$p, parms$q), include.mean = TRUE),
    distribution.model = parms$dist
  )

  fit <- ugarchfit(garch_model, data = ret, out.sample = n_steps - 1)

  shape <- if (parms$dist == "std") {
    as.numeric(fit@fit$coef["shape"])
  } else {
    NA_real_
  }
  forecasts <- ugarchforecast(fit, n.ahead = n_steps)@forecast

  tibble::tibble(
    ticker = parms$ticker,
    passo = seq_len(n_steps),
    serie = as.numeric(forecasts$seriesFor),
    volatilidade = as.numeric(forecasts$sigmaFor),
    shape = shape
  )
}

vol_futuro <- parametros_melhores |>
  dplyr::group_split(ticker) |>
  purrr::map(\(x) prever_volatilidade(as.list(x), n_steps = 5)) |>
  dplyr::bind_rows()

vol_futuro
# A tibble: 20 × 5
ticker passo serie volatilidade shape
<chr> <int> <dbl> <dbl> <dbl>
1 BTLG11.SA 1 0.000221 0.0113 2.94
2 BTLG11.SA 2 0.000221 0.0115 2.94
3 BTLG11.SA 3 0.000221 0.0117 2.94
4 BTLG11.SA 4 0.000221 0.0120 2.94
5 BTLG11.SA 5 0.000221 0.0122 2.94
6 HGRE11.SA 1 0.0000770 0.0193 3.50
7 HGRE11.SA 2 0.0000770 0.0192 3.50
8 HGRE11.SA 3 0.0000770 0.0190 3.50
9 HGRE11.SA 4 0.0000770 0.0188 3.50
10 HGRE11.SA 5 0.0000770 0.0187 3.50
11 HGRU11.SA 1 0.0000514 0.0245 2.72
12 HGRU11.SA 2 0.0000514 0.0240 2.72
13 HGRU11.SA 3 0.0000514 0.0245 2.72
14 HGRU11.SA 4 0.0000514 0.0247 2.72
15 HGRU11.SA 5 0.0000514 0.0250 2.72
16 VGIR11.SA 1 0.000248 0.00565 3.61
17 VGIR11.SA 2 0.000248 0.00540 3.61
18 VGIR11.SA 3 0.000248 NA 3.61
19 VGIR11.SA 4 0.000248 NA 3.61
20 VGIR11.SA 5 0.000248 NA 3.61Seguimos a receita do codingfinance: retorno médio por ativo, matriz de covariância (em escala diária) e milhares de carteiras aleatórias.
da_wide <- da_train |>
  dplyr::select(ref_date, name = ticker, value = ret_adjusted_prices) |>
  tidyr::pivot_wider()

da_xts <- da_wide |>
  timetk::tk_xts(select = -ref_date, date_var = ref_date)

mean_ret <- colMeans(da_xts, na.rm = TRUE)
cov_mat <- cov(da_xts, use = "complete.obs")
round(mean_ret, 5)
BTLG11.SA HGRE11.SA HGRU11.SA VGIR11.SA
0.00040 0.00021 0.00028 0.00031 Demonstrando em uma única carteira aleatória: pesos, retorno, risco e Sharpe.
set.seed(2)
wts <- runif(length(ativos))
wts <- wts / sum(wts)

port_returns <- sum(wts * mean_ret)
port_risk <- sqrt(t(wts) %*% (cov_mat %*% wts))
sharpe_ratio <- port_returns / port_risk

tibble::tibble(
  ativo = ativos,
  peso = round(wts, 3)
)
# A tibble: 4 × 2
ativo peso
<chr> <dbl>
1 HGRE11.SA 0.114
2 BTLG11.SA 0.431
3 HGRU11.SA 0.352
4 VGIR11.SA 0.103c(
retorno = port_returns,
risco = as.numeric(port_risk),
sharpe = as.numeric(sharpe_ratio)
) |>
round(5)retorno risco sharpe
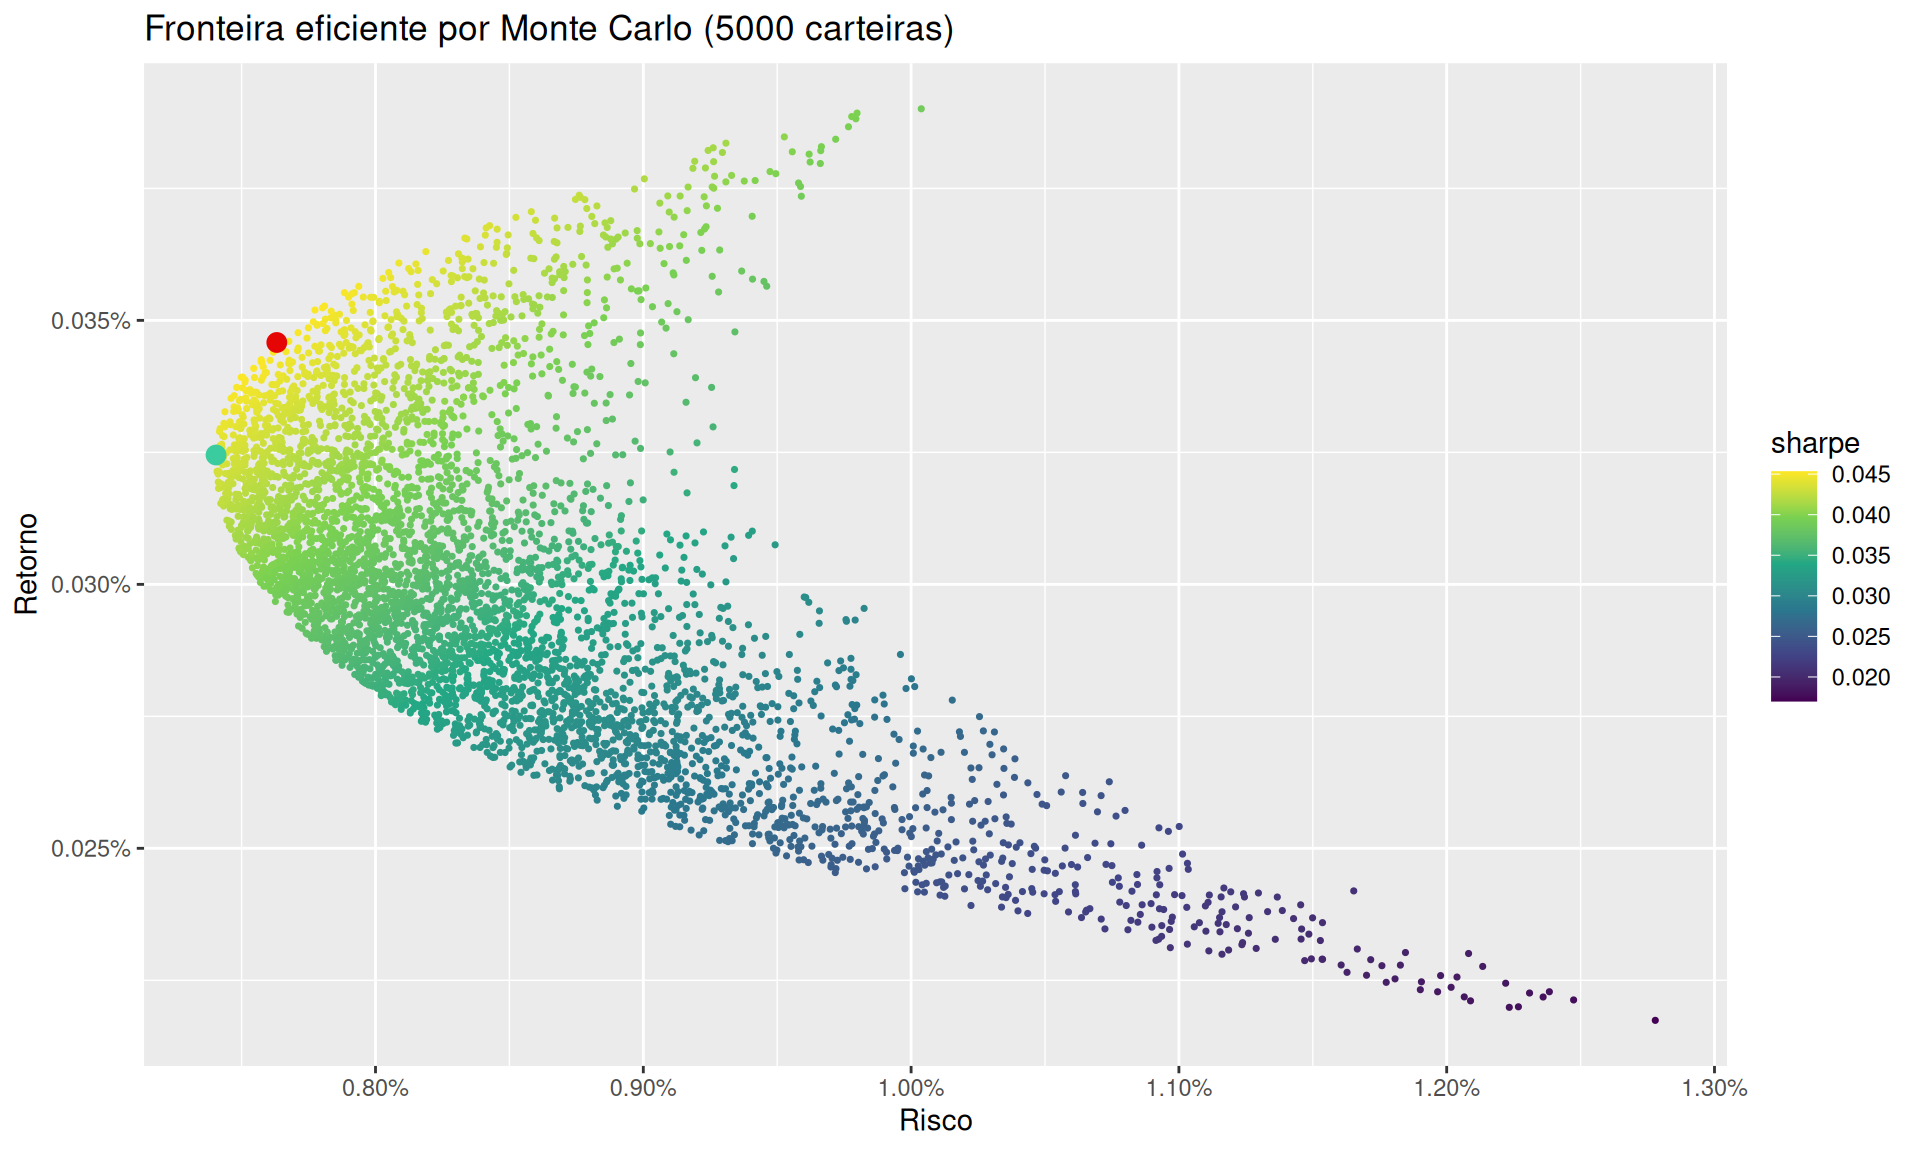
0.00027 0.00889 0.03000 Agora 5000 carteiras aleatórias. As de menor risco e maior Sharpe são a mínima variância e a carteira de tangência.
sim_returns <- function(i) {
  wts <- rgamma(length(ativos), 1)
  wts <- wts / sum(wts)
  port_ret <- sum(wts * mean_ret)
  port_sd <- as.numeric(sqrt(t(wts) %*% (cov_mat %*% wts)))

  wts |>
    purrr::set_names(ativos) |>
    tibble::enframe() |>
    tidyr::pivot_wider() |>
    dplyr::mutate(
      return = port_ret,
      risk = port_sd,
      sharpe = port_ret / port_sd
    )
}

portfolio_values <- purrr::map(1:5000, sim_returns) |>
  dplyr::bind_rows(.id = "run")

min_var <- portfolio_values[which.min(portfolio_values$risk), ]
max_sr <- portfolio_values[which.max(portfolio_values$sharpe), ]min_var |>
tidyr::pivot_longer(all_of(ativos)) |>
dplyr::mutate(name = forcats::fct_reorder(name, value)) |>
ggplot(aes(name, value)) +
geom_col(fill = "#3ACC9F") +
scale_y_continuous(labels = scales::percent) +
labs(x = "Ativo", y = "Peso", title = "Carteira de mínima variância")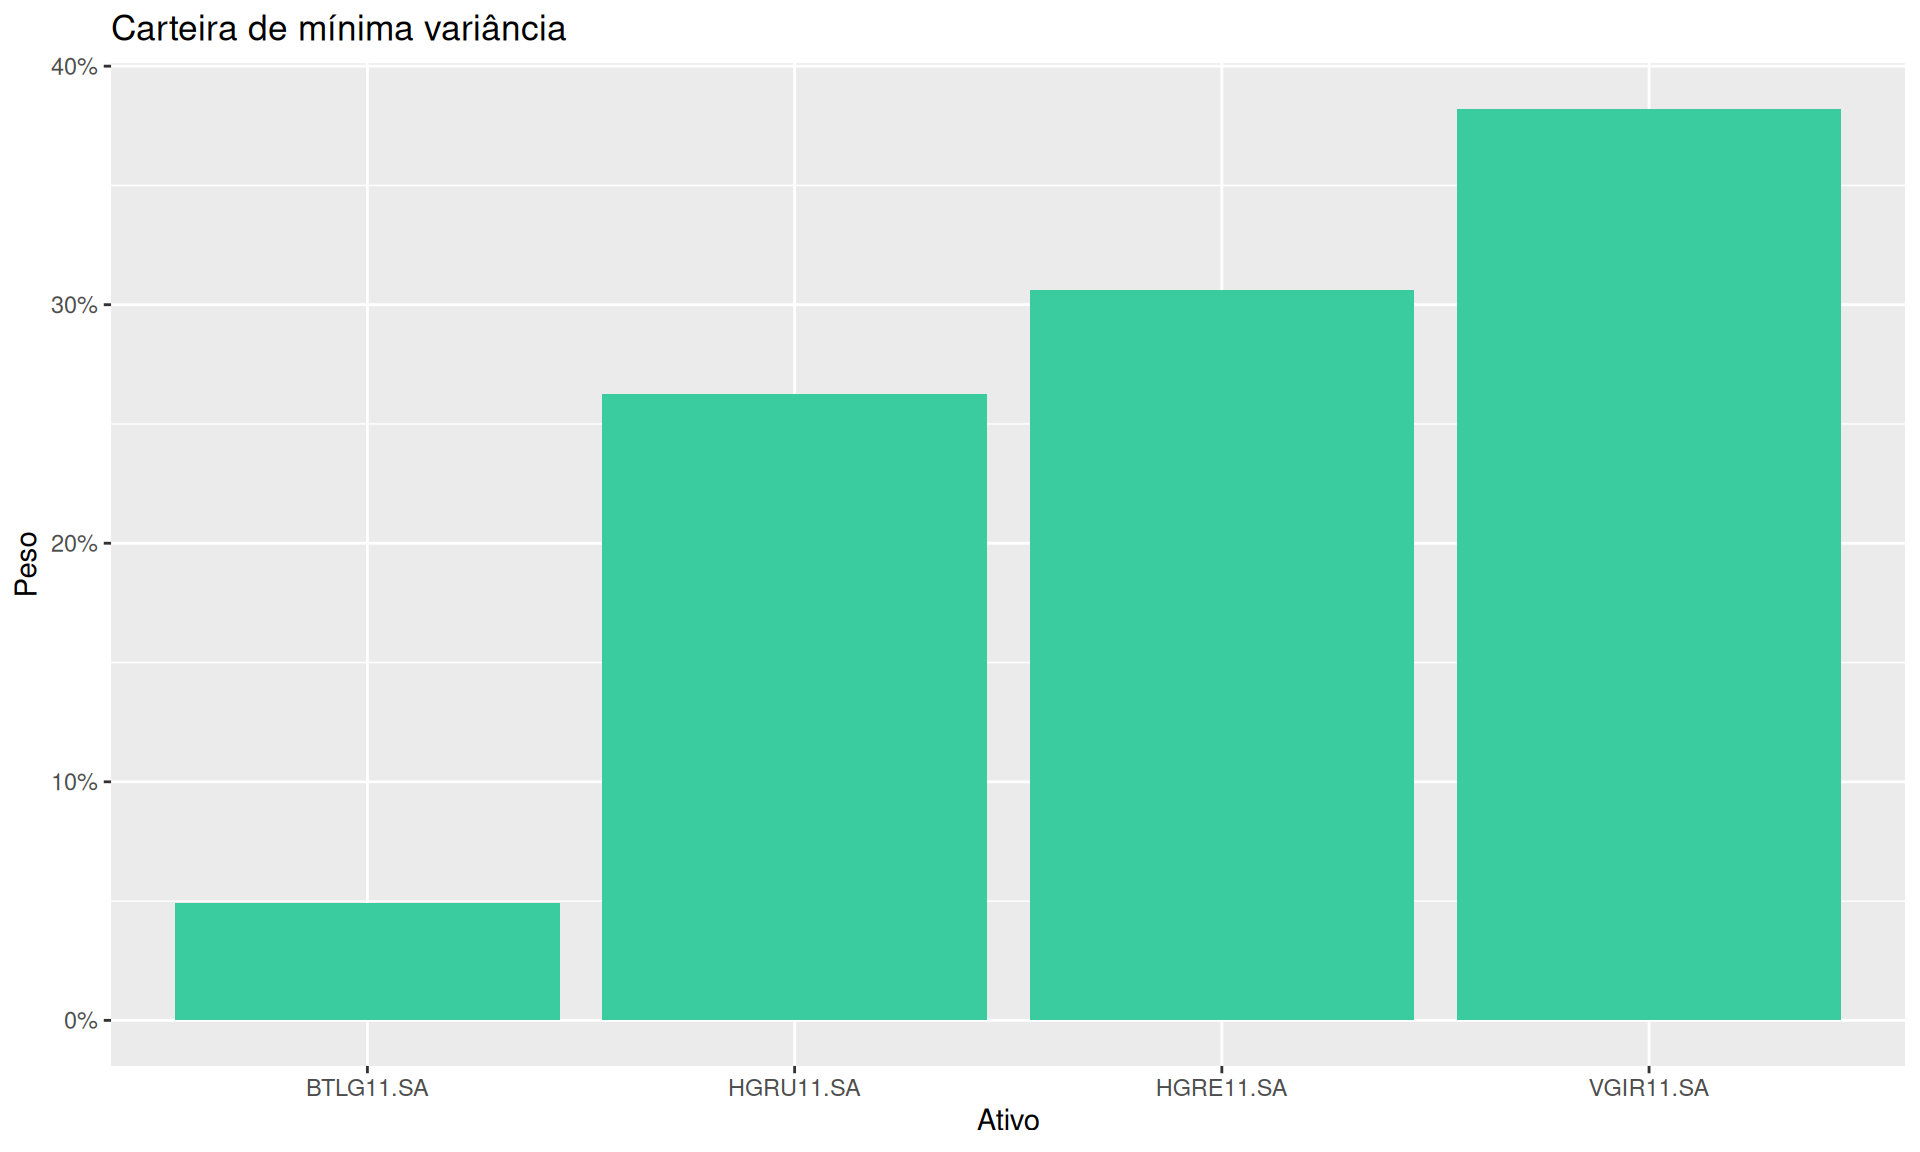
max_sr |>
  tidyr::pivot_longer(all_of(ativos)) |>
  dplyr::mutate(name = forcats::fct_reorder(name, value)) |>
  ggplot(aes(name, value)) +
  geom_col(fill = "#E50505") +
  scale_y_continuous(labels = scales::percent) +
  labs(x = "Ativo", y = "Peso", title = "Carteira de tangência (máximo Sharpe)")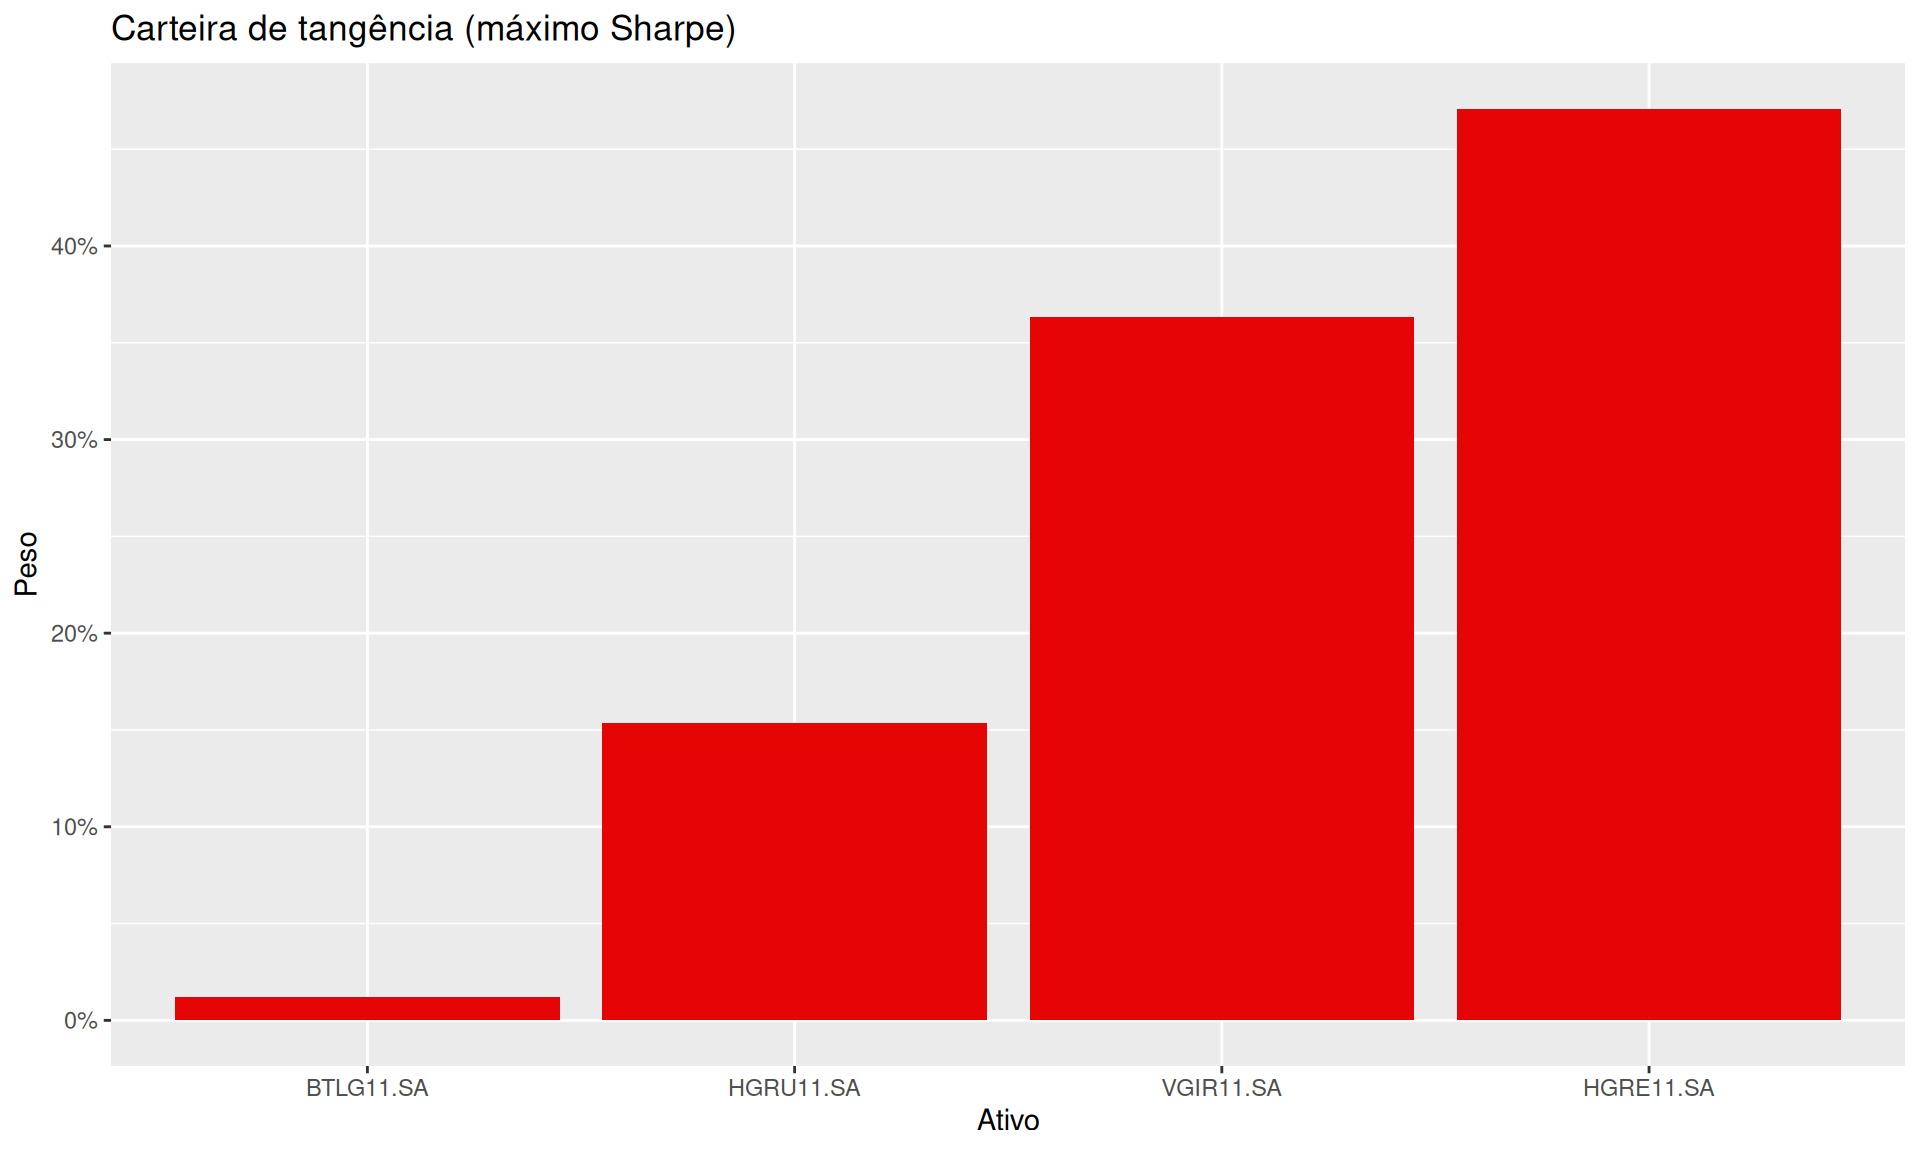
portfolio_values |>
  ggplot(aes(x = risk, y = return, color = sharpe)) +
  geom_point(size = 0.6) +
  scale_color_viridis_c() +
  scale_y_continuous(labels = scales::percent) +
  scale_x_continuous(labels = scales::percent) +
  labs(
    x = "Risco",
    y = "Retorno",
    title = "Fronteira eficiente por Monte Carlo (5000 carteiras)"
  ) +
  geom_point(
    aes(x = risk, y = return),
    data = min_var,
    color = "#3ACC9F",
    size = 3
  ) +
  geom_point(
    aes(x = risk, y = return),
    data = max_sr,
    color = "#E50505",
    size = 3
  )
Usamos a carteira de mínima variância e o shape (graus de liberdade) mais conservador estimado pelos GARCHs. O VaR sai de um quantil da t de Student.
pesos_finais <- min_var |>
  dplyr::select(all_of(ativos)) |>
  as.numeric()

# retorno esperado um passo à frente, por ativo, na ordem de `ativos`
serie_1passo <- vol_futuro |>
  dplyr::group_by(ticker) |>
  dplyr::slice_head(n = 1) |>
  dplyr::ungroup() |>
  dplyr::arrange(match(ticker, ativos))

rt_final <- sum(serie_1passo$serie * pesos_finais)
st_dev_final <- as.numeric(sqrt(pesos_finais %*% cov_mat %*% pesos_finais))
nu <- min(vol_futuro$shape, na.rm = TRUE)
valor_t <- qt(0.95, nu)

VaR <- rt_final + valor_t * st_dev_final / sqrt(nu / (nu - 2))
c(rt_final = rt_final, st_dev = st_dev_final, nu = nu, VaR = VaR) |> round(5)
rt_final st_dev nu VaR
0.00014 0.00740 2.71792 0.00949 O VaR resume, num número só, “qual é uma perda plausível num dia ruim”, usando a cauda da t de Student (graus de liberdade baixos = caudas pesadas). O nu precisa ser maior que 2 para a variância existir. Na aula de VaR formalizamos VaR paramétrico, histórico e Monte Carlo.
Medimos a exposição ao mercado. O beta de cada ativo vem de cov / var contra o Ibovespa; o beta da carteira é a média ponderada dos betas, e checamos com uma regressão.
market_returns <- yfR::yf_get(
  "^BVSP",
  first_date = data_corte + 1,
  type_return = "log",
  freq_data = "daily",
  do_complete_data = TRUE
) |>
  dplyr::select(ref_date, ibov = ret_adjusted_prices)

# retornos da carteira = soma ponderada por data (sem tidyquant)
port_wide <- da_train |>
  dplyr::select(ref_date, ticker, ret = ret_adjusted_prices) |>
  tidyr::pivot_wider(names_from = ticker, values_from = ret) |>
  tidyr::drop_na()

port_wide$portfolio <- as.numeric(
  as.matrix(port_wide[, ativos]) %*% pesos_finais
)

all_returns <- market_returns |>
  dplyr::inner_join(
    dplyr::select(port_wide, ref_date, portfolio),
    "ref_date"
  ) |>
  tidyr::drop_na()

beta_geral <- with(all_returns, cov(portfolio, ibov) / var(ibov))

calcular_beta <- function(ativo) {
  da_train |>
    dplyr::filter(ticker == ativo) |>
    dplyr::inner_join(market_returns, "ref_date") |>
    tidyr::drop_na() |>
    with(cov(ret_adjusted_prices, ibov) / var(ibov))
}

betas <- purrr::map_dbl(ativos, calcular_beta) |>
  purrr::set_names(ativos)

round(betas, 3)
HGRE11.SA BTLG11.SA HGRU11.SA VGIR11.SA
0.231 0.183 0.215 0.157 c(beta_ponderado = sum(betas * pesos_finais), beta_regressao = beta_geral) |>
round(3)beta_ponderado beta_regressao
0.196 0.196 lm(portfolio ~ ibov, data = all_returns) |>
broom::tidy()# A tibble: 2 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 0.000189 0.000169 1.12 2.61e- 1
2 ibov 0.196 0.0114 17.2 4.62e-62Os betas dos FIIs costumam ficar bem abaixo de 1: eles se movem pouco com o Ibovespa. Isso é exatamente o ponto de ter FIIs na carteira (descorrelação com a bolsa), e não um sinal de mau investimento por si só. “Péssimo ou apenas ruim” depende do retorno ajustado ao risco. Na aula de CAPM e Portfólios formalizamos o CAPM e a leitura de beta, alpha e a reta de mercado.
A dinâmica final é a mesma do lab oficial: o app interativo Monte sua Carteira (Shiny for Python). Em grupos, escolham ativos, mexam nos pesos e observem retorno, risco, Sharpe, VaR e o backtest contra o Ibovespa ao vivo. O passo a passo está no Lab 3 oficial e em labs/app-carteira/README.md.