---
title: "Labs 3 e 4: Séries Financeiras, GARCH e Portfólios"
subtitle: "Fundos imobiliários: fatos estilizados, volatilidade, fronteira, VaR e CAPM"
jupyter: python3
---
::: {.objetivos}
#### Objetivos do Lab
- [Aplicar]{.bloom-badge .bloom-aplicar} download e tratamento de séries financeiras com `yfinance`
- [Analisar]{.bloom-badge .bloom-analisar} fatos estilizados em fundos imobiliários brasileiros
- [Criar]{.bloom-badge .bloom-criar} modelos GARCH e portfólios pela fronteira eficiente
- [Avaliar]{.bloom-badge .bloom-avaliar} risco e exposição via VaR e betas (CAPM)
:::
::: {.callout-tip}
## Estrutura do Lab
Trabalhamos com o **mesmo pool de ativos** do começo ao fim, num pipeline end-to-end de
séries financeiras. São dois blocos complementares, em dois encontros:
- **Bloco 3.1 (Lab 3, remoto):** séries financeiras e GARCH (Partes 1 a 3). Preços, log-retornos, fatos estilizados,
grid de modelos GARCH, previsão de volatilidade.
- **Bloco 3.2 (Lab 4, presencial):** portfólio (Partes 4 a 6), logo depois das aulas de VaR e
CAPM, seguido da dinâmica [Monte sua Carteira](lab04-carteira.qmd). Retorno e risco por ativo, fronteira eficiente por Monte
Carlo (mínima variância e máximo Sharpe), VaR via t de Student e betas/CAPM contra o
Ibovespa.
:::
::: {.callout-note collapse="true"}
## Por que fundos imobiliários?
O pool são quatro FIIs que o monitor já teve na carteira (`HGRE11`, `BTLG11`, `HGRU11`,
`VGIR11`). A pergunta de negócio é honesta: foi um **péssimo** investimento ou apenas
**ruim**? FIIs costumam ter beta baixo contra o Ibovespa, então a parte de CAPM rende
boa discussão. Quem quiser a versão com blue-chips e a fronteira resolvida por
otimização tem a [versão alternativa do Lab 3](lab03-financeiras-alternativo.qmd), e quem
preferir R tem o [espelho em R](lab03-financeiras-r.qmd) com `rugarch` e `yfR`.
:::
## Setup compartilhado
```{python}
import requests

# yfinance às vezes é bloqueado sem um User-Agent de navegador.
# Truque clássico: forçar um header global em todas as requisições.
_old_request = requests.Session.request

def _new_request(self, method, url, *args, **kwargs):
    headers = kwargs.get("headers", {}) or {}
    headers.setdefault(
        "User-Agent",
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
        "(KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
    )
    kwargs["headers"] = headers
    return _old_request(self, method, url, *args, **kwargs)

requests.Session.request = _new_request
```
```{python}
import itertools
import warnings

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import plotly.express as px
import plotly.graph_objects as go
from plotly.subplots import make_subplots

import yfinance as yf
from arch import arch_model
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf
import statsmodels.api as sm
from scipy import stats

warnings.filterwarnings("ignore")

plt.rcParams.update({
    "figure.figsize": (12, 5),
    "axes.spines.top": False,
    "axes.spines.right": False,
    "font.size": 12,
})

INSPER_RED = "#E50505"
INSPER_TURQUESA = "#3ACC9F"
INSPER_AMARELO = "#FFCC00"
INSPER_ROXO = "#730D9F"
INSPER_GRAY = "#5B5B5B"
```
```{python}
# Pool de ativos: fundos imobiliários. O Ibovespa entra só como benchmark do CAPM.
ativos = ["HGRE11.SA", "BTLG11.SA", "HGRU11.SA", "VGIR11.SA"]
benchmark = "^BVSP"
nomes = {
    "HGRE11.SA": "CSHG Real Estate", "BTLG11.SA": "BTG Logística",
    "HGRU11.SA": "CSHG Urbano", "VGIR11.SA": "Valora CRI", "^BVSP": "Ibovespa",
}
start_date = "2018-01-01"

todos = ativos + [benchmark]
precos = yf.download(todos, start=start_date, auto_adjust=False, progress=False)["Adj Close"]

# Data mínima comum a todas as séries (alguns FIIs listaram depois de 2018).
data_corte = precos[ativos].dropna().index.min()
precos = precos.loc[data_corte:]

bench_precos = precos[benchmark]
precos = precos[ativos].dropna()

retornos = np.log(precos / precos.shift(1)).dropna()
ret_bench = np.log(bench_precos / bench_precos.shift(1)).dropna()

print(f"Período: {precos.index.min().date()} a {precos.index.max().date()}")
print(f"Observações: {len(precos)} dias úteis")
precos.head()
```
# Bloco 3.1: Séries Financeiras e GARCH
## Parte 1: Preços e log-retornos
```{python}
precos_norm = (precos / precos.iloc[0]) * 100

fig = px.line(
    precos_norm, y=precos_norm.columns,
    title="Preços Normalizados (Base 100)",
    labels={"value": "Índice", "variable": "Ativo"},
    template="plotly_white",
)
fig.update_layout(font_family="Inter", hovermode="x unified")
fig.show()
```
```{python}
desc = retornos.describe().T
desc["skewness"] = retornos.skew()
desc["kurtosis"] = retornos.kurtosis()
desc["jarque_bera_p"] = [stats.jarque_bera(retornos[col])[1] for col in retornos.columns]

desc[["mean", "std", "skewness", "kurtosis", "jarque_bera_p"]].round(4)
```
::: {.callout-note}
## Interprete a Tabela
- **Curtose > 0**: caudas mais pesadas que a normal (esperado em ativos financeiros)
- **Assimetria < 0**: cauda esquerda mais pesada (quedas mais extremas)
- **Jarque-Bera p < 0.05**: rejeita normalidade
:::
## Parte 2: Fatos estilizados
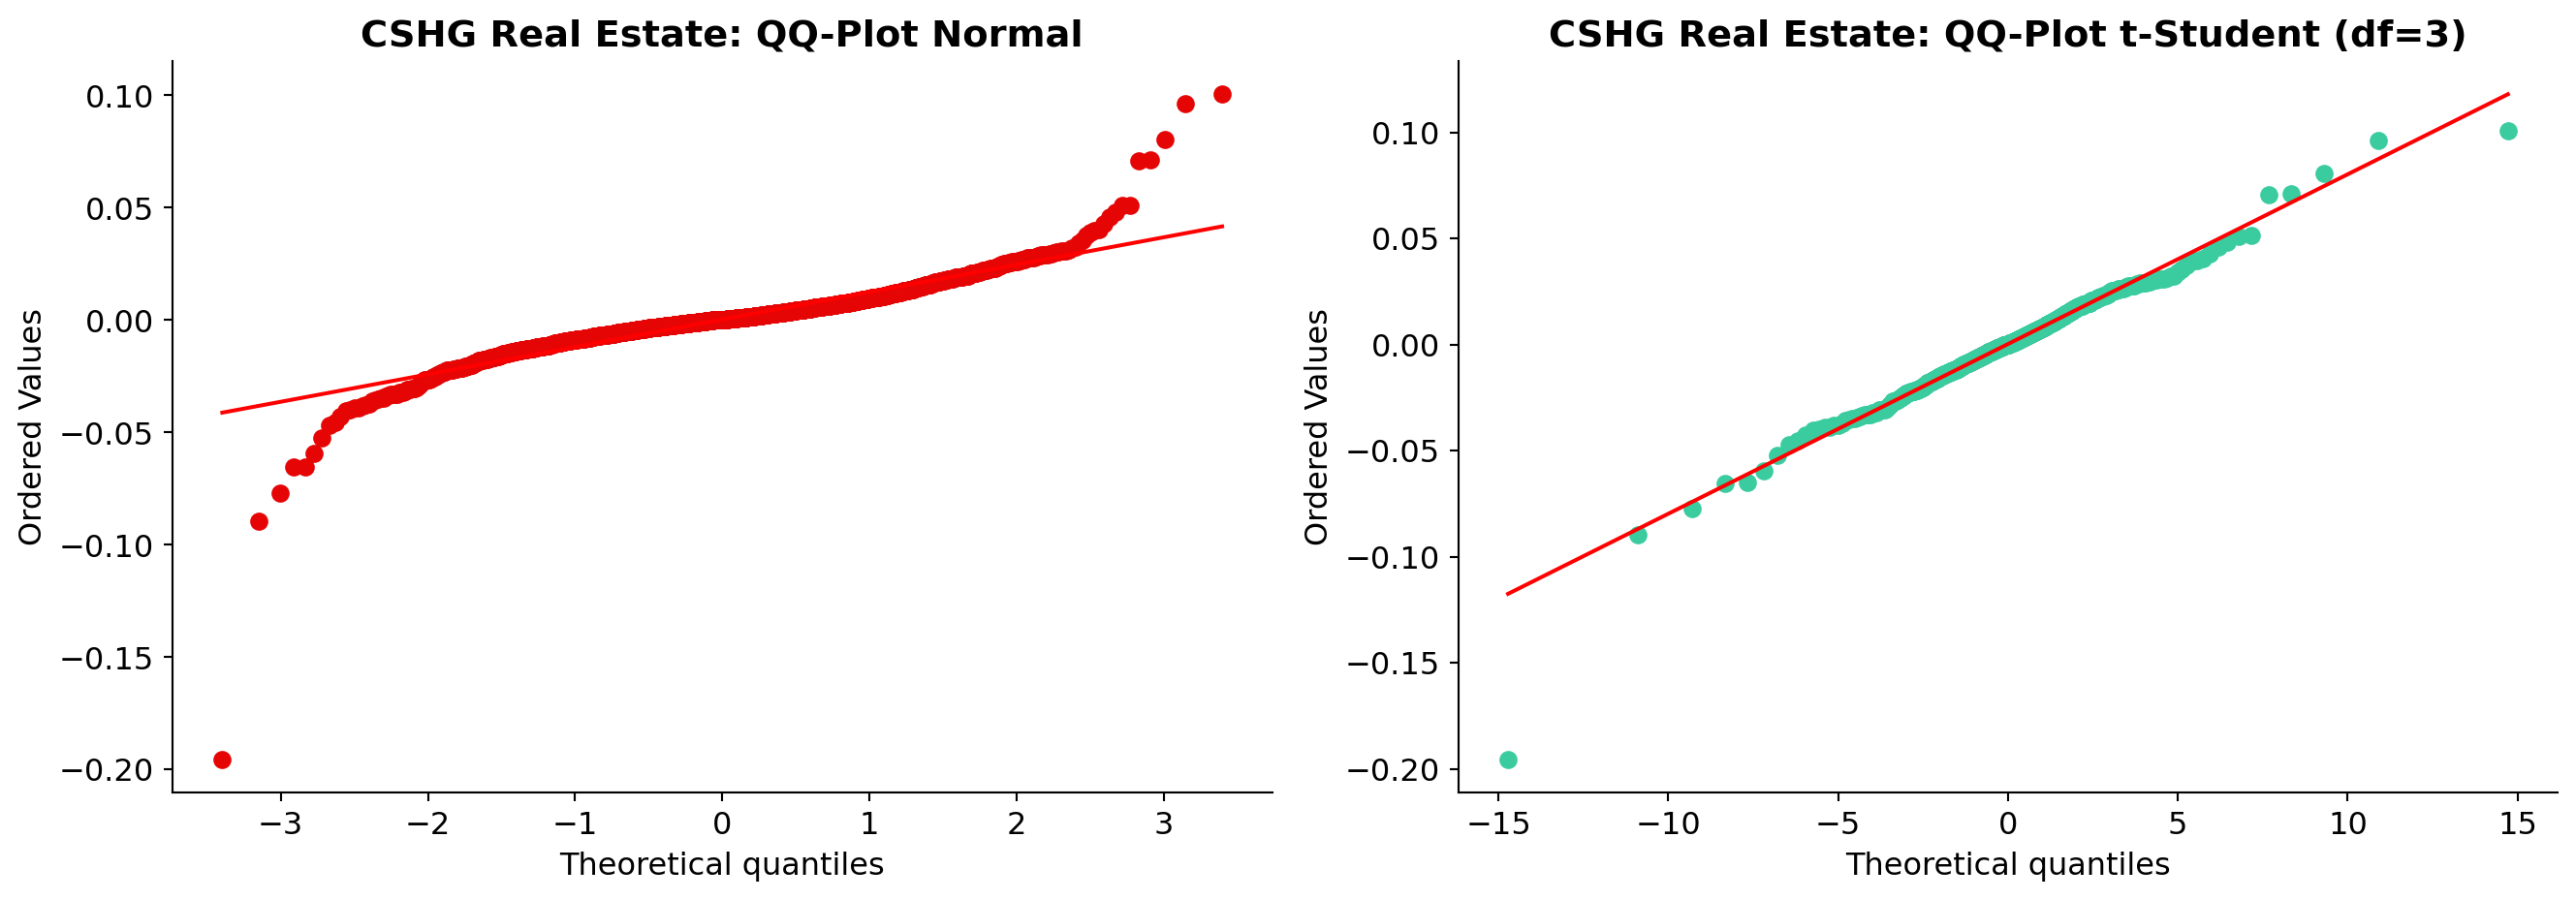
### Caudas pesadas
```{python}
ativo_foco = "HGRE11.SA"
ret = retornos[ativo_foco].values

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

stats.probplot(ret, dist="norm", plot=axes[0])
axes[0].set_title(f"{nomes[ativo_foco]}: QQ-Plot Normal", fontweight="bold")
axes[0].get_lines()[0].set_color(INSPER_RED)

stats.probplot(ret, dist="t", sparams=(3,), plot=axes[1])
axes[1].set_title(f"{nomes[ativo_foco]}: QQ-Plot t-Student (df=3)", fontweight="bold")
axes[1].get_lines()[0].set_color(INSPER_TURQUESA)

plt.tight_layout()
plt.show()
```
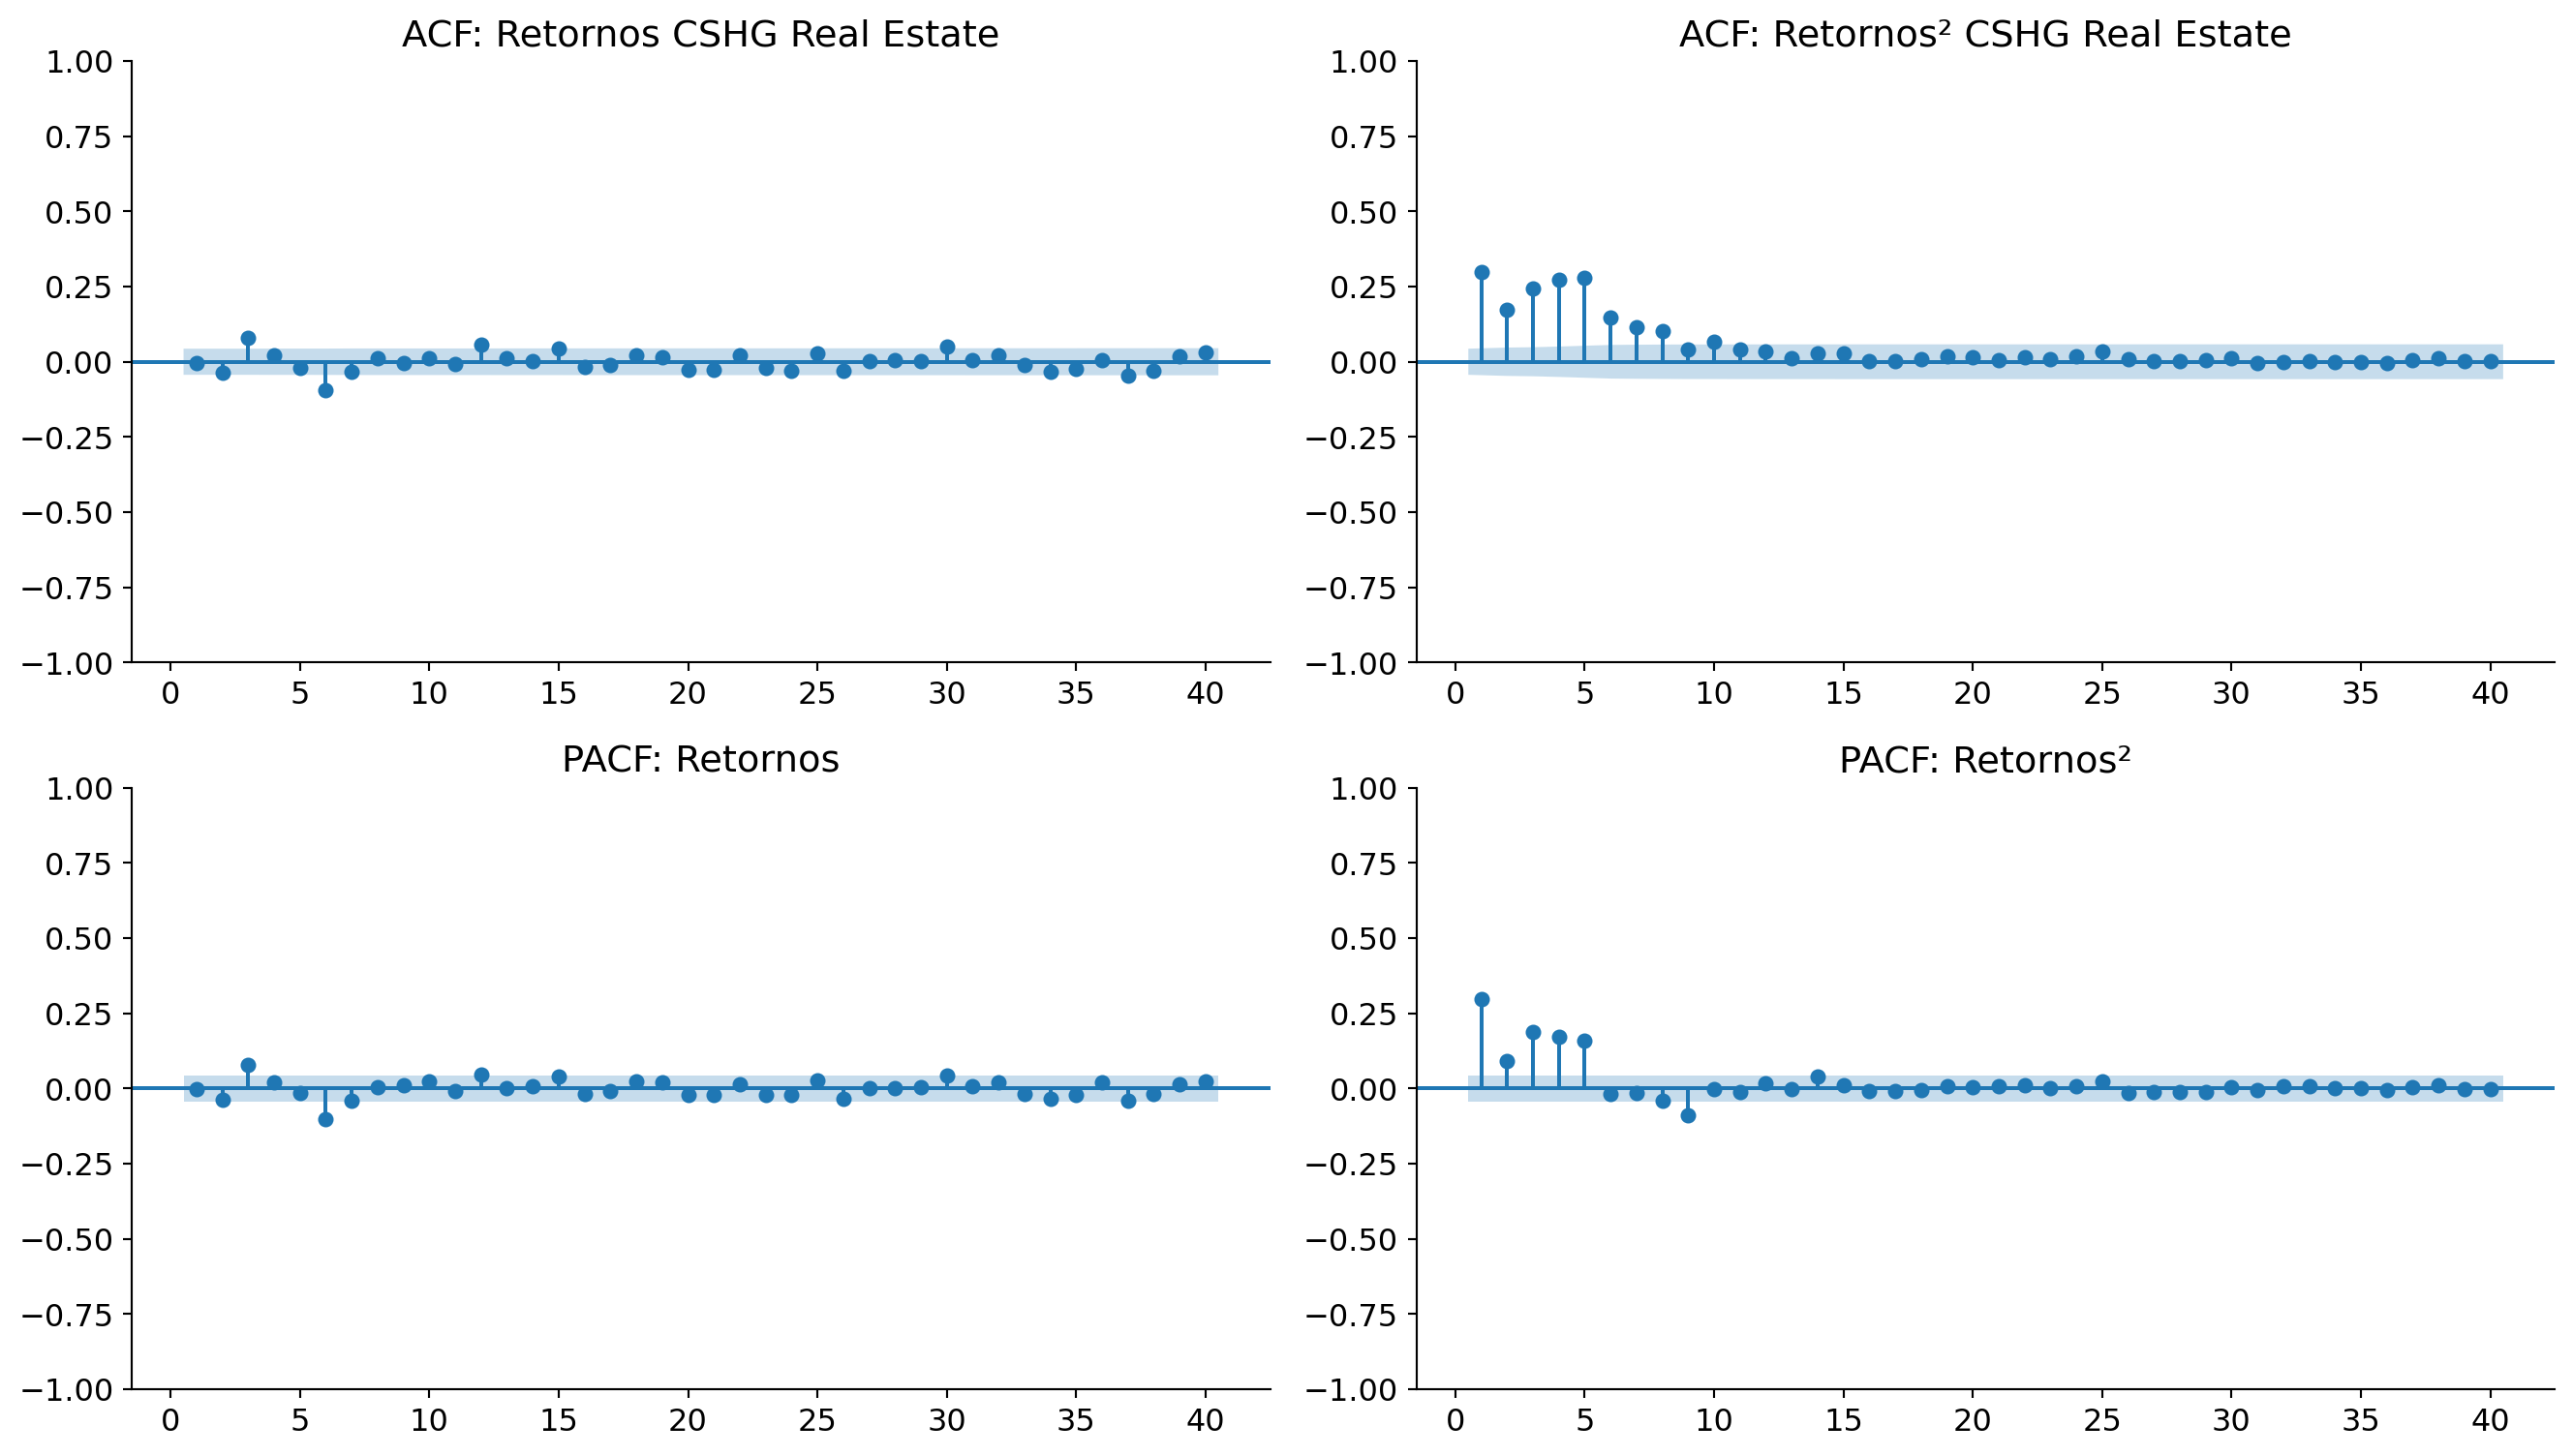
### Clusters de volatilidade
```{python}
fig, axes = plt.subplots(2, 2, figsize=(14, 8))

plot_acf(retornos[ativo_foco].dropna(), ax=axes[0, 0], lags=40, zero=False,
         title=f"ACF: Retornos {nomes[ativo_foco]}")
plot_acf(retornos[ativo_foco].dropna() ** 2, ax=axes[0, 1], lags=40, zero=False,
         title=f"ACF: Retornos² {nomes[ativo_foco]}")
plot_pacf(retornos[ativo_foco].dropna(), ax=axes[1, 0], lags=40, zero=False,
          title="PACF: Retornos")
plot_pacf(retornos[ativo_foco].dropna() ** 2, ax=axes[1, 1], lags=40, zero=False,
          title="PACF: Retornos²")

plt.tight_layout()
plt.show()
```
::: {.callout-caution collapse="true"}
## Exercício: Interpretação
1. **Os retornos têm autocorrelação significativa? E os retornos ao quadrado?** Os
retornos simples geralmente não têm autocorrelação significativa (mercado eficiente).
Mas os retornos ao quadrado têm autocorrelação forte e persistente: é o sinal de
clusters de volatilidade.
2. **O que a ACF dos retornos ao quadrado está nos dizendo?** Que a **variância**
(volatilidade) muda ao longo do tempo de forma previsível. Períodos de alta
volatilidade tendem a ser seguidos por mais alta volatilidade.
3. **O QQ-Plot com distribuição t se ajusta melhor?** Sim, a t com poucos graus de
liberdade (3 a 8) se ajusta melhor às caudas dos retornos financeiros.
:::
## Parte 3: Modelos GARCH
Começamos ajustando um GARCH(1,1) com distribuição t num único ativo. A convenção do
pacote `arch` é trabalhar em **retornos percentuais**, então multiplicamos por 100.
```{python}
def garch_individual(serie, p=1, q=1, dist="t"):
    """Ajusta um GARCH(p, q). Retorna None se não convergir."""
    modelo = arch_model(serie * 100, vol="Garch", p=p, q=q, dist=dist)
    try:
        return modelo.fit(disp="off")
    except Exception:
        return None

resultado_garch = garch_individual(retornos[ativo_foco], p=1, q=1, dist="t")
print(resultado_garch.summary())
```
```{python}
vol_condicional = resultado_garch.conditional_volatility / 100

fig = make_subplots(rows=2, cols=1, shared_xaxes=True,
                    subplot_titles=[f"Retornos: {nomes[ativo_foco]}",
                                    "Volatilidade Condicional (GARCH)"])
fig.add_trace(go.Scatter(x=retornos.index, y=retornos[ativo_foco],
                         mode="lines", line=dict(color=INSPER_GRAY, width=0.5),
                         name="Retornos"), row=1, col=1)
fig.add_trace(go.Scatter(x=retornos.index, y=vol_condicional,
                         mode="lines", line=dict(color=INSPER_RED, width=1),
                         name="Volatilidade GARCH"), row=2, col=1)
fig.update_layout(height=600, template="plotly_white", font_family="Inter",
                  showlegend=False)
fig.show()
```
### Um grid de modelos por ativo
Em vez de chutar `(p, q)` e a distribuição, varremos uma pequena grade e escolhemos pelo
menor **AIC**. É o equivalente em Python da função `melhor_garch` do material em R.
```{python}
def grid_garch(serie, ps=(1, 2), qs=(1, 2), dists=("normal", "t", "skewt")):
    """Varre (p, q, dist) e devolve a tabela ordenada por AIC."""
    linhas = []
    for p, q, dist in itertools.product(ps, qs, dists):
        fit = garch_individual(serie, p=p, q=q, dist=dist)
        if fit is not None:
            linhas.append({"p": p, "q": q, "dist": dist,
                           "AIC": fit.aic, "BIC": fit.bic,
                           "LogLik": fit.loglikelihood})
    return pd.DataFrame(linhas).sort_values("AIC").reset_index(drop=True)

# Exemplo para um ativo
grid_garch(retornos[ativo_foco]).round(1).head(6)
```
```{python}
# Melhor modelo por ativo (linha de menor AIC)
melhores_por_ativo = {}
for ativo in ativos:
    melhor = grid_garch(retornos[ativo]).iloc[0]
    melhores_por_ativo[ativo] = melhor

tab_melhores = pd.DataFrame(melhores_por_ativo).T
tab_melhores.index = [nomes[a] for a in ativos]
tab_melhores[["p", "q", "dist", "AIC", "BIC"]].round(1)
```
### Previsão de volatilidade
Para cada ativo reajustamos o modelo escolhido e projetamos a volatilidade alguns passos
à frente. Guardamos também o `nu` (graus de liberdade da t), que vamos reusar no VaR.
```{python}
def prever_volatilidade(ativo, params, n_steps=5):
    serie = retornos[ativo]
    fit = arch_model(serie * 100, vol="Garch",
                     p=int(params["p"]), q=int(params["q"]),
                     dist=params["dist"]).fit(disp="off")
    fc = fit.forecast(horizon=n_steps, reindex=False)
    sigma = np.sqrt(fc.variance.values[-1, :]) / 100
    serie_prev = fc.mean.values[-1, :] / 100
    shape = float(fit.params.get("nu", np.nan))
    return pd.DataFrame({
        "ticker": ativo,
        "passo": np.arange(1, n_steps + 1),
        "serie": serie_prev,
        "volatilidade": sigma,
        "shape": shape,
    })

vol_futuro = pd.concat(
    [prever_volatilidade(a, melhores_por_ativo[a]) for a in ativos],
    ignore_index=True,
)
vol_futuro.round(4).head(8)
```
```{python}
# Volatilidade prevista no primeiro passo, por ativo
vol_1passo = (vol_futuro[vol_futuro["passo"] == 1]
              .set_index("ticker")["volatilidade"]
              .rename("Vol. prevista (1 passo)"))
vol_1passo.index = [nomes[a] for a in vol_1passo.index]
vol_1passo.to_frame().style.format("{:.4f}")
```
::: {.callout-caution collapse="true"}
## Exercício: comparar as volatilidades
Olhe a volatilidade prevista de cada FII e relacione com a natureza do fundo. FIIs de
**tijolo** (lajes corporativas, galpões logísticos) costumam oscilar mais que FIIs de
**papel** (CRIs). O que os números dizem? Bate com a sua intuição sobre cada negócio?
:::
# Bloco 3.2: Portfólio
## Parte 4: Retorno, risco e fronteira eficiente
Seguimos a receita clássica do [codingfinance](https://www.codingfinance.com/post/2018-05-31-portfolio-opt-in-python/):
retorno médio por ativo, matriz de covariância (em escala diária, sem anualizar) e
milhares de carteiras aleatórias para desenhar a fronteira.
```{python}
mean_ret = retornos.mean().values
cov_mat = retornos.cov().values

resumo = pd.DataFrame({
    "Retorno médio diário (%)": mean_ret * 100,
    "Risco diário (%)": retornos.std().values * 100,
}, index=[nomes[a] for a in ativos]).round(4)
resumo
```
```{python}
corr = retornos.corr()
fig = px.imshow(
    corr, text_auto=".2f",
    color_continuous_scale=["#3ACC9F", "#FFFFFF", "#E50505"],
    title="Matriz de Correlação", template="plotly_white",
)
fig.update_layout(font_family="Inter")
fig.show()
```
Antes do loop, vale ver os cálculos para **uma** carteira aleatória: pesos, retorno,
risco e Sharpe.
```{python}
rng = np.random.default_rng(2)
n_ativos = len(ativos)

wts = rng.random(n_ativos)
wts = wts / wts.sum()

port_ret = np.sum(wts * mean_ret)
port_risk = np.sqrt(wts @ cov_mat @ wts)
sharpe = port_ret / port_risk

print("Pesos:", dict(zip(ativos, wts.round(3))))
print(f"Retorno: {port_ret:.5f} | Risco: {port_risk:.5f} | Sharpe: {sharpe:.3f}")
```
Agora rodamos o mesmo cálculo em 5000 carteiras aleatórias. As de menor risco e maior
Sharpe são a **mínima variância** e a **carteira de tangência**.
```{python}
n_port = 5000
W = rng.dirichlet(np.ones(n_ativos), n_port)
rets = W @ mean_ret
risks = np.sqrt(np.einsum("ij,jk,ik->i", W, cov_mat, W))
sharpes = rets / risks

i_minvar = int(np.argmin(risks))
i_maxsr = int(np.argmax(sharpes))

pesos_minvar = W[i_minvar]
pesos_maxsr = W[i_maxsr]

print("Mínima variância:", dict(zip(ativos, pesos_minvar.round(3))))
print("Máximo Sharpe   :", dict(zip(ativos, pesos_maxsr.round(3))))
```
```{python}
fig = go.Figure()
fig.add_trace(go.Scatter(
    x=risks * 100, y=rets * 100, mode="markers",
    marker=dict(size=4, color=sharpes, colorscale="Viridis", showscale=True,
                colorbar=dict(title="Sharpe"), opacity=0.6),
    name="Carteiras"))
fig.add_trace(go.Scatter(
    x=[risks[i_minvar] * 100], y=[rets[i_minvar] * 100], mode="markers",
    marker=dict(size=16, color=INSPER_TURQUESA, symbol="star"),
    name="Mín. variância"))
fig.add_trace(go.Scatter(
    x=[risks[i_maxsr] * 100], y=[rets[i_maxsr] * 100], mode="markers",
    marker=dict(size=16, color=INSPER_RED, symbol="star"),
    name="Máx. Sharpe (tangência)"))
fig.update_layout(
    title="Fronteira Eficiente por Monte Carlo (5000 carteiras)",
    xaxis_title="Risco diário (%)", yaxis_title="Retorno diário (%)",
    template="plotly_white", font_family="Inter",
    legend=dict(yanchor="top", y=0.99, xanchor="left", x=0.01))
fig.show()
```
```{python}
pesos_df = pd.DataFrame({
    "Mínima variância": pesos_minvar,
    "Máximo Sharpe": pesos_maxsr,
}, index=[nomes[a] for a in ativos])

fig = px.bar(pesos_df, barmode="group", template="plotly_white",
             title="Pesos das carteiras ótimas",
             labels={"value": "Peso", "index": "Ativo", "variable": "Carteira"},
             color_discrete_sequence=[INSPER_TURQUESA, INSPER_RED])
fig.update_layout(font_family="Inter", yaxis_tickformat=".0%")
fig.show()
```
## Parte 5: VaR do portfólio
Usamos a carteira de **mínima variância** e o `nu` (graus de liberdade) mais conservador
estimado pelos GARCHs. O VaR sai de um quantil da t de Student, reescalando pela variância
finita da distribuição.
```{python}
pesos_finais = pesos_minvar

rt_final = np.sum(vol_futuro.groupby("ticker")["serie"].first().reindex(ativos).values * pesos_finais)
sd_final = np.sqrt(pesos_finais @ cov_mat @ pesos_finais)

nu = float(vol_futuro["shape"].min())
valor_t = stats.t.ppf(0.95, nu)
VaR = rt_final + valor_t * sd_final / np.sqrt(nu / (nu - 2))

print(f"Retorno esperado da carteira (1 passo): {rt_final:.5f}")
print(f"Desvio-padrão da carteira: {sd_final:.5f}")
print(f"Graus de liberdade (nu) usados: {nu:.2f}")
print(f"VaR (95%): {VaR:.5f}  ->  {VaR * 100:.2f}% por dia")
```
::: {.callout-note}
## Como ler esse VaR
O VaR resume, num número só, "qual é uma perda plausível num dia ruim". Aqui ele usa a
cauda da t de Student (graus de liberdade baixos = caudas pesadas), então é mais
conservador que a normal. Repare que `nu` precisa ser maior que 2 para a variância existir;
com `nu` muito baixo, o termo `nu / (nu - 2)` infla bastante a cauda. Na aula de [VaR](../aulas/var.qmd) formalizamos
VaR paramétrico, histórico e Monte Carlo, além de Expected Shortfall.
:::
## Parte 6: CAPM e betas
Por fim, medimos a exposição ao mercado. O **beta** de cada ativo vem da regressão dos
retornos contra o Ibovespa (ou, de forma equivalente, `cov / var`). O beta da carteira é
a média ponderada dos betas pelos pesos.
```{python}
mkt = ret_bench.reindex(retornos.index).dropna()
idx = retornos.index.intersection(mkt.index)

# Beta individual via cov/var e via regressão (devem bater)
betas = {}
for a in ativos:
    r = retornos.loc[idx, a]
    betas[a] = np.cov(r, mkt.loc[idx])[0, 1] / np.var(mkt.loc[idx])

# Beta da carteira: regressão dos retornos do portfólio contra o Ibov
port_ret_series = (retornos.loc[idx] * pesos_finais).sum(axis=1)
X = sm.add_constant(mkt.loc[idx])
capm = sm.OLS(port_ret_series, X).fit()
beta_portfolio_ols = capm.params.iloc[1]
beta_portfolio_pond = sum(betas[a] * w for a, w in zip(ativos, pesos_finais))

tab_betas = pd.Series(betas, name="Beta").to_frame()
tab_betas.index = [nomes[a] for a in ativos]
tab_betas.round(3)
```
```{python}
print(f"Beta da carteira (regressão): {beta_portfolio_ols:.3f}")
print(f"Beta da carteira (média ponderada dos betas): {beta_portfolio_pond:.3f}")
print(f"Alpha diário (intercepto): {capm.params.iloc[0]:.5f}")
```
::: {.callout-important}
## A resposta da pergunta de negócio
Os betas dos FIIs costumam ficar **bem abaixo de 1**: eles se movem pouco com o Ibovespa.
Isso é exatamente o ponto de ter FIIs na carteira (descorrelação com a bolsa), e não um
sinal de mau investimento por si só. "Péssimo ou apenas ruim" depende do retorno
ajustado ao risco, não só do retorno absoluto. Na aula de [CAPM e Portfólios](../aulas/portfolios.qmd) formalizamos o CAPM e a leitura
de beta, alpha e a reta de mercado.
:::
# Dinâmica: Monte sua Carteira
::: {.callout-important}
## App interativo (Shiny for Python)
Agora é a vez de vocês. Em grupos, abram o app **Monte sua Carteira** e construam uma
carteira que façam sentido defender:
1. **Escolham** os ativos (os FIIs do lab e alguns blue-chips estão disponíveis).
2. **Mexam nos pesos** com os sliders e observem, ao vivo, onde a carteira cai na
fronteira eficiente.
3. **Comparem** retorno, volatilidade, Sharpe e VaR entre as carteiras testadas.
4. **Olhem** o backtest acumulado contra o Ibovespa e a matriz de correlação.
5. **Escolham uma carteira** para apresentar em 2 minutos: por que esses ativos, por que
esses pesos, e o que a fronteira/Sharpe/VaR dizem sobre ela.
O app roda **direto no navegador**, sem instalar nada: abram a página
[App: Monte sua Carteira](app-carteira.qmd). A primeira carga leva alguns segundos
(o Python sobe no navegador via shinylive) e os dados são de um catálogo de ativos da B3
já embarcado.
Para rodar local (mesmo app, sem a espera do shinylive), na pasta do repositório:
```bash
shiny run labs/app-carteira/app.py
```
O passo a passo e como atualizar o catálogo estão no `labs/app-carteira/README.md`.
:::
::: {.callout-tip}
## Ponte para o trabalho final
Essa dinâmica é a semente do **trabalho final**: nada impede que o grupo apresente
exatamente um app desses, adaptado aos ativos que vocês escolherem. Visualizar carteiras ao vivo costuma impressionar o comitê
muito mais que uma tabela estática.
:::