---
title: "Aula 2: Modelos ARIMA"
subtitle: "Identificação, estimação e diagnóstico"
format:
html:
code-fold: true
---
::: {.objetivos}
#### Objetivos de Aprendizagem
- **Formular** modelos AR, MA, ARMA e ARIMA a partir da notação matemática
- **Identificar** a ordem do modelo usando ACF/PACF e critérios de informação
- **Aplicar** o procedimento Box-Jenkins para modelagem de séries temporais
- **Avaliar** a qualidade do ajuste via diagnóstico residual
:::
## Relembrando: Onde Estamos
Na aula anterior, aprendemos a *descrever* séries temporais: componentes, ACF/PACF, estacionariedade. Agora vamos *modelar* — construir equações matemáticas que capturam a dinâmica da série e permitem fazer previsões.
A família ARIMA é a espinha dorsal da modelagem clássica de séries temporais. Ela combina três ingredientes: **autoregressão** (AR), **integração** (I — diferenciação) e **médias móveis** (MA). Vamos construir cada um do zero.
## Processo Autoregressivo: AR($p$)
### AR(1): A ideia fundamental
O modelo mais simples é o AR(1):
::: {.formula-highlight}
[AR(1)]{.formula-label}
$$Y_t = c + \phi_1 Y_{t-1} + \varepsilon_t$$
:::
Em palavras: o valor de hoje é uma **fração** ($\phi_1$) do valor de ontem, mais uma constante e um choque aleatório. É como um eco que vai enfraquecendo — se $|\phi_1| < 1$, cada choque se dissipa ao longo do tempo.
**Exemplo intuitivo**: a temperatura de amanhã depende fortemente da temperatura de hoje, mas com alguma variação aleatória. Se hoje está 30°C e $\phi_1 = 0.8$, esperamos algo próximo de $0.8 \times 30 = 24°C$ (mais a constante e ruído).
### AR($p$): Generalizando
Quando $p$ valores passados importam:
::: {.formula-highlight}
[AR($p$)]{.formula-label}
$$Y_t = c + \phi_1 Y_{t-1} + \phi_2 Y_{t-2} + \cdots + \phi_p Y_{t-p} + \varepsilon_t$$
:::
### Simulador interativo: AR($p$)
Ajuste os coeficientes e observe o comportamento da série e da ACF/PACF:
```{ojs}
//| echo: false
viewof ar_phi1 = Inputs.range([-0.99, 0.99], {
  value: 0.7, step: 0.01, label: "φ₁ (primeiro coeficiente AR):"
})

viewof ar_phi2 = Inputs.range([-0.99, 0.99], {
  value: 0.0, step: 0.01, label: "φ₂ (segundo coeficiente AR):"
})

viewof ar_seed = Inputs.button("Gerar outra realização", {value: 0, reduce: v => v + 1})
```
```{ojs}
//| echo: false
{
  const n = 300, maxLag = 20;
  const baseSeed = 77 + ar_seed * 137;

  // Verificar estacionariedade do AR(2)
  // Condições: |φ₂| < 1, φ₁ + φ₂ < 1, φ₂ - φ₁ < 1
  const isStationary = Math.abs(ar_phi2) < 1
    && ar_phi1 + ar_phi2 < 1
    && ar_phi2 - ar_phi1 < 1;

  function seededRandom(seed) {
    let s = seed;
    return function() {
      s = (s * 16807) % 2147483647;
      return (s - 1) / 2147483646;
    };
  }
  const rng = seededRandom(baseSeed);
  function bm() {
    const u1 = rng(), u2 = rng();
    return Math.sqrt(-2 * Math.log(u1)) * Math.cos(2 * Math.PI * u2);
  }

  const eps = d3.range(n).map(() => bm());
  let y = [0, 0];
  for (let i = 2; i < n; i++) {
    let val = ar_phi1 * y[i-1] + ar_phi2 * y[i-2] + eps[i];
    // Clamp para evitar explosão numérica se não-estacionário
    if (Math.abs(val) > 1e6) val = Math.sign(val) * 1e6;
    y.push(val);
  }

  // ACF amostral
  const mean = d3.mean(y);
  const vari = d3.mean(y.map(v => (v - mean)**2));
  const rho = d3.range(0, maxLag+1).map(k => {
    if (k === 0) return 1;
    let s = 0;
    for (let t = k; t < n; t++) s += (y[t]-mean)*(y[t-k]-mean);
    return s/(n*vari);
  });

  const acfData = d3.range(1, maxLag+1).map(k => ({lag: k, val: rho[k], tipo: "ACF"}));

  // PACF via algoritmo Levinson-Durbin (correto)
  const pacfData = [];
  let phi_prev = []; // coeficientes da iteração anterior

  for (let m = 1; m <= maxLag; m++) {
    if (m === 1) {
      const phi_mm = rho[1];
      pacfData.push({lag: m, val: phi_mm, tipo: "PACF"});
      phi_prev = [phi_mm];
    } else {
      // Calcular phi_mm
      let num = rho[m];
      for (let j = 0; j < m - 1; j++) {
        num -= phi_prev[j] * rho[m - 1 - j];
      }
      let den = 1;
      for (let j = 0; j < m - 1; j++) {
        den -= phi_prev[j] * rho[j + 1];
      }
      const phi_mm = Math.abs(den) > 1e-12 ? num / den : 0;
      pacfData.push({lag: m, val: phi_mm, tipo: "PACF"});

      // Atualizar coeficientes
      const phi_new = [];
      for (let j = 0; j < m - 1; j++) {
        phi_new.push(phi_prev[j] - phi_mm * phi_prev[m - 2 - j]);
      }
      phi_new.push(phi_mm);
      phi_prev = phi_new;
    }
  }

  const ci = 1.96 / Math.sqrt(n);
  const allBars = [...acfData, ...pacfData];

  const label = ar_phi2 === 0
    ? `AR(1): Y_t = ${ar_phi1.toFixed(2)} × Y_{t-1} + ε_t`
    : `AR(2): Y_t = ${ar_phi1.toFixed(2)} × Y_{t-1} + ${ar_phi2.toFixed(2)} × Y_{t-2} + ε_t`;

  const statusText = isStationary
    ? "✅ Processo estacionário"
    : "⚠️ Processo NÃO estacionário (pode explodir ou ter raiz unitária)";

  const seriesData = y.map((v,i) => ({t:i, value:v}));

  const sp = Plot.plot({
    width: 800, height: 180,
    marks: [
      Plot.lineY(seriesData, {x:"t", y:"value", stroke: isStationary ? "#E50505" : "#808080", strokeWidth:0.8}),
      Plot.ruleY([0], {stroke:"#ccc"})
    ],
    x:{label:"Tempo"}, y:{label:"Y(t)"},
    title: label,
    subtitle: statusText
  });

  const ap = Plot.plot({
    width: 800, height: 220,
    facet: {data: allBars, x: "tipo"},
    fx: {label: null},
    marks: [
      Plot.ruleY([0], {stroke:"#ccc"}),
      Plot.ruleY([ci], {stroke:"#E50505", strokeDasharray:"4,4", strokeOpacity:0.4}),
      Plot.ruleY([-ci], {stroke:"#E50505", strokeDasharray:"4,4", strokeOpacity:0.4}),
      Plot.barY(allBars, {x:"lag", y:"val",
        fill: d => Math.abs(d.val) > ci ? "#E50505" : "#5B5B5B"})
    ],
    x:{label:"Lag", tickFormat: d3.format("d")},
    y:{label:"Correlação", domain:[-1,1]}
  });

  const div = document.createElement("div");
  div.appendChild(sp);
  div.appendChild(ap);
  return div;
}
```
::: {.callout-tip}
## Experimente!
- Coloque $\phi_1 = 0.9, \phi_2 = 0$: observe a ACF decaindo lentamente e a PACF com **um único pico** no lag 1 → AR(1).
- Coloque $\phi_1 = 0.5, \phi_2 = 0.3$: PACF com **dois picos** significativos → AR(2).
- Coloque $\phi_1 = -0.7, \phi_2 = 0$: a ACF alterna sinais → AR(1) com coeficiente negativo.
:::
## Processo de Médias Móveis: MA($q$)
Enquanto o AR diz que o valor atual depende de valores *passados da série*, o MA diz que depende de *choques aleatórios passados*:
::: {.formula-highlight}
[MA($q$)]{.formula-label}
$$Y_t = c + \varepsilon_t + \theta_1 \varepsilon_{t-1} + \theta_2 \varepsilon_{t-2} + \cdots + \theta_q \varepsilon_{t-q}$$
:::
**Intuição**: imagine uma fila de dominós. Um choque (vento) derruba o primeiro, que derruba o segundo, etc. No MA(2), o efeito de cada choque dura exatamente 2 períodos e depois desaparece completamente. Isso é diferente do AR, onde o efeito decai gradualmente.
### Simulador: MA($q$)
```{ojs}
//| echo: false
viewof ma_theta1 = Inputs.range([-0.99, 0.99], {
  value: 0.7, step: 0.01, label: "θ₁ (primeiro coeficiente MA):"
})

viewof ma_theta2 = Inputs.range([-0.99, 0.99], {
  value: 0.0, step: 0.01, label: "θ₂ (segundo coeficiente MA):"
})

viewof ma_seed = Inputs.button("Gerar outra realização", {value: 0, reduce: v => v + 1})
```
```{ojs}
//| echo: false
{
  const n = 300, maxLag = 20;
  const baseSeed = 55 + ma_seed * 211;
  function seededRandom(seed) {
    let s = seed;
    return function() {
      s = (s * 16807) % 2147483647;
      return (s - 1) / 2147483646;
    };
  }
  const rng = seededRandom(baseSeed);
  function bm() {
    const u1 = rng(), u2 = rng();
    return Math.sqrt(-2 * Math.log(u1)) * Math.cos(2 * Math.PI * u2);
  }

  const eps = d3.range(n).map(() => bm());
  let y = eps.map((e, i) => {
    let val = e;
    if (i >= 1) val += ma_theta1 * eps[i-1];
    if (i >= 2) val += ma_theta2 * eps[i-2];
    return val;
  });

  const mean = d3.mean(y);
  const vari = d3.mean(y.map(v => (v-mean)**2));
  const acf = d3.range(1, maxLag+1).map(k => {
    let s = 0;
    for (let t = k; t < n; t++) s += (y[t]-mean)*(y[t-k]-mean);
    return {lag: k, val: s/(n*vari)};
  });

  const ci = 1.96 / Math.sqrt(n);

  const label = ma_theta2 === 0
    ? `MA(1): Y_t = ε_t + ${ma_theta1.toFixed(2)} × ε_{t-1}`
    : `MA(2): Y_t = ε_t + ${ma_theta1.toFixed(2)} × ε_{t-1} + ${ma_theta2.toFixed(2)} × ε_{t-2}`;

  const seriesData = y.map((v,i) => ({t:i, value:v}));

  const sp = Plot.plot({
    width: 800, height: 180,
    marks: [
      Plot.lineY(seriesData, {x:"t", y:"value", stroke:"#3ACC9F", strokeWidth:0.8}),
      Plot.ruleY([0], {stroke:"#ccc"})
    ],
    x:{label:"Tempo"}, y:{label:"Y(t)"},
    title: label
  });

  const ap = Plot.plot({
    width: 800, height: 220,
    marks: [
      Plot.ruleY([0], {stroke:"#ccc"}),
      Plot.ruleY([ci], {stroke:"#E50505", strokeDasharray:"4,4", strokeOpacity:0.4}),
      Plot.ruleY([-ci], {stroke:"#E50505", strokeDasharray:"4,4", strokeOpacity:0.4}),
      Plot.barY(acf, {x:"lag", y:"val",
        fill: d => Math.abs(d.val) > ci ? "#3ACC9F" : "#5B5B5B"})
    ],
    x:{label:"Lag", tickFormat: d3.format("d")},
    y:{label:"ACF", domain:[-1,1]},
    title: "ACF: observe o corte abrupto no MA"
  });

  const div = document.createElement("div");
  div.appendChild(sp);
  div.appendChild(ap);
  return div;
}
```
::: {.callout-tip}
## Observe o corte na ACF!
- MA(1) com $\theta_1 = 0.7$: a ACF tem **um único pico** significativo no lag 1 e depois cai para zero.
- MA(2): dois picos e depois zero.
- Isso é a assinatura do MA: a ACF **corta abruptamente** no lag $q$.
:::
## O "I" de ARIMA: Integração (Diferenciação)
O "I" não é um modelo separado — é uma **transformação**. Se a série tem raiz unitária ($d$ vezes), aplicamos $d$ diferenciações para torná-la estacionária, depois ajustamos um ARMA à série diferenciada.
::: {.formula-highlight}
[ARIMA($p, d, q$) — o que cada letra significa]{.formula-label}
| Letra | Significado | Determinado por |
|-------|-------------|-----------------|
| **AR($p$)** | $p$ lags autoregressivos | PACF da série diferenciada |
| **I($d$)** | $d$ diferenciações para estacionariedade | Testes ADF/KPSS |
| **MA($q$)** | $q$ lags de média móvel | ACF da série diferenciada |
:::
::: {.formula-highlight}
[ARIMA($p,d,q$) — forma compacta com operador de defasagem]{.formula-label}
$$\phi(B)(1-B)^d Y_t = c + \theta(B)\varepsilon_t$$
:::
onde $B$ é o operador de defasagem ($BY_t = Y_{t-1}$), $\phi(B) = 1 - \phi_1 B - \cdots - \phi_p B^p$ e $\theta(B) = 1 + \theta_1 B + \cdots + \theta_q B^q$.
::: {.callout-note}
## E a sazonalidade?
Séries com **sazonalidade** (vendas mensais, PIB trimestral, demanda de energia) pedem uma extensão do ARIMA — o **SARIMA** — que adiciona um segundo bloco de operadores $(P,D,Q)_s$. Veremos isso na **Aula 3**, junto com o **Prophet**.
:::
## Polinômios de Defasagem e Raízes Características
Acima já usamos o operador de defasagem $B$ (também denotado $L$ em muitos textos) na forma compacta do ARIMA. Essa notação é mais do que um atalho: ela permite caracterizar **estacionariedade** geometricamente, via as raízes dos polinômios AR e MA. Recapitulando,
$$L Y_t = Y_{t-1}, \qquad L^k Y_t = Y_{t-k}$$
e definimos dois **polinômios de defasagem**:
::: {.formula-highlight}
[Polinômios AR e MA]{.formula-label}
$$\Phi(L) = 1 - \phi_1 L - \phi_2 L^2 - \cdots - \phi_p L^p$$
$$\Theta(L) = 1 + \theta_1 L + \theta_2 L^2 + \cdots + \theta_q L^q$$
:::
Com essa notação, um **ARMA($p,q$)** escreve-se como
$$\Phi(L)\, Y_t = c + \Theta(L)\, \varepsilon_t,$$
e um **ARIMA($p,d,q$)** fica simplesmente
$$\Phi(L)\, (1-L)^d\, Y_t = c + \Theta(L)\, \varepsilon_t,$$
onde $(1-L)$ é o operador de diferenciação: $(1-L) Y_t = Y_t - Y_{t-1} = \Delta Y_t$.
### Condição de estacionariedade via raízes
A grande vantagem dessa notação é que a **estacionariedade** do processo AR fica caracterizada pelas raízes do polinômio característico:
::: {.conceito-card}
#### Condição de estacionariedade
Um AR($p$) é estacionário se, e somente se, **todas as raízes** de $\Phi(z) = 0$ (vistas como equação em $z \in \mathbb{C}$) estão **fora do círculo unitário**, isto é, $|z| > 1$.
:::
**Casos concretos**:
- **AR(1)**: $\Phi(z) = 1 - \phi_1 z$; raiz em $z = 1/\phi_1$. Fora do círculo unitário ⟺ $|\phi_1| < 1$.
- **AR(2)**: $\Phi(z) = 1 - \phi_1 z - \phi_2 z^2$; as duas raízes devem ter módulo $> 1$, o que equivale a $\phi_1 + \phi_2 < 1$, $\phi_2 - \phi_1 < 1$ e $|\phi_2| < 1$ (as mesmas condições usadas no simulador acima).
- **Raiz unitária**: quando $\Phi(1) = 0$ (uma raiz exatamente em $z = 1$), o processo tem **raiz unitária** e é **não-estacionário** — é o caso da random walk e a motivação para o operador $(1-L)$.
O teste ADF, que usaremos para determinar $d$, é literalmente um teste de hipótese sobre a existência de uma raiz em $z = 1$.
## Procedimento Box-Jenkins
O método Box-Jenkins é o procedimento sistemático para modelagem ARIMA:
```{mermaid}
flowchart TD
    A["<b>1. IDENTIFICAÇÃO</b><br/>Testes de estacionariedade → d, D<br/>ACF/PACF → candidatos p, q, P, Q"] --> B["<b>2. ESTIMAÇÃO</b><br/>MLE dos parâmetros<br/>Critérios de informação (AICc)"]
    B --> C["<b>3. DIAGNÓSTICO</b><br/>Resíduos = ruído branco?<br/>Ljung-Box, ACF residual"]
    C --> D{Resíduos OK?}
    D -->|Não| A
    D -->|Sim| E["<b>4. PREVISÃO</b><br/>Forecast h passos à frente<br/>Intervalos de confiança"]

    style A fill:#E50505,color:#fff
    style B fill:#FFCC00,color:#000
    style C fill:#3ACC9F,color:#fff
    style E fill:#730D9F,color:#fff
```
### Etapa 1: Identificação
1. **Verifique estacionariedade** (ADF + KPSS) → determina $d$ e $D$
2. **Diferencie** se necessário
3. **Examine ACF/PACF** da série diferenciada para identificar $p$, $q$, $P$, $Q$
### Etapa 2: Estimação
Os parâmetros são estimados por **máxima verossimilhança** (MLE). Compare modelos candidatos via **AICc**:
| Critério | Fórmula | Uso |
|----------|---------|-----|
| **AIC** | $-2\log L + 2k$ | Foco em previsão |
| **AICc** | $AIC + \frac{2k(k+1)}{n-k-1}$ | Correção para amostras pequenas — **use este** |
| **BIC** | $-2\log L + k\log n$ | Penaliza mais complexidade |
#### Quando é legítimo comparar modelos por esses critérios?
Todos os critérios acima dependem da **log-verossimilhança** $\log L$ avaliada sobre o **mesmo conjunto de dados**. Isso define de forma estrita quando a comparação faz sentido — e quando não faz.
::: {.callout-important}
## Regra de ouro
Você só pode comparar dois modelos por AIC/AICc/BIC se **a variável resposta for exatamente a mesma** — mesmas observações, mesma escala, mesma transformação. Trocar o **modelo** é permitido; trocar os **dados** não é.
:::
**❌ Situações em que a comparação NÃO vale**
- Comparar um ARIMA(1,0,0) ajustado em $Y_t$ com um ARIMA(1,1,0) ajustado em $\Delta Y_t$: as séries têm **tamanhos e escalas diferentes**, e a verossimilhança de cada modelo é computada sobre objetos distintos. Entre modelos com diferentes valores de $d$, o AIC **não é comparável**. O caminho correto é fixar $d$ pelos testes de raiz unitária e só depois comparar $(p,q)$ via AIC.
- Comparar um modelo em $Y_t$ com outro em $\log Y_t$: o jacobiano da transformação muda a verossimilhança. Para comparar, é preciso corrigir a log-verossimilhança pelo jacobiano.
- Comparar modelos ajustados em **amostras diferentes** (janelas temporais distintas, subconjuntos filtrados de formas diferentes).
**✅ Situações em que a comparação vale**
- **Modelos encaixados** (nested), como ARIMA(1,1,1) vs ARIMA(2,1,2): mesmo $d$, mesma série, mudam apenas os parâmetros estimados. AIC/BIC são exatamente o ferramental certo aqui.
- **Modelos não-encaixados mas sobre os mesmos dados**: ARIMA(1,1,1) vs ARIMA(0,1,2) — também ok.
- **Mudança na distribuição da variável resposta**: por exemplo, comparar um GARCH(1,1) com erros Normais contra um GARCH(1,1) com erros $t$-Student (Aula 5). Os dados são os mesmos; o que muda é a família distribucional usada para calcular $\log L$. Aqui o AIC/BIC é **o instrumento correto** para decidir qual distribuição se ajusta melhor, penalizando o parâmetro extra ($\nu$) que a $t$ introduz.
#### Por que AIC e não validação cruzada diretamente?
Uma pergunta natural é: se o objetivo é prever bem, por que não usar **validação cruzada** (CV) e pular toda essa história de critérios de informação? Três razões:
1. **Custo computacional**: CV exige ajustar o modelo $k$ vezes (ou $n$ vezes em LOOCV), enquanto AIC é calculado **uma única vez** a partir do ajuste MLE padrão.
2. **Dependência temporal**: em séries temporais, CV não é trivial — embaralhar observações quebra a ordem temporal. É preciso usar variantes como *rolling origin* (que veremos na Aula 4), que são mais caras.
3. **Equivalência assintótica**: sob condições gerais, **AIC é assintoticamente equivalente ao LOOCV**. Esse é o resultado clássico de Stone (1977): para modelos ajustados por máxima verossimilhança, minimizar AIC e minimizar o erro de predição de LOOCV convergem para a mesma escolha de modelo quando $n \to \infty$. Em outras palavras, **usar AIC já é, de certa forma, fazer LOOCV — só que de graça, analiticamente**.
::: {.callout-tip}
## AIC vs. BIC: para que serve cada um
- **AIC / AICc** → minimiza erro de previsão esperado (conexão com LOOCV). Use quando o objetivo é **prever bem**.
- **BIC** → consistente para seleção do "verdadeiro" modelo, assumindo que ele está entre os candidatos. Use quando o objetivo é **descobrir a estrutura correta**.
Os dois podem discordar: BIC tende a escolher modelos mais **parcimoniosos** que AIC, especialmente com $n$ grande ($\log n > 2$). Na prática de previsão, **prefira AICc**.
:::
**Referência**: Stone, M. (1977). *An Asymptotic Equivalence of Choice of Model by Cross-Validation and Akaike's Criterion*. Journal of the Royal Statistical Society. Series B, 39(1), 44–47. Uma discussão moderna e acessível está em Hyndman & Athanasopoulos, *Forecasting: Principles and Practice* (3ª ed.), seção 5.5.
### Etapa 3: Diagnóstico
::: {.conceito-card}
#### O que verificar nos resíduos?
Se o modelo está correto, os resíduos devem se comportar como **ruído branco**:
1. **Média zero**: $E[\hat{\varepsilon}_t] = 0$
2. **Variância constante**: sem padrões no gráfico de resíduos
3. **Sem autocorrelação**: ACF dos resíduos dentro das bandas de confiança
4. **Teste de Ljung-Box**: teste formal para "conjunto" de autocorrelações
:::
::: {.formula-highlight}
[Estatística de Ljung-Box]{.formula-label}
$$Q = n(n+2) \sum_{k=1}^{h} \frac{\hat{\rho}_k^2}{n-k}$$
:::
$H_0$: resíduos são ruído branco. Se p-valor $< 0.05$, rejeitamos — o modelo precisa ser revisado.
::: {.callout-note}
## Correção de graus de liberdade
Quando o Ljung-Box é aplicado a resíduos de um ARIMA($p,d,q$) com $m = p + q$ parâmetros estimados, a distribuição **não** é $\chi^2_h$, mas sim $\chi^2_{h - m}$. Intuição: cada parâmetro estimado "consome" um grau de liberdade. Isso torna o teste mais **conservador** — mais difícil rejeitar. Muitas implementações fazem essa correção automaticamente quando você informa o número de parâmetros estimados; confira o argumento `model_df` da sua biblioteca.
:::
### Seleção Automática vs. Manual
::: {.grid}
::: {.g-col-6}
#### Automática (`AutoARIMA`)
- Testa combinações de $(p,d,q)$
- Usa AICc para selecionar
- Rápida e consistente
- **Risco**: pode escolher modelo "bom numericamente" mas sem sentido para o negócio
:::
::: {.g-col-6}
#### Manual (Box-Jenkins)
- Você analisa ACF/PACF
- Escolhe candidatos fundamentados
- Compara via AICc + diagnóstico
- **Vantagem**: entendimento profundo; detecta problemas que o automático ignora
:::
:::
::: {.callout-important}
## Mensagem Central
A seleção automática é uma **ferramenta**, não uma **resposta**. Sempre faça o diagnóstico e pergunte: *este modelo faz sentido para o problema de negócios?* O `AutoARIMA` não sabe que sua série é de vendas, que dezembro é especial, ou que houve uma greve em março.
:::
### Como funciona o `AutoARIMA`
O `AutoARIMA` do `statsforecast` (baseado no algoritmo de Hyndman-Khandakar) segue estes passos internamente:
```{mermaid}
flowchart LR
    A["Heurística STL<br/>sazonal → D"] --> B["KPSS na série<br/>já diferenciada<br/>sazonalmente → d"]
    B --> C["Modelo inicial<br/>stepwise"]
    C --> D["Variações ±1<br/>em p, q, P, Q"]
    D --> E{AICc<br/>melhorou?}
    E -->|Sim| D
    E -->|Não| F["Melhor ARIMA"]

    style A fill:#E50505,color:#fff
    style F fill:#3ACC9F,color:#fff
```
1. **Determina $D$ primeiro** (se $s > 1$) com a heurística sazonal padrão (`test="seas"`): aplica uma decomposição STL e mede a **força sazonal** $F_s = \max\{0,\, 1 - \mathrm{Var}(R_t)/\mathrm{Var}(R_t + S_t)\}$; se $F_s > 0{,}64$, aplica $\Delta_s$ e repete até $D = \max\_D$ (default 1). Esse limiar de 0,64 vem de Wang, Smith & Hyndman (2006).
2. **Determina $d$ depois**, via KPSS sobre a série **já diferenciada sazonalmente** $\Delta_s^{D} Y_t$ (máximo 2 diferenciações regulares).
3. **Busca stepwise**: começa com modelos simples e varia $p, q, P, Q$ em ±1, mantendo o que reduz AICc.
4. **Retorna o melhor** segundo AICc.
::: {.callout-important}
## Por que a ordem $D \to d$ importa
A diferenciação sazonal $\Delta_s$ frequentemente **já remove parte da tendência** (porque $Y_t - Y_{t-s}$ elimina componentes que variam suavemente em horizonte maior que $s$). Por isso o algoritmo aplica `nsdiffs` **antes** de `ndiffs` — testar a estacionariedade regular numa série que ainda carrega sazonalidade estocástica leva a KPSS confundir o ciclo sazonal com tendência e a um $d$ inflado. A regra prática é a mesma na análise manual: **primeiro remova a sazonalidade, depois decida se ainda falta diferenciar regularmente**.
:::
::: {.callout-tip}
## Como deve ser a análise descritiva de uma série sazonal
Antes de rodar `AutoARIMA`, faça (nesta ordem):
1. **Plot da série completa** — identifique se há sazonalidade visível e qual o período $s$ (12 para mensal anual, 4 para trimestral, 7 para diária semanal, 24 para horária diária).
2. **Decomposição STL** — rode a decomposição e olhe o gráfico: a componente sazonal é nítida e regular? A tendência é clara? Isso já dá um diagnóstico visual da força de cada componente.
3. **Boxplot por unidade do ciclo** (mês, trimestre, dia da semana) — observe se a amplitude sazonal é estável ou cresce com o nível da série.
4. **ACF da série original** — picos persistentes em $s, 2s, 3s, \ldots$ que decaem lentamente são assinatura de sazonalidade estocástica (requer $\Delta_s$).
5. **ACF/PACF de $\Delta_s Y_t$ + teste de raiz unitária** — depois da diferença sazonal, rode um **KPSS** ou **ADF** para decidir objetivamente se ainda falta diferenciar regularmente, e use a ACF/PACF para identificar $(p, q, P, Q)$.
Essa é a ordem que o `AutoARIMA` também segue.
:::
::: {.callout-note}
## Heurística vs. teste estatístico para $D$
O default do `statsforecast` (`test="seas"`) **não é um teste estatístico** — é a heurística de força sazonal de Wang, Smith & Hyndman (2006), baseada em STL e com corte fixo em 0,64. Vantagens: rápida, robusta a séries curtas e a períodos não-inteiros. Limitação: não dá $p$-valor.
Alternativas via `seasonal_test_kwargs`:
- `test="ocsb"` — teste **OCSB** (Osborn, Chui, Smith & Birchenhall, 1988): regressão auxiliar com termos $\Delta_s$ e $\Delta$, testa se o coeficiente sazonal é zero. Único teste estatístico genuíno implementado; nível de significância fixo em 5%.
- `test="hegy"` e `test="ch"` (Canova-Hansen) — listados na assinatura mas **não implementados** (lançam `NotImplementedError`).
Para a maioria dos casos práticos a heurística basta; use OCSB quando precisar de evidência inferencial sobre a presença de raiz unitária sazonal.
:::
**Referências:**
- Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. *Journal of Statistical Software*, 27(3). DOI: [10.18637/jss.v027.i03](https://doi.org/10.18637/jss.v027.i03)
- Wang, X., Smith, K. A., & Hyndman, R. J. (2006). Characteristic-based clustering for time series data. *Data Mining and Knowledge Discovery*, 13(3), 335–364. DOI: [10.1007/s10618-005-0039-x](https://doi.org/10.1007/s10618-005-0039-x)
- Osborn, D. R., Chui, A. P. L., Smith, J. P., & Birchenhall, C. R. (1988). Seasonality and the order of integration for consumption. *Oxford Bulletin of Economics and Statistics*, 50(4), 361–377.
::: {.callout-warning}
## Armadilhas do AutoARIMA
1. **Não testa todos os modelos** — a busca stepwise pode perder o ótimo global. Se suspeitar, compare com candidatos manuais.
2. **Ignora o contexto** — não sabe que houve COVID, greve, mudança de política. Intervenções (dummies) devem ser adicionadas manualmente.
3. **Foco em AICc** — otimiza fit in-sample, não necessariamente performance out-of-sample. Sempre valide com cross-validation temporal.
4. **Não verifica diagnóstico** — pode retornar um modelo cujos resíduos ainda têm autocorrelação. Sempre cheque o Ljung-Box.
:::
### Exemplo prático: `AutoARIMA` na Selic
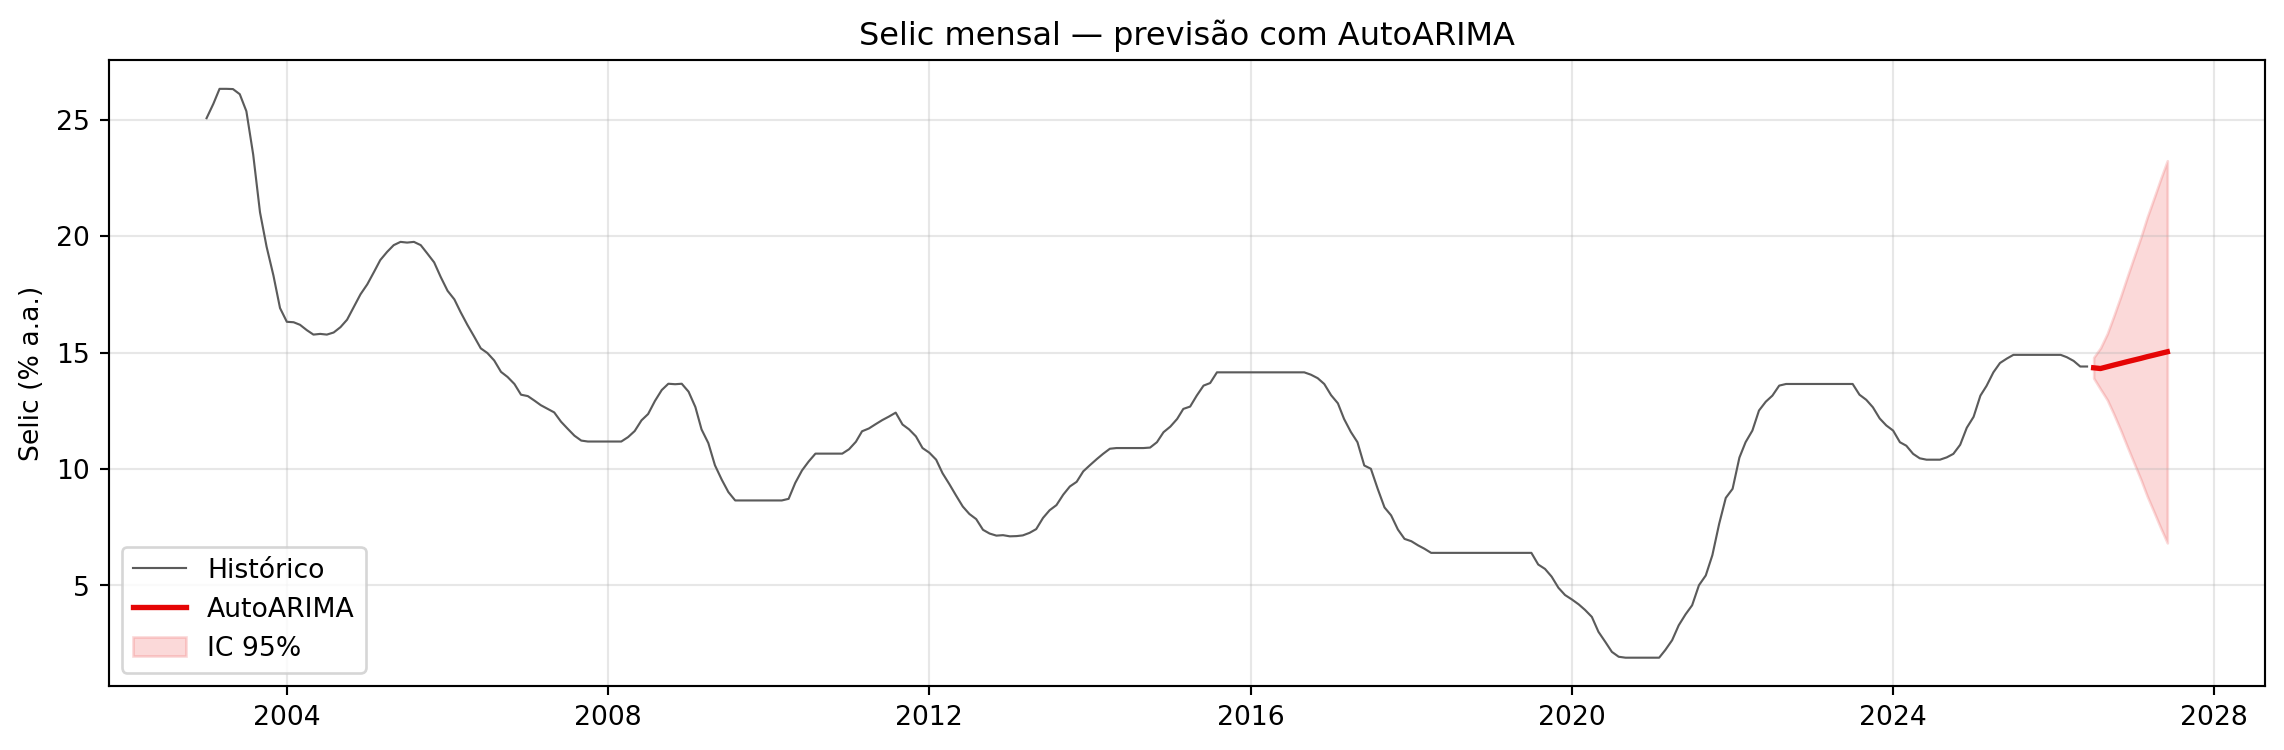
Vamos aplicar `AutoARIMA` do `statsforecast` (Nixtla) à **taxa Selic mensal** (série 4189 no SGS/BCB) — uma série não-sazonal, ideal para ARIMA puro:
```{python}
#| code-fold: true
from bcb import sgs
from statsforecast import StatsForecast
from statsforecast.models import AutoARIMA

# 1) Dados: Selic mensal (% a.a.)
selic = sgs.get({'selic': 4189}, start='2003-01-01').rename_axis('ds').reset_index()
selic['unique_id'] = 'selic'
selic = selic.rename(columns={'selic': 'y'})[['unique_id', 'ds', 'y']]

# 2) AutoARIMA (sem sazonalidade: season_length=1)
sf = StatsForecast(models=[AutoARIMA(season_length=1)], freq='MS', n_jobs=1)
sf.fit(df=selic)

# 3) Modelo escolhido + coeficientes
fitted = sf.fitted_[0, 0]
print("Modelo selecionado:")
print(fitted.model_['arma'])  # (p, q, P, Q, s, d, D)
print(f"\nAICc: {fitted.model_['aicc']:.2f}")
print(f"Ordem (p,d,q): ({fitted.model_['arma'][0]}, {fitted.model_['arma'][5]}, {fitted.model_['arma'][1]})")
```
```{python}
#| code-fold: true
import matplotlib.pyplot as plt

# 4) Previsão 12 meses
forecast = sf.forecast(df=selic, h=12, level=[80, 95])

fig, ax = plt.subplots(figsize=(12, 4))
ax.plot(selic['ds'], selic['y'], color='#5B5B5B', linewidth=0.8, label='Histórico')
ax.plot(forecast['ds'], forecast['AutoARIMA'], color='#E50505', linewidth=2, label='AutoARIMA')
ax.fill_between(forecast['ds'],
                forecast['AutoARIMA-lo-95'], forecast['AutoARIMA-hi-95'],
                alpha=0.15, color='#E50505', label='IC 95%')
ax.set_title('Selic mensal — previsão com AutoARIMA')
ax.set_ylabel('Selic (% a.a.)'); ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout(); plt.show()
```
::: {.callout-tip}
## Interpretando o resultado
Após o ajuste, inspecione qual modelo foi escolhido (o atributo `arma` retorna `(p, q, P, Q, s, d, D)`). Compare com sua análise visual de ACF/PACF — eles concordam? Se não, investigue por quê. Em séries de taxa de juros, é comum o `AutoARIMA` escolher algo próximo de ARIMA(1,1,1) — alta persistência + quebras estruturais (mudança de regime monetário).
:::
### Diagnóstico dos resíduos na prática
Ajustar o modelo é metade do trabalho. **Um modelo só é confiável se os resíduos forem ruído branco** — caso contrário, ainda há estrutura na série que o modelo não capturou, e as previsões (e seus intervalos de confiança) estarão erradas. Vamos extrair os resíduos do modelo da Selic e fazer o diagnóstico completo.
#### Passo 1 — Extrair os resíduos
O resíduo é a diferença entre o valor observado e o valor que o modelo previa *um passo à frente* (in-sample): $\hat{\varepsilon}_t = y_t - \hat{y}_{t\mid t-1}$. No `statsforecast`, passamos `fitted=True` e recuperamos os valores ajustados:
```{python}
#| code-fold: true
import numpy as np

# Reajusta pedindo os valores in-sample (fitted)
sf.forecast(df=selic, h=12, fitted=True)
insample = sf.forecast_fitted_values()

# Resíduo = observado - ajustado (1 passo à frente)
insample['resid'] = insample['y'] - insample['AutoARIMA']
resid = insample['resid'].dropna()

# Ordem do modelo escolhido: arma = (p, q, P, Q, s, d, D)
p, q = fitted.model_['arma'][0], fitted.model_['arma'][1]
m = p + q  # nº de parâmetros ARMA estimados (entra na correção do Ljung-Box)
print(f"Modelo: ARIMA(p={p}, d={fitted.model_['arma'][5]}, q={q})  →  m = p+q = {m}")
print(f"Resíduos: n={len(resid)}, média={resid.mean():.4f}, desvio={resid.std():.4f}")
```
A **média próxima de zero** é o primeiro sinal positivo: o modelo não tem viés sistemático.
#### Passo 2 — Os quatro gráficos de diagnóstico
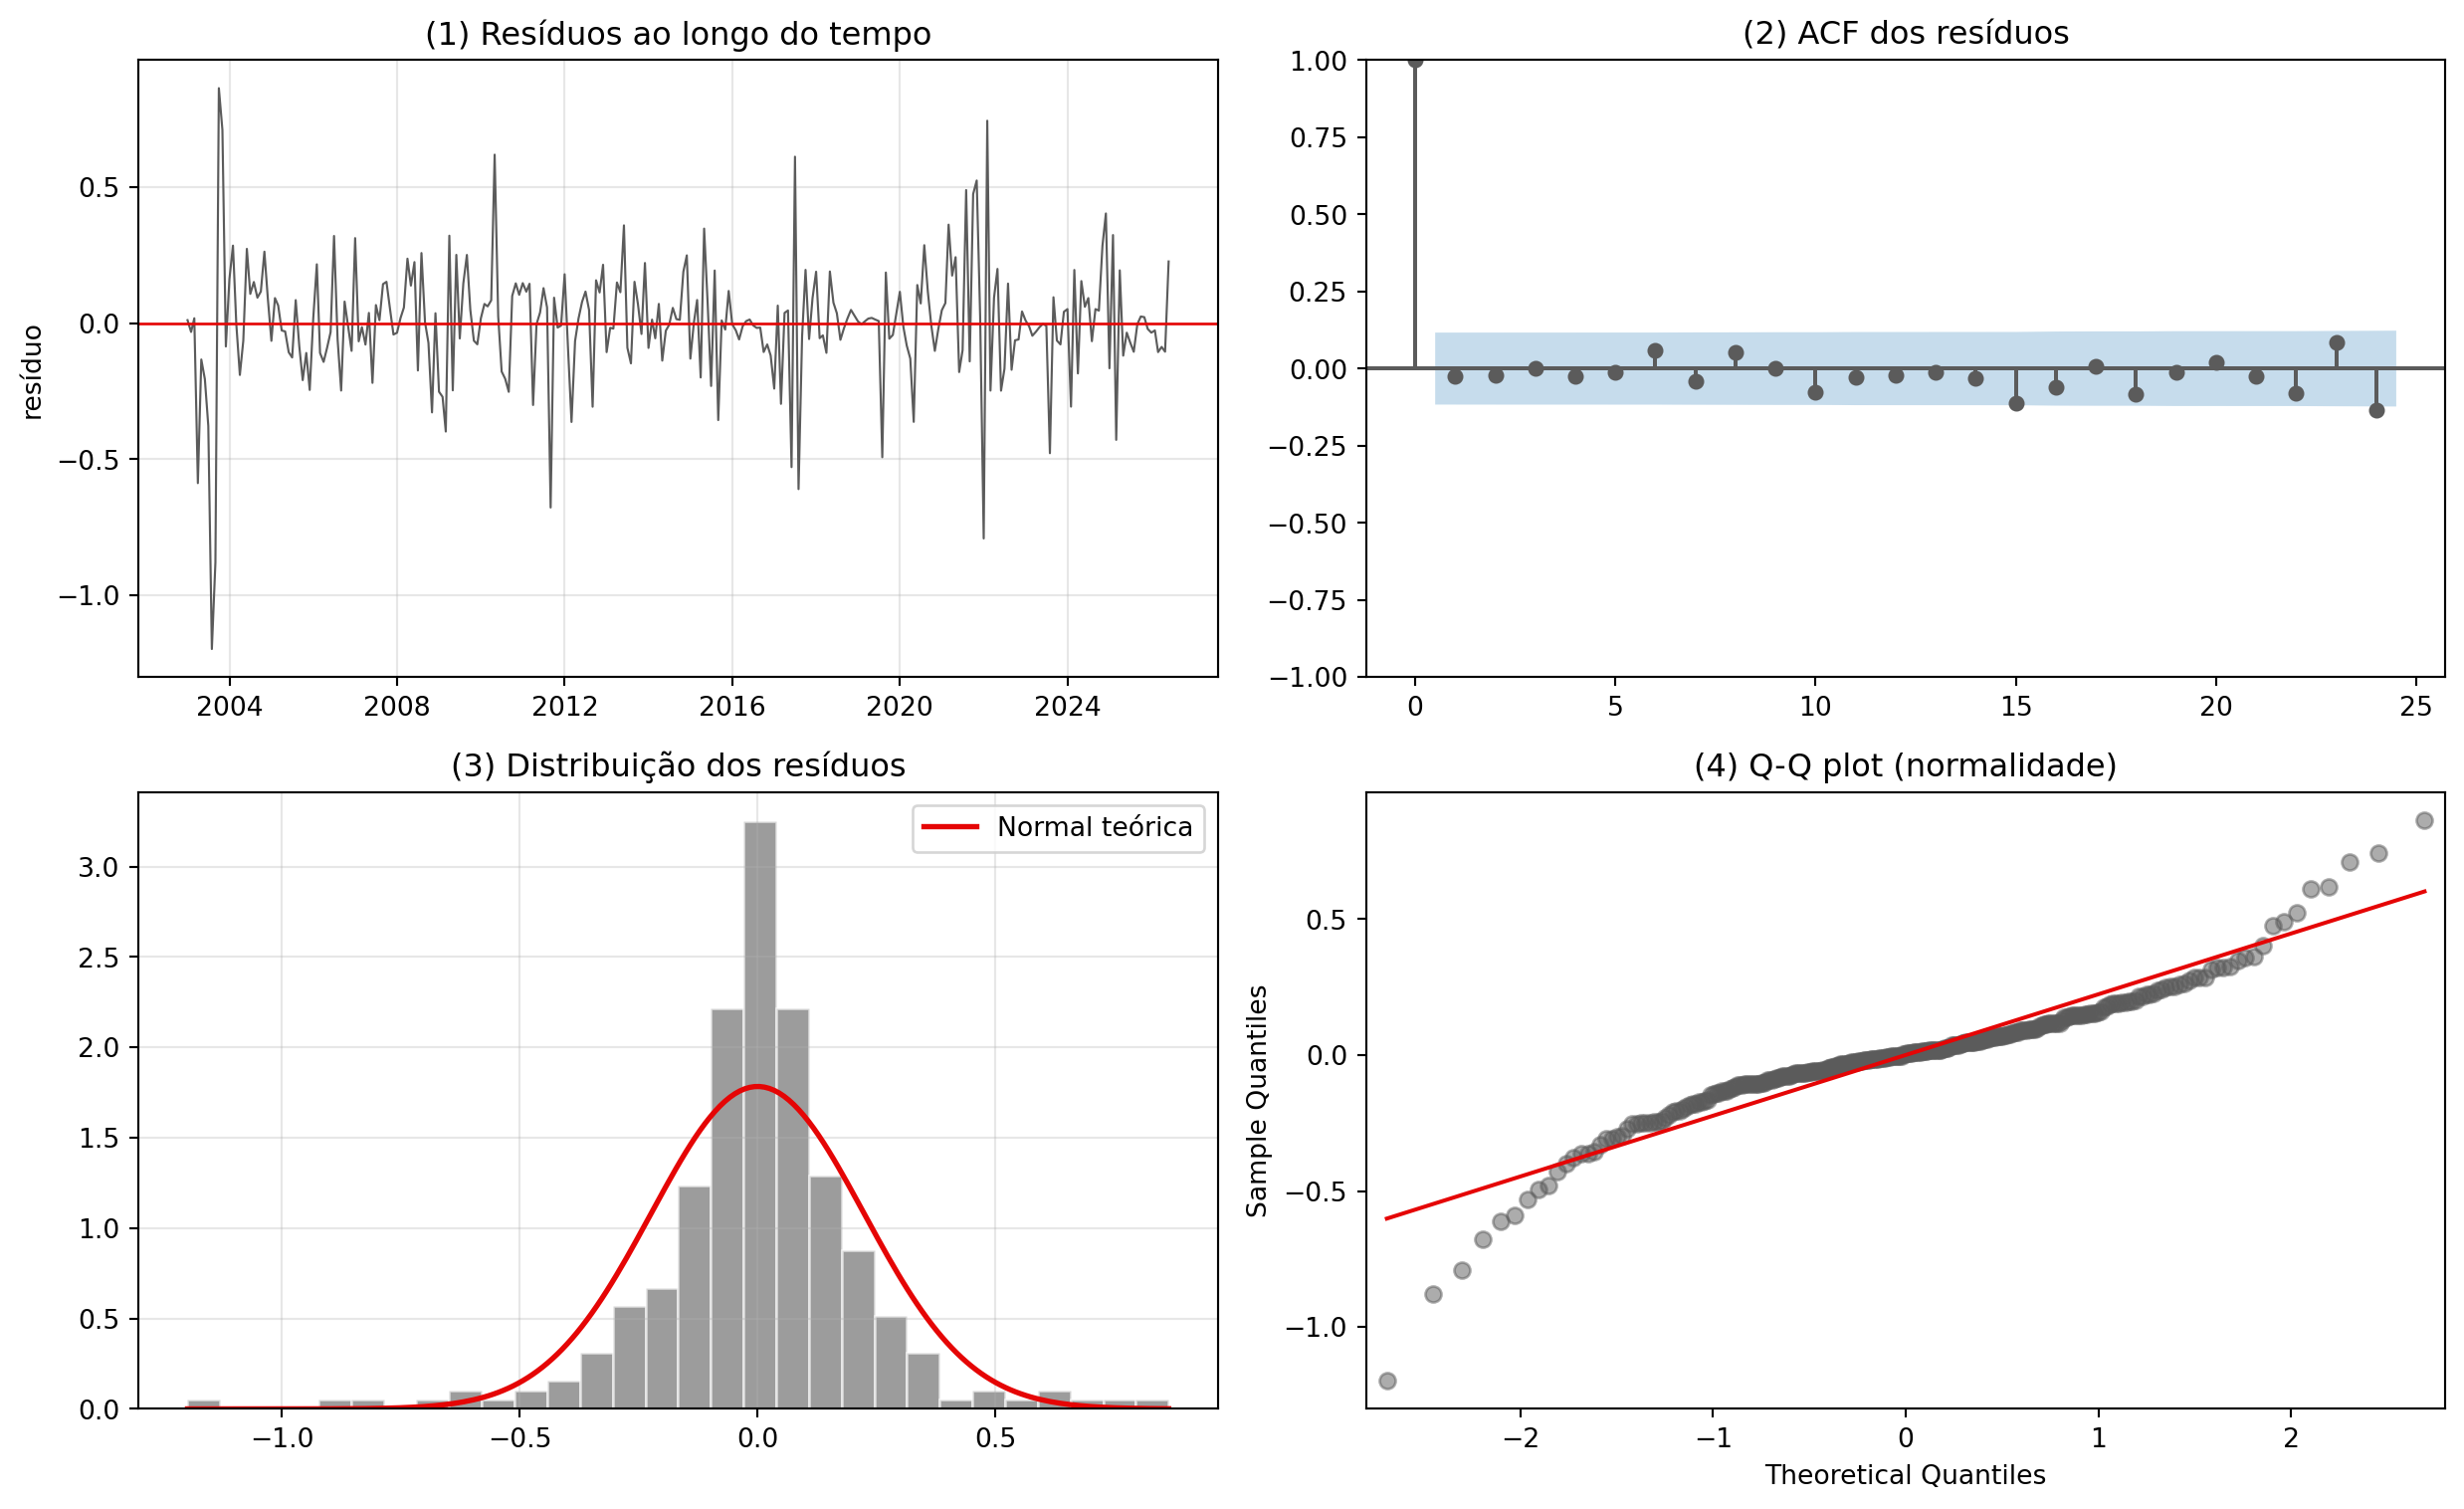
O painel padrão (equivalente ao `checkresiduals()` do R) tem quatro vistas. Cada uma testa uma das hipóteses de ruído branco:
```{python}
#| code-fold: true
#| fig-cap: "Diagnóstico de resíduos do AutoARIMA na Selic. Se o modelo está correto, os resíduos não devem ter padrão temporal, a ACF deve ficar dentro das bandas, e o histograma/Q-Q devem ser aproximadamente normais."
import matplotlib.pyplot as plt
from statsmodels.graphics.tsaplots import plot_acf
from statsmodels.graphics.gofplots import qqplot

fig, axes = plt.subplots(2, 2, figsize=(13, 8))

# (1) Resíduos no tempo — checa média zero e variância constante
axes[0, 0].plot(insample['ds'], insample['resid'], color='#5B5B5B', lw=0.8)
axes[0, 0].axhline(0, color='#E50505', lw=1)
axes[0, 0].set_title('(1) Resíduos ao longo do tempo')
axes[0, 0].set_ylabel('resíduo'); axes[0, 0].grid(alpha=0.3)

# (2) ACF dos resíduos — checa ausência de autocorrelação
plot_acf(resid, lags=24, ax=axes[0, 1], color='#5B5B5B',
         vlines_kwargs={'colors': '#5B5B5B'})
axes[0, 1].set_title('(2) ACF dos resíduos')

# (3) Histograma + densidade normal — checa normalidade
axes[1, 0].hist(resid, bins=30, density=True, color='#5B5B5B',
                alpha=0.6, edgecolor='white')
x = np.linspace(resid.min(), resid.max(), 200)
axes[1, 0].plot(x, (1/(resid.std()*np.sqrt(2*np.pi))) *
                np.exp(-0.5*((x-resid.mean())/resid.std())**2),
                color='#E50505', lw=2, label='Normal teórica')
axes[1, 0].set_title('(3) Distribuição dos resíduos')
axes[1, 0].legend(); axes[1, 0].grid(alpha=0.3)

# (4) Q-Q plot — checa normalidade nas caudas
qqplot(resid, line='s', ax=axes[1, 1], markerfacecolor='#5B5B5B',
       markeredgecolor='#5B5B5B', alpha=0.5)
axes[1, 1].get_lines()[1].set_color('#E50505')
axes[1, 1].set_title('(4) Q-Q plot (normalidade)')

plt.tight_layout(); plt.show()
```
**Como ler cada painel:**
| Painel | Hipótese testada | Sinal de problema |
|--------|------------------|-------------------|
| (1) Resíduos no tempo | média zero, variância constante | tendência, "funil" (variância crescente), aglomeração de volatilidade |
| (2) ACF dos resíduos | sem autocorrelação | qualquer pico fora das bandas azuis (sobretudo nos primeiros lags ou nos lags sazonais) |
| (3) Histograma | normalidade | forte assimetria, bimodalidade |
| (4) Q-Q plot | normalidade nas caudas | pontos fugindo da reta vermelha nas pontas (caudas pesadas) |
#### Passo 3 — Teste formal de Ljung-Box
O olho humano é ruim para julgar "essa autocorrelação é grande o suficiente?". O **teste de Ljung-Box** formaliza isso, testando *conjuntamente* várias autocorrelações de uma vez. Lembre da correção de graus de liberdade: como estimamos $m = p+q$ parâmetros, informamos `model_df=m` para o teste usar $\chi^2_{h-m}$:
```{python}
#| code-fold: true
from statsmodels.stats.diagnostic import acorr_ljungbox

lb = acorr_ljungbox(resid, lags=[10, 15, 20], model_df=m)
lb.index.name = 'lag (h)'
print(lb.round(4))

alpha = 0.05
if (lb['lb_pvalue'] > alpha).all():
    print(f"\n✓ Todos os p-valores > {alpha}: NÃO rejeitamos H0.")
    print("  Os resíduos são compatíveis com ruído branco — modelo aprovado.")
else:
    print(f"\n✗ Algum p-valor < {alpha}: rejeitamos H0.")
    print("  Há autocorrelação remanescente — volte à etapa de identificação.")
```
::: {.callout-important}
## Como interpretar o resultado
- **$H_0$: os resíduos são ruído branco** (sem autocorrelação).
- **p-valor alto (> 0,05)** → *não* rejeitamos $H_0$ → o modelo "limpou" a estrutura da série. **Esse é o resultado que queremos.**
- **p-valor baixo (< 0,05)** → rejeitamos $H_0$ → ainda há autocorrelação. O modelo está mal especificado: volte à Etapa 1, olhe a ACF dos resíduos (painel 2) para ver *onde* estão os picos e teste ordens alternativas (ex.: aumentar $p$ ou $q$, ou incluir termos sazonais → SARIMA).
Note a aparente inversão da lógica usual de testes: aqui um p-valor **alto** é a *boa* notícia, porque a hipótese nula é exatamente o que desejamos (resíduos sem estrutura).
:::
::: {.callout-warning}
## Normalidade é desejável, não obrigatória
A estimação por máxima verossimilhança e os **intervalos de previsão** assumem resíduos normais. Se o Q-Q plot mostra caudas pesadas (comum em séries financeiras), as previsões pontuais continuam válidas, mas os **intervalos de confiança ficam subestimados** — eles serão mais estreitos do que deveriam. Já a **autocorrelação remanescente (Ljung-Box)** é um problema grave: invalida tanto as previsões quanto os intervalos. Priorize sempre, nesta ordem: (1) sem autocorrelação, (2) variância constante, (3) normalidade.
:::
## ARIMAX: Quando Há Variáveis Externas
Muitas vezes a previsão melhora ao incluir **variáveis exógenas** (exógenas = determinadas fora do modelo): um preço pode depender do dólar, as vendas de uma loja podem depender de campanhas de marketing, o consumo de energia da temperatura. Dois caminhos possíveis:
### Caminho 1: regressão linear com erros ARMA
::: {.formula-highlight}
[Regressão com erros ARMA]{.formula-label}
$$Y_t = \boldsymbol{\beta}^\top \mathbf{x}_t + \eta_t, \qquad \Phi(L)\, \eta_t = \Theta(L)\, \varepsilon_t$$
:::
Interpretação limpa: primeiro explicamos $Y_t$ por variáveis exógenas $\mathbf{x}_t$; o que sobra, o resíduo $\eta_t$, ainda pode ter estrutura de autocorrelação, que é então absorvida por um ARMA. Os coeficientes $\boldsymbol\beta$ mantêm a **interpretação clássica de regressão** ("um aumento de 1% no dólar está associado a ..."), porque a dinâmica temporal foi empurrada para o erro.
### Caminho 2: ARIMAX "clássico"
$$\Phi(L)\, (1-L)^d\, Y_t = c + \boldsymbol{\beta}^\top \mathbf{x}_t + \Theta(L)\, \varepsilon_t$$
Aqui as exógenas entram **dentro** do filtro AR do $Y_t$, e os coeficientes $\boldsymbol\beta$ **não** têm mais a interpretação de regressão pura — são "efeitos sobre a série já filtrada pelo AR". Muitas bibliotecas chamam essa formulação de "ARIMAX" por simplicidade, mas Hyndman argumenta fortemente que o **Caminho 1 é preferível** sempre que possível: preserva interpretabilidade e separa sinal exógeno de dinâmica endógena.
::: {.callout-tip}
## Regra prática
Se o seu objetivo é **entender o efeito** de uma variável externa (ex.: preço do dólar no preço de um ativo), use **regressão com erros ARMA**. Se o foco é apenas **previsão** e a interpretabilidade dos betas não importa, ambas as formulações funcionam; a clássica ARIMAX costuma ser mais fácil de encaixar em pipelines existentes. Em `statsmodels`, use `SARIMAX(..., exog=...)`; em `statsforecast`, passe `X_df` no `forecast()`.
:::
## Quizzes: Teste seu Entendimento
::: {.callout-caution collapse="true"}
## Questão 1: Um ARIMA(1,1,0) tem quantos parâmetros a estimar?
**Três**: o coeficiente AR $\phi_1$, a constante $c$ (drift, se incluída), e a variância dos resíduos $\sigma^2$. O $d=1$ não é estimado — é determinado pelos testes de raiz unitária na etapa de identificação.
Na prática, muitas implementações não contam $\sigma^2$ como "parâmetro do modelo" ao reportar, então você pode ver a resposta "2" ($\phi_1$ e $c$). O importante é entender o que cada um representa.
:::
::: {.callout-caution collapse="true"}
## Questão 2: Você ajustou um ARIMA(2,1,1) e o teste de Ljung-Box retornou p-valor = 0.03. O que você faz?
**Volte à etapa de identificação.** O p-valor < 0.05 indica que rejeitamos a hipótese de que os resíduos são ruído branco — há autocorrelação remanescente. Isso significa que o modelo não capturou toda a estrutura da série.
Ações: (a) examine a ACF dos resíduos para ver *onde* estão os picos — isso dá pistas sobre o que falta; (b) tente modelos alternativos (ex: ARIMA(3,1,1), ARIMA(2,1,2)); (c) considere se há sazonalidade não capturada (SARIMA).
:::
::: {.callout-caution collapse="true"}
## Questão 3: O AICc de um ARIMA(1,1,1) é 350 e de um ARIMA(2,1,1) é 348. Qual você escolhe?
**ARIMA(2,1,1)**, pois tem menor AICc. Porém, a diferença de apenas 2 pontos é **marginal** — na prática, ambos os modelos são comparáveis. Neste caso, vale verificar: (a) ambos passam no diagnóstico? (b) as previsões são similares? Se sim, prefira o mais simples (parcimônia).
Regra prática: diferenças de AICc menores que 2 são "empate"; entre 2-10 há evidência moderada; acima de 10 é decisivo.
:::
::: {.callout-caution collapse="true"}
## Questão 4: Uma série mensal de vendas tem sazonalidade anual. Qual o valor de $s$ no SARIMA?
**$s = 12$**, pois os dados são mensais e a sazonalidade se repete a cada 12 meses. Se a série fosse trimestral com sazonalidade anual, seria $s = 4$. Se fosse diária com sazonalidade semanal, seria $s = 7$.
:::
::: {.callout-caution collapse="true"}
## Questão 5: Explique em linguagem de negócios: o que significa um ARIMA(1,0,0) com $\phi_1 = 0.8$ aplicado a vendas mensais?
"As vendas de cada mês são **80% explicadas** pelas vendas do mês anterior, mais variação aleatória. Isso significa que há forte inércia: um mês bom tende a ser seguido por outro mês bom (mas não tão bom — 80%, não 100%). A série gravita ao redor de uma média de longo prazo. Se houve um choque positivo (promoção, sazonalidade), seu efeito decai geometricamente: 80% no mês seguinte, 64% ($0.8^2$) em dois meses, 51% em três meses, etc."
:::
## Para Saber Mais
- [FPP3, Cap. 9: ARIMA Models](https://otexts.com/fpppy/09-arima.html)
- Box, G.E.P., Jenkins, G.M., Reinsel, G.C., & Ljung, G.M. (2015). *Time Series Analysis: Forecasting and Control*. 5th ed. Wiley.
- Enders, W. (2014). *Applied Econometric Time Series*. 4th ed. Wiley. — Capítulos 2-4 são excelentes.