flowchart LR
    A["Série y_t<br/>(SGS 1373)"] --> B["Feature engineering<br/>lags · rolling · calendário · FFT"]
    B --> C["Matriz X tabular<br/>(uma linha por mês)"]
    C --> D["Modelo de regressão<br/>GBM · LightGBM · MLP"]
    D --> E["Validação cruzada<br/>temporal (expanding)"]
    E --> F["Forecast h=12<br/>+ intervalos"]
    style A fill:#E50505,color:#fff
    style C fill:#FFCC00,color:#000
    style F fill:#3ACC9F,color:#fff
Lab 2: Machine Learning para Séries Temporais
Objetivos do Lab
- Reconhecer as principais tarefas e famílias de modelos de ML para séries temporais
- Analisar o que muda em relação ao ML tabular tradicional
- Aplicar feature engineering temporal (clássico + FFT) e rodar modelos de ML reais
- Avaliar o trade-off entre modelos clássicos, ML, deep learning e foundation models
- Criar o esqueleto da entrega intermediária com apoio do monitor
O caso que vai nos acompanhar o lab inteiro
Vocês são a assessoria PADS Forecasting. Uma montadora de veículos quer prever a produção mensal de veículos no Brasil para planejar compras de aço, turnos de fábrica e logística. Usaremos a série real do Banco Central (SGS 1373 - produção de veículos, unidades). Ela tem três ingredientes que fazem dela um caso de aula perfeito:
- Sazonalidade forte - dezembro despenca (férias coletivas), agosto/outubro são picos.
- Um choque brutal - março/2020 caiu para 1.847 unidades (fábricas paradas na COVID). Outlier de manual.
- Tendência com regimes - recessão 2015–16, colapso e recuperação pós-COVID.
A mesma série será o fio condutor da Parte 1 e da Parte 2.
Revisão da Parte 1
NotaOs 5 pilares da Parte 1
- Decomposição. \(Y_t = T_t + S_t + R_t\) (aditiva) ou \(T_t \cdot S_t \cdot R_t\) (multiplicativa). STL é a ferramenta moderna.
- Estacionariedade. ARMA exige média e variância estáveis. ADF (H0: raiz unitária) e KPSS (H0: estacionária) são complementares.
- ACF/PACF. A “impressão digital”: AR(p) → PACF corta em \(p\); MA(q) → ACF corta em \(q\); decaimento lento → diferenciar.
- ARIMA/SARIMA. Box-Jenkins: identifica → estima → diagnostica. AutoARIMA automatiza via AICc.
- Validação temporal. Nunca embaralhe. Expanding ou sliding window. Métricas: MAE, RMSE, MAPE (cuidado com zero), MASE.
CuidadoMini-quiz Q1. ACF decai exponencialmente e PACF corta no lag 1. Que modelo?
AR(1). Assinatura do AR(p): PACF significativa até o lag \(p\) e depois zero, com ACF decaindo geometricamente.
CuidadoMini-quiz Q2. ADF rejeita H0 e KPSS também rejeita. O que significa?
Conflito - provavelmente trend stationary. A série pode ser estacionária ao redor de uma tendência determinística. Estratégias: regredir contra \(t\); diferenciar e reavaliar; inspeção visual.
CuidadoMini-quiz Q3. Quando preferir Prophet a SARIMA?
Sazonalidade múltipla, feriados estruturados, changepoints conhecidos. Prophet é \(g(t)+s(t)+h(t)+\varepsilon_t\) com sazonalidade Fourier. Para séries financeiras, ARIMA+GARCH ainda é mais adequado (volatilidade condicional).
DicaRevisão por conta própria
Se algo ficou nebuloso: FPP3 Cap. 5, FPP3 Cap. 9 e o notebook do Lab 1.
O que muda no ML para séries
ML tradicional assume i.i.d.: cada linha é independente. Em séries, isso é falso - o passado prevê o futuro.
| Aspecto | ML tabular clássico | ML para séries temporais |
|---|---|---|
| Suposição | Amostras i.i.d. | Dependência temporal explícita |
| Train/test split | Aleatório (k-fold) | Cronológico (expanding/sliding) |
| Embaralhamento | Sim | Nunca - quebra causalidade |
| Leakage típico | Vars derivadas do alvo | Usar futuro p/ prever passado |
| Features dominantes | Atributos do exemplo | Lags, janelas, calendário, eventos |
| Métrica | Acurácia, F1, AUC | RMSE, MAE, MASE, pinball loss |
| Pipeline | fit → predict |
fit → forecast(h) (recursivo/direto) |
AvisoAs 3 fontes silenciosas de data leakage
- Normalização global.
mean/stdda série inteira antes do split usa o futuro. - Imputação retrospectiva. Preencher
NaNde 2020 com a média de 2024. - Features que olham para frente.
rolling()centrado,shift(-1)por engano.
Regra de ouro: o que entra no modelo em \(t\) só pode usar informação até \(t\).
As 8 tarefas (Oudre)
ML para séries não é só “prever o próximo valor”:
| Tarefa | O que faz | Exemplo de negócio |
|---|---|---|
| Predição (forecasting) | Estimar futuro | Produção do próximo trimestre |
| Completion / interpolação | Recuperar faltantes | Sensor offline, feriado sem cotação |
| Classificação | Rotular série/subsequência | Fraude vs. transação normal |
| Clustering | Agrupar perfis | Segmentar lojas por padrão de venda |
| Indexação / busca | Achar séries parecidas | “Que ações se moveram como X em 2008?” |
| Change-point | Detectar quebras | Quebra estrutural em produção |
| Detecção de anomalias | Eventos fora do padrão | Flash crash, pico de tráfego |
| Extração de padrões | Motivos repetidos | Sazonalidade não-óbvia |
Adaptado de Oudre (2023). Nosso foco é predição, mas detecção de anomalias e classificação usam as mesmas ferramentas.
Parte 1 - ML “tabular” para séries
A grande ideia do ML aplicado a séries: transformar o problema temporal em um problema tabular via features, e jogar um modelo de regressão usual em cima.
1.1 Setup e os dados
Código
import warnings
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

INSPER_RED = "#E50505"
INSPER_TURQUESA = "#3ACC9F"
INSPER_AMARELO = "#FFCC00"
INSPER_GRAY = "#5B5B5B"

plt.rcParams.update({
    "figure.figsize": (12, 5),
    "axes.spines.top": False,
    "axes.spines.right": False,
    "font.size": 12,
})
Código
# SGS 1373 - produção de veículos no Brasil (unidades, mensal)
url = "https://api.bcb.gov.br/dados/serie/bcdata.sgs.1373/dados?formato=csv&dataInicial=01/01/2012"
df = pd.read_csv(url, sep=";", decimal=",")
df["data"] = pd.to_datetime(df["data"], format="%d/%m/%Y")
df = df.set_index("data").sort_index().rename(columns={"valor": "y"})
df = df.asfreq("MS")
df["y"] = df["y"].interpolate()

print(f"Série: {len(df)} meses, de {df.index.min().date()} a {df.index.max().date()}")
df.tail(3)
Série: 172 meses, de 2012-01-01 a 2026-04-01| y | |
|---|---|
| data | |
| 2026-02-01 | 206945 |
| 2026-03-01 | 263575 |
| 2026-04-01 | 238498 |
Código
fig, ax = plt.subplots(figsize=(12, 4.5))
ax.plot(df.index, df["y"], color=INSPER_RED, linewidth=1.2)
ax.axvline(pd.Timestamp("2020-03-01"), color=INSPER_GRAY, ls="--", lw=1)
ax.annotate("COVID: 1.847 un.\n(fábricas paradas)", xy=(pd.Timestamp("2020-03-01"), 2000),
            xytext=(pd.Timestamp("2021-06-01"), 90000),
            arrowprops=dict(arrowstyle="->", color=INSPER_GRAY), fontsize=10)
ax.set_title("Produção de veículos no Brasil - SGS 1373", fontweight="bold")
ax.set_ylabel("Unidades/mês")
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()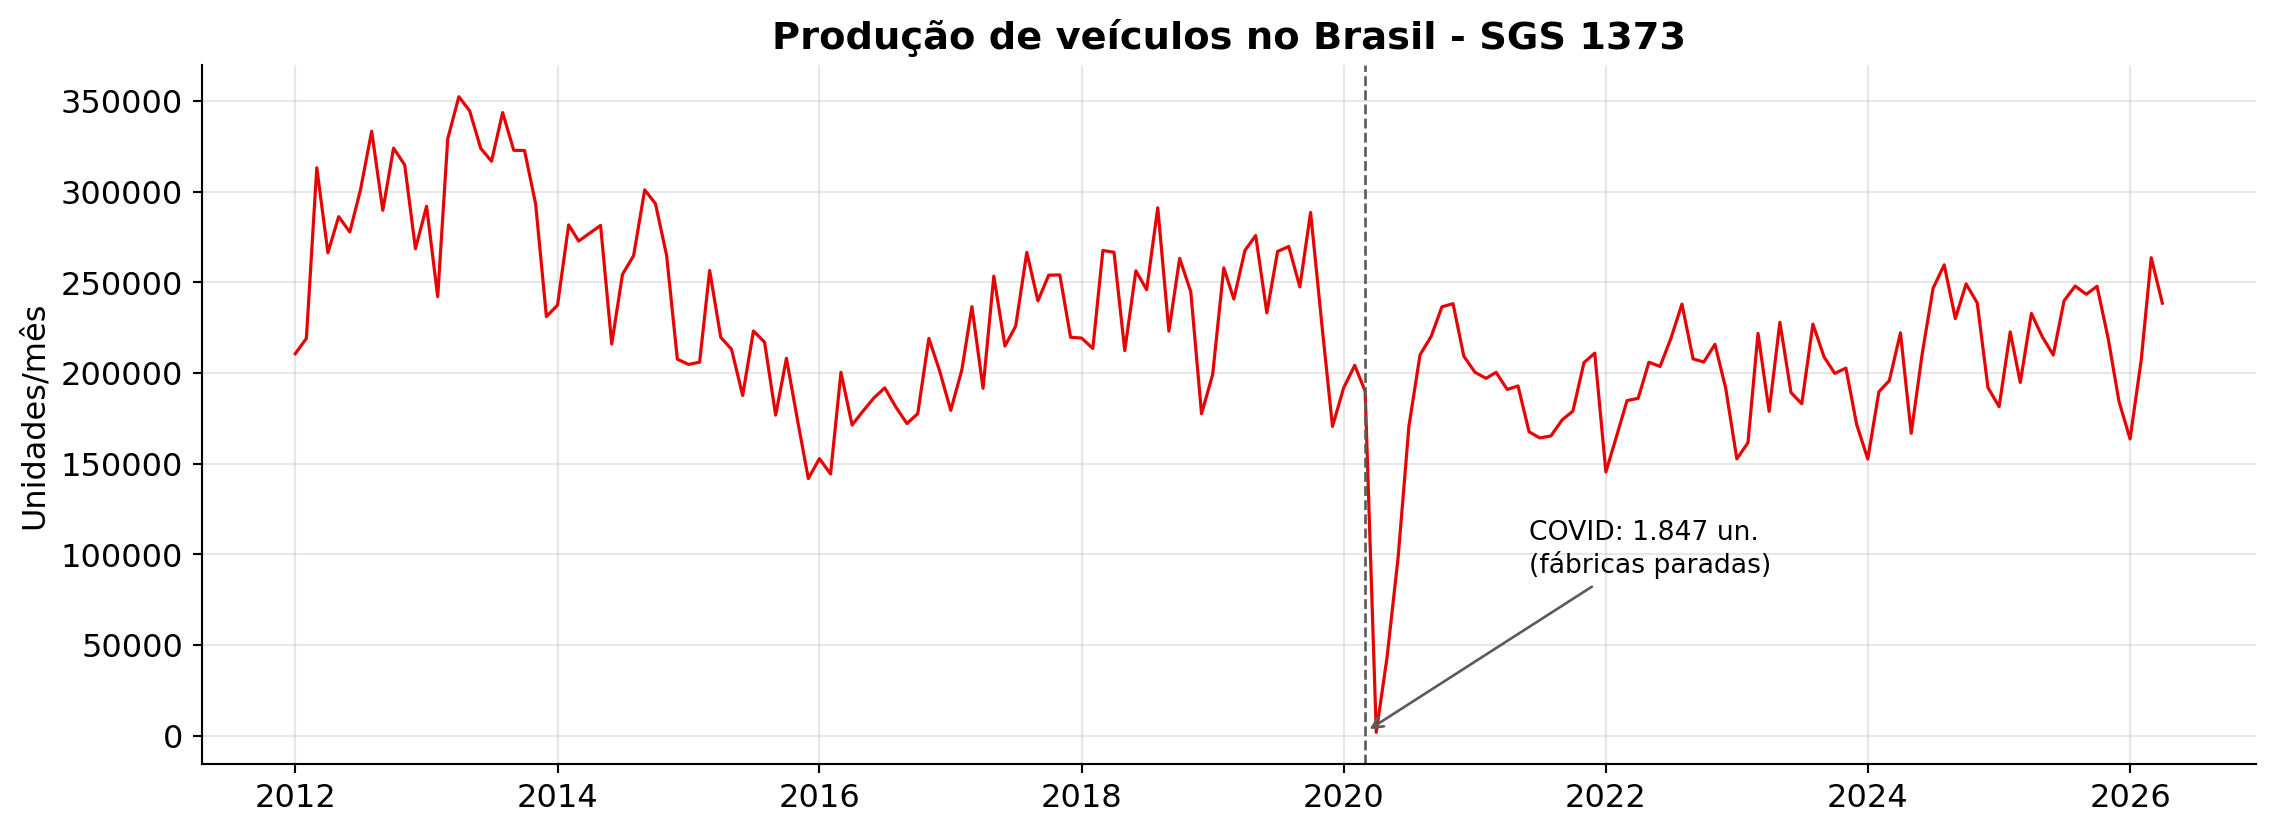
NotaObserve antes de modelar
Sazonalidade anual clara, recessão 2015–16, o buraco da COVID (mar–mai/2020) e recuperação. Qualquer modelo bom precisa lidar com esse outlier extremo - guardem isso, vai voltar.
1.2 Feature engineering - o básico (cobre 80% dos casos)
Lag features \[X_t = \big[\, y_{t-1},\ y_{t-2},\ \ldots,\ y_{t-p},\ y_{t-12},\ y_{t-24} \,\big]\]
Lags sazonais (\(y_{t-12}\) mensal, \(y_{t-7}\) diário) são quase sempre úteis.
Janelas móveis (rolling) \[\bar{y}_t^{(k)} = \frac{1}{k}\sum_{i=1}^{k} y_{t-i}, \qquad \sigma_t^{(k)} = \sqrt{\frac{1}{k}\sum_{i=1}^{k}\big(y_{t-i}-\bar{y}_t^{(k)}\big)^2}\]
Captura estado local: tendência recente (média) e volatilidade local (desvio).
Calendário cíclico: \(\sin(2\pi m/12),\ \cos(2\pi m/12)\) - preserva a continuidade entre dezembro e janeiro (sem ele, mês 12 e mês 1 ficam “longe”).
Código
def construir_features(s: pd.Series) -> pd.DataFrame:
    """Lags + rolling + calendário + dummy COVID. Tudo causal (só usa o passado)."""
    X = pd.DataFrame(index=s.index)

    # Lags curtos + sazonais
    for lag in [1, 2, 3, 6, 12, 24]:
        X[f"lag_{lag}"] = s.shift(lag)

    # Rolling SEMPRE com shift(1): a janela de jun não pode incluir jun
    for win in [3, 6, 12]:
        X[f"roll_mean_{win}"] = s.shift(1).rolling(win).mean()
        X[f"roll_std_{win}"]  = s.shift(1).rolling(win).std()

    # Calendário cíclico
    mes = s.index.month
    X["mes_sin"] = np.sin(2 * np.pi * mes / 12)
    X["mes_cos"] = np.cos(2 * np.pi * mes / 12)

    # Dummy de intervenção: choque da COVID (fábricas paradas)
    X["covid"] = ((s.index >= "2020-03-01") & (s.index <= "2020-06-01")).astype(int)

    return X

X_full = construir_features(df["y"])
X_full.head(13)| lag_1 | lag_2 | lag_3 | lag_6 | lag_12 | lag_24 | roll_mean_3 | roll_std_3 | roll_mean_6 | roll_std_6 | roll_mean_12 | roll_std_12 | mes_sin | mes_cos | covid | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| data | |||||||||||||||
| 2012-01-01 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | 5.000000e-01 | 8.660254e-01 | 0 |
| 2012-02-01 | 210604.0 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | 8.660254e-01 | 5.000000e-01 | 0 |
| 2012-03-01 | 219068.0 | 210604.0 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | 1.000000e+00 | 6.123234e-17 | 0 |
| 2012-04-01 | 313178.0 | 219068.0 | 210604.0 | NaN | NaN | NaN | 247616.666667 | 56935.280322 | NaN | NaN | NaN | NaN | 8.660254e-01 | -5.000000e-01 | 0 |
| 2012-05-01 | 266275.0 | 313178.0 | 219068.0 | NaN | NaN | NaN | 266173.666667 | 47055.081833 | NaN | NaN | NaN | NaN | 5.000000e-01 | -8.660254e-01 | 0 |
| 2012-06-01 | 286215.0 | 266275.0 | 313178.0 | NaN | NaN | NaN | 288556.000000 | 23538.969030 | NaN | NaN | NaN | NaN | 1.224647e-16 | -1.000000e+00 | 0 |
| 2012-07-01 | 277722.0 | 286215.0 | 266275.0 | 210604.0 | NaN | NaN | 276737.333333 | 10006.401768 | 262177.000000 | 39888.665769 | NaN | NaN | -5.000000e-01 | -8.660254e-01 | 0 |
| 2012-08-01 | 301142.0 | 277722.0 | 286215.0 | 219068.0 | NaN | NaN | 288359.666667 | 11856.382093 | 277266.666667 | 33008.595666 | NaN | NaN | -8.660254e-01 | -5.000000e-01 | 0 |
| 2012-09-01 | 333316.0 | 301142.0 | 277722.0 | 313178.0 | NaN | NaN | 304060.000000 | 27911.632915 | 296308.000000 | 24604.250259 | NaN | NaN | -1.000000e+00 | -1.836970e-16 | 0 |
| 2012-10-01 | 289693.0 | 333316.0 | 301142.0 | 266275.0 | NaN | NaN | 308050.333333 | 22617.146910 | 292393.833333 | 23212.422428 | NaN | NaN | -8.660254e-01 | 5.000000e-01 | 0 |
| 2012-11-01 | 323940.0 | 289693.0 | 333316.0 | 286215.0 | NaN | NaN | 315649.666667 | 22962.768830 | 302004.666667 | 22148.775349 | NaN | NaN | -5.000000e-01 | 8.660254e-01 | 0 |
| 2012-12-01 | 314727.0 | 323940.0 | 289693.0 | 277722.0 | NaN | NaN | 309453.333333 | 17722.102650 | 306756.666667 | 21118.221589 | NaN | NaN | -2.449294e-16 | 1.000000e+00 | 0 |
| 2013-01-01 | 268504.0 | 314727.0 | 323940.0 | 301142.0 | 210604.0 | NaN | 302390.333333 | 29705.765978 | 305220.333333 | 23815.915407 | 283698.666667 | 38553.036728 | 5.000000e-01 | 8.660254e-01 | 0 |
NotaPor que o
shift(1) antes de cada rolling?
Sem ele, a média móvel de junho incluiria o próprio junho - informação indisponível em produção. É exatamente o leakage silencioso da seção anterior. A dummy covid é uma feature de intervenção: ela “avisa” o modelo que aqueles meses foram anômalos, evitando que o choque contamine a previsão futura.
1.3 Feature engineering avançado - FFT e o periodograma
Quando o calendário cíclico básico não basta (ciclos não óbvios, múltiplas sazonalidades), a Transformada de Fourier decompõe a série em frequências. O periodograma mostra quais ciclos dominam - e essas frequências viram features.
Código
from scipy.fft import rfft, rfftfreq

# Tiramos tendência (a FFT enxerga melhor o ciclo sem o "drift")
y = df["y"].values.astype(float)
y_detrend = y - np.polyval(np.polyfit(np.arange(len(y)), y, 1), np.arange(len(y)))

amp = np.abs(rfft(y_detrend - y_detrend.mean()))
freq = rfftfreq(len(y_detrend), d=1)          # ciclos por mês
periodo = np.divide(1, freq, where=freq > 0)  # meses por ciclo

mask = (periodo >= 2) & (periodo <= 48)
fig, ax = plt.subplots(figsize=(11, 4))
ax.plot(periodo[mask], amp[mask], color=INSPER_RED)
top = periodo[mask][np.argmax(amp[mask])]
ax.axvline(top, color=INSPER_TURQUESA, ls="--",
           label=f"Pico em ~{top:.1f} meses")
ax.set_xlabel("Período (meses por ciclo)")
ax.set_ylabel("Amplitude")
ax.set_title("Periodograma - produção de veículos", fontweight="bold")
ax.legend()
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()

print(f"Ciclo dominante: ~{top:.1f} meses (esperado: 12 - sazonalidade anual)")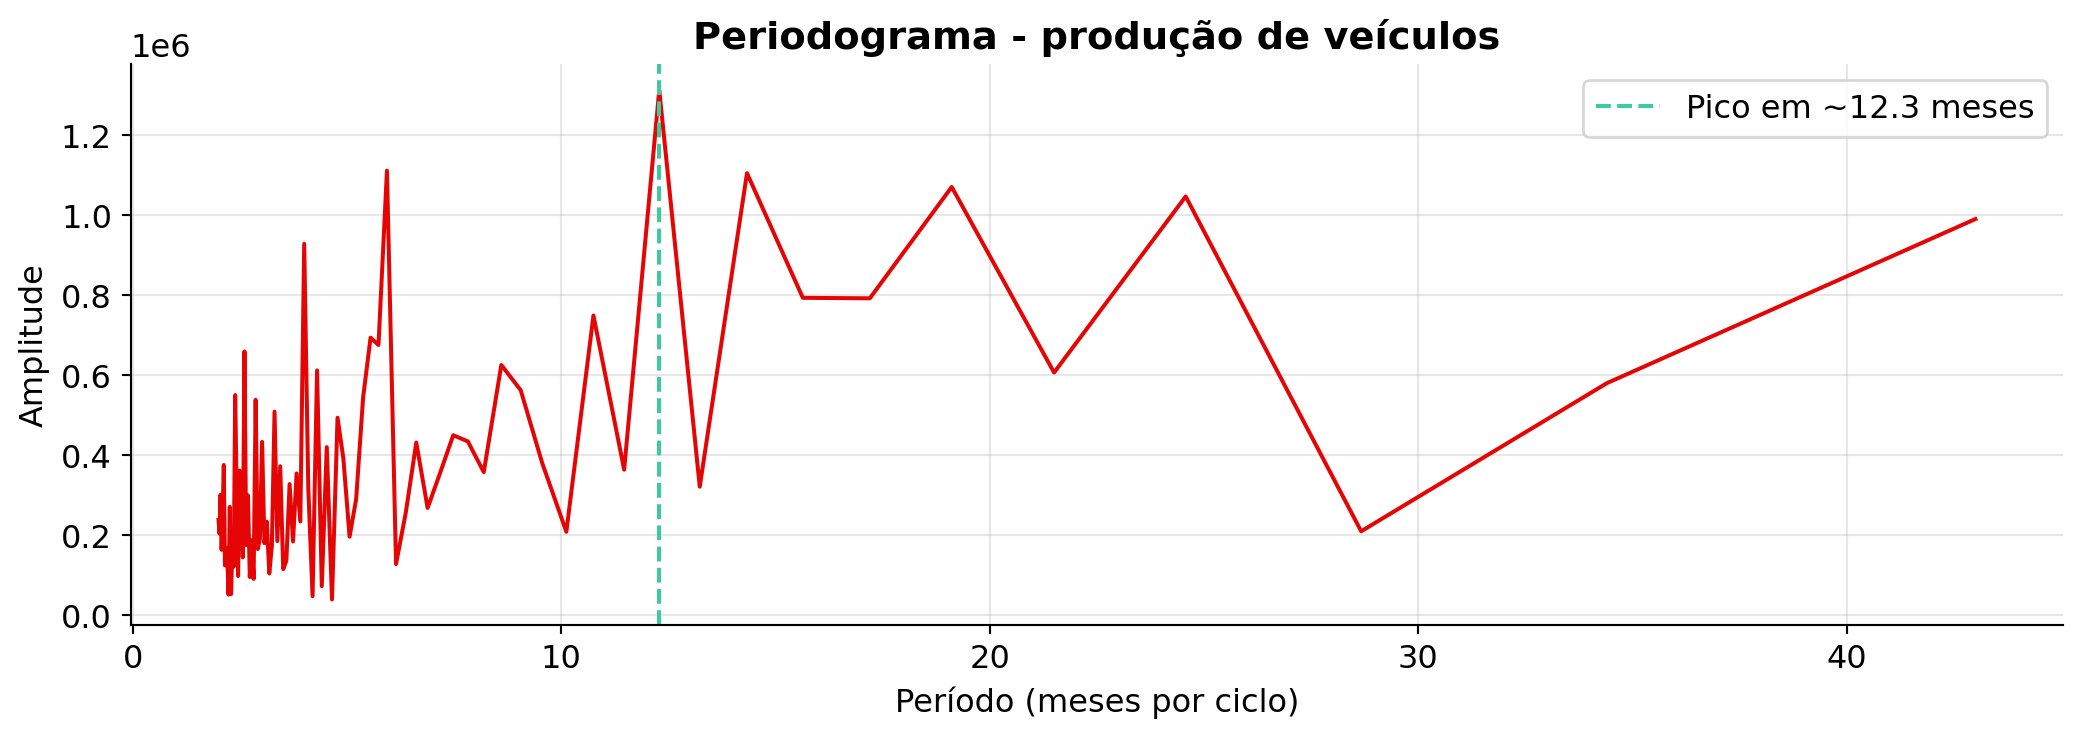
Ciclo dominante: ~12.3 meses (esperado: 12 - sazonalidade anual)
DicaO que a FFT está dizendo
O pico em ~12 meses confirma a sazonalidade anual; picos secundários em ~6 e ~3 meses são harmônicos (a forma do ciclo não é uma senoide pura). Na prática você usa isso para escolher quantos termos de Fourier incluir como feature - uma alternativa flexível ao sin/cos simples.
NotaQuando vale a pena usar senoides (Fourier) e/ou FFT como features
Os termos \(\sin(2\pi k\, t/P),\ \cos(2\pi k\, t/P)\) codificam sazonalidade de período \(P\) com poucos parâmetros. Use quando:
- O período sazonal é longo. Sazonalidade anual em dados diários (\(P\approx365\)): uma dummy por dia-do-ano custaria 365 colunas e dados ralos por categoria; 3–4 pares de Fourier resolvem com ~8 colunas suaves. O mesmo vale para lags sazonais -
lag_365exige histórico enorme; Fourier não. - Há múltiplas sazonalidades simultâneas. Energia/varejo diário tem ciclo semanal (\(P=7\)) e anual (\(P=365\)) ao mesmo tempo. Você soma dois blocos de Fourier (um por período) - algo que dummies de calendário fazem mal e SARIMA com um único \(s\) não captura.
- Você quer uma sazonalidade suave. Fourier impõe continuidade (dezembro “conversa” com janeiro). Dummies tratam cada mês como ilha independente - mais flexível, porém mais propenso a overfitting com pouca amostra. Poucos harmônicos = regularização natural.
- Modelos que não entendem ordem. Boosting/MLP só veem colunas. Sem features cíclicas eles não sabem que mês 12 e mês 1 são vizinhos - Fourier injeta essa geometria.
A FFT/periodograma entra antes disso, como diagnóstico: quando você não sabe qual é o período (ciclos de negócio, safras, manutenção de equipamentos, ciclos econômicos não óbvios). O periodograma revela os \(P\) dominantes; aí você cria os termos de Fourier para esses períodos. Também serve para decidir quantos harmônicos bastam (até onde a amplitude ainda é relevante).
Quando não compensar: período curto e estável (sazonalidade mensal num dado mensal - lag_12 + dummies já bastam); série dominada por tendência/quebras e não por ciclos; ciclos cuja frequência muda no tempo (aí prefira wavelets, que localizam frequência no tempo, em vez da FFT global).
Visualizando termos de Fourier (interativo)
Quantos pares \(\sin/\cos\) você precisa para reconstruir um padrão sazonal? Mexa nos controles:
NotaLendo o widget
Com K=1 a reconstrução é uma senoide pura - não captura a queda de dezembro. Subindo K, os harmônicos “esculpem” o formato real e o erro cai monotonicamente. Isso é o teorema de Fourier: qualquer função contínua e periódica pode ser aproximada tão bem quanto se queira por uma soma de senos e cossenos - basta usar harmônicos suficientes. Daí o sin/cos de calendário e a base de Fourier do Prophet: poucos termos já capturam sazonalidades suaves; o custo é mais parâmetros (risco de overfitting com pouca amostra).
Outras técnicas avançadas (quando o básico não basta)
| Técnica | Quando usar | Pacote |
|---|---|---|
| tsfresh | Gerar 700+ features e selecionar por teste estatístico | tsfresh |
| Catch-22 | 22 features canônicas validadas em larga escala | pycatch22 |
| Wavelets | Ciclos que mudam de frequência no tempo | pywavelets |
| Target encoding sazonal | Codificar mês/dia pela média histórica de \(y\) | manual |
| Variáveis exógenas | Regressores externos (preço do aço, câmbio, juros) | qualquer pipeline |
DicaComece pelo básico
Em competições reais (M5, M6), times no top-10 usaram quase só lags + rolling + calendário com LightGBM. Sofisticação extra costuma ser marginal - mas saber que existe te tira de apuros em séries difíceis.
1.4 Esquema de validação
Antes de rodar os modelos, fixamos o esquema de validação usado nas comparações.
NotaProtocolo: expanding window, 4 janelas, h = 12, sem embaralhar
Seja \(T\) o último mês disponível. Reservamos os últimos 48 meses e os quebramos em 4 janelas consecutivas de 12 meses. Em cada janela, o modelo treina em tudo que veio antes e prevê os 12 meses seguintes (que ele nunca viu):
| Janela | Treino (expanding - cresce a cada janela) | Teste (12 meses à frente) |
|---|---|---|
| 1 | início → \(T-48\) | \(T-47 \ldots T-36\) |
| 2 | início → \(T-36\) | \(T-35 \ldots T-24\) |
| 3 | início → \(T-24\) | \(T-23 \ldots T-12\) |
| 4 | início → \(T-12\) | \(T-11 \ldots T\) |
No código: n_windows=4, h=12, step_size=12 (janelas não se sobrepõem). A métrica final (MAE/RMSE/MASE) é calculada sobre os 48 pontos de teste juntos - uma média sobre 4 cenários diferentes, não a sorte de um único corte.
Visualizando o esquema (interativo)
Os controles começam na configuração real do lab (Expanding · 4 janelas · h=12). Mexa neles para entender as escolhas - especialmente: troque para Sliding e veja quanto histórico é jogado fora numa série tão curta.
1.5 Rodando os modelos - sklearn na unha
Para enxergar o pipeline inteiro, primeiro à mão: GradientBoostingRegressor (sem dependência extra; em produção troque por lightgbm/xgboost). É a implementação direta do protocolo acima.
Código
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.metrics import mean_absolute_error, mean_squared_error

def cv_boost(s, n_windows=4, h=12):
    X = construir_features(s).dropna()
    y = s.loc[X.index]
    n = len(X)
    test_starts = [n - (n_windows - i) * h for i in range(n_windows)]
    rows = []
    for i, start in enumerate(test_starts):
        X_tr, y_tr = X.iloc[:start], y.iloc[:start]
        X_te, y_te = X.iloc[start:start+h], y.iloc[start:start+h]
        m = GradientBoostingRegressor(
            n_estimators=300, max_depth=3, learning_rate=0.05, random_state=42
        ).fit(X_tr, y_tr)
        rows.append(pd.DataFrame({
            "ds": X_te.index, "y": y_te.values,
            "boost": m.predict(X_te), "window": i,
        }))
    return pd.concat(rows, ignore_index=True)

cv_b = cv_boost(df["y"])
cv_b.head(3)| ds | y | boost | window | |
|---|---|---|---|---|
| 0 | 2022-05-01 | 205916 | 183885.967958 | 0 |
| 1 | 2022-06-01 | 203598 | 174801.866349 | 0 |
| 2 | 2022-07-01 | 218950 | 168334.898674 | 0 |
Código
X_fit = construir_features(df["y"]).dropna()
y_fit = df["y"].loc[X_fit.index]
modelo = GradientBoostingRegressor(
    n_estimators=300, max_depth=3, learning_rate=0.05, random_state=42
).fit(X_fit, y_fit)

imp = (pd.Series(modelo.feature_importances_, index=X_fit.columns)
       .sort_values().tail(10))
fig, ax = plt.subplots(figsize=(9, 4))
imp.plot.barh(ax=ax, color=INSPER_TURQUESA)
ax.set_title("Top features (GradientBoosting)", fontweight="bold")
plt.tight_layout()
plt.show()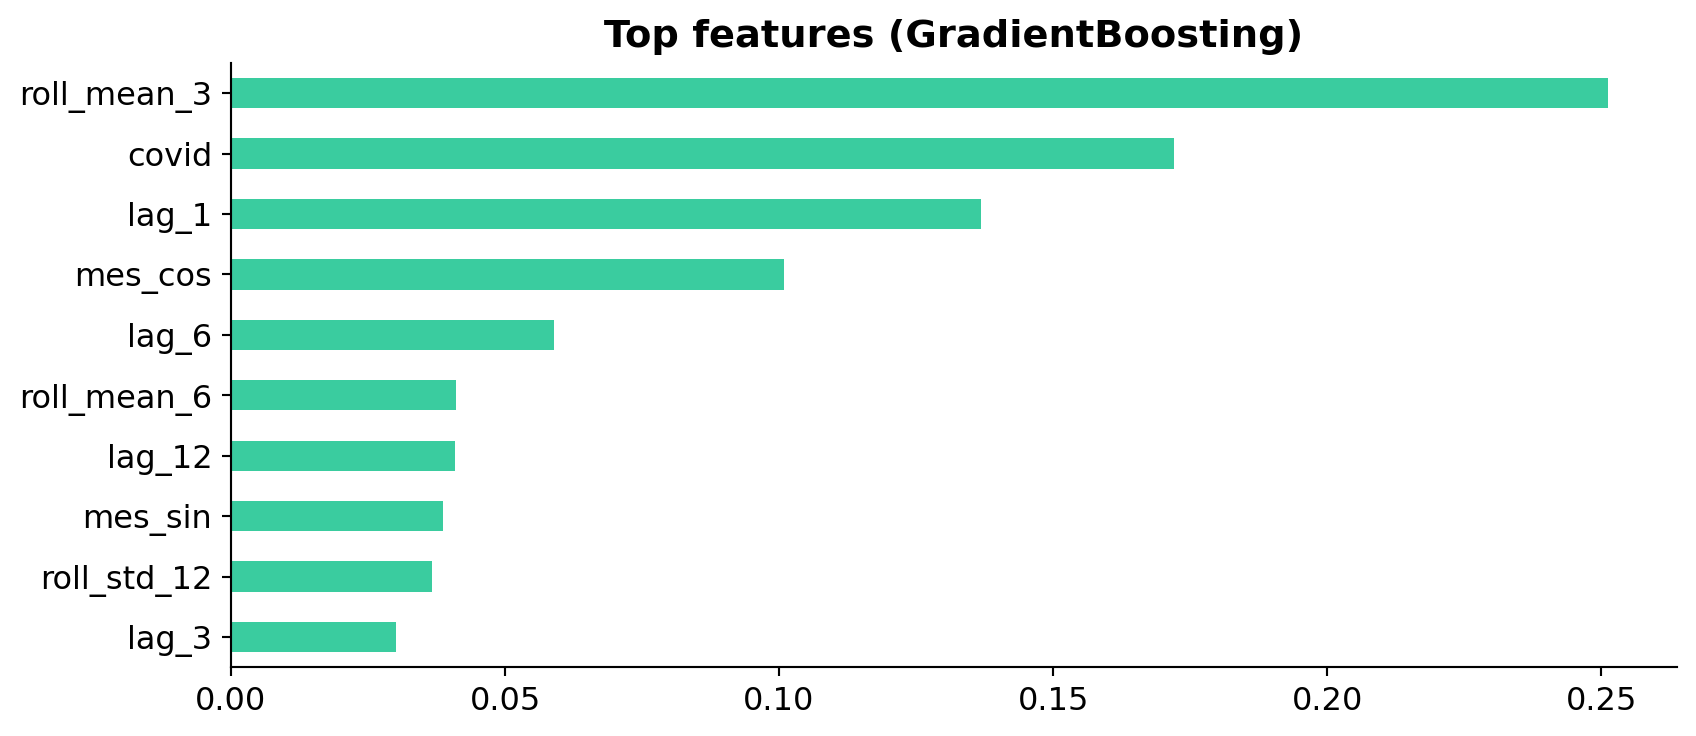
NotaLeitura
O lag_12 (mesmo mês do ano anterior) e a média móvel de 12 meses costumam dominar - exatamente o que a intuição de séries sazonais previa. Boosting não extrapola tendência: se a série sobe, ele “trava” no máximo treinado. Mitigação: treinar na diferença ou nos resíduos de um modelo de tendência (vamos fazer isso na Parte 2 com o ARIMA-Boost).
1.6 Rodando os modelos - frameworks modernos
Na vida real você não escreve a CV à mão. Dois frameworks dominam o ecossistema Python:
API quase idêntica ao statsforecast que vocês já usam. Lags, rolling, exógenos e qualquer modelo scikit-learn-like.
# pip install mlforecast lightgbm
from mlforecast import MLForecast
from mlforecast.lag_transforms import RollingMean
from lightgbm import LGBMRegressor

sf_df = (df.reset_index()
           .rename(columns={"data": "ds"})
           .assign(unique_id="veiculos")[["unique_id", "ds", "y"]])

mlf = MLForecast(
    models={"lgbm": LGBMRegressor(n_estimators=300, learning_rate=0.05)},
    freq="MS",
    lags=[1, 2, 3, 12, 24],
    lag_transforms={1: [RollingMean(3), RollingMean(12)]},
    date_features=["month", "quarter"],
)
cv_mlf = mlf.cross_validation(df=sf_df, h=12, n_windows=4)
API “scikit-learn das séries temporais”. SARIMA, Prophet, N-BEATS, NHITS, TFT e até Chronos (foundation model) na mesma interface.
# pip install u8darts[all]
from darts import TimeSeries
from darts.models import LightGBMModel

serie = TimeSeries.from_dataframe(
    df.reset_index(), "data", "y", freq="MS"
)
modelo = LightGBMModel(lags=[-1, -2, -3, -12, -24], output_chunk_length=12)
modelo.fit(serie[:-24])
prev = modelo.predict(n=24)

# backtest = cross-validation
hist = modelo.historical_forecasts(
    serie, start=0.7, forecast_horizon=12, retrain=True
)
NotaQual escolher?
- MLForecast se você já usa
statsforecast- encaixa perfeitamente, é o mais rápido para muitas séries. - DARTS se quer um catálogo amplo (clássicos → deep learning → foundation models) com a mesma API didática.
Para a entrega intermediária, qualquer uma - ou scikit-learn puro, como acima.
Parte 2 - Modelos com a ordem na arquitetura
Na Parte 1 o modelo não “sabia” que os dados eram uma série - nós inserimos a ordem via features. Agora vamos a modelos onde a dependência temporal está embutida na arquitetura.
flowchart TD
    A["Modelos que respeitam a ordem"] --> B["Estatísticos clássicos"]
    A --> C["Híbridos"]
    A --> D["Redes neurais"]
    A --> E["Foundation models"]
    B --> B1["ARIMA / SARIMA"]
    B --> B2["ETS (suavização exponencial)"]
    C --> C1["ARIMA-Boost / STL-Boost"]
    D --> D1["MLP · N-BEATS · NHITS"]
    D --> D2["LSTM / GRU · TCN"]
    D --> D3["Transformers (TFT, PatchTST)"]
    E --> E1["Chronos · TimesFM · Moirai · TimeGPT"]
    style A fill:#E50505,color:#fff
    style C1 fill:#FFCC00,color:#000
    style E1 fill:#3ACC9F,color:#fff
2.1 ARIMA - o ponto de partida
ARIMA modela a própria estrutura de autocorrelação: cada valor é função linear dos valores e erros passados.
SARIMA \((p,d,q)(P,D,Q)_s\) \[\phi_p(B)\,\Phi_P(B^s)\,(1-B)^d (1-B^s)^D\, y_t = \theta_q(B)\,\Theta_Q(B^s)\,\varepsilon_t\]
flowchart LR
    A["Identificação<br/>ACF/PACF, ADF/KPSS"] --> B["Estimação<br/>máx. verossimilhança"]
    B --> C["Diagnóstico<br/>resíduos ~ ruído branco?"]
    C -->|"falhou"| A
    C -->|"ok"| D["Previsão + IC"]
    style A fill:#E50505,color:#fff
    style D fill:#3ACC9F,color:#fff
Código
from statsforecast import StatsForecast
from statsforecast.models import AutoARIMA, AutoETS, SeasonalNaive

sf_df = (df.reset_index()
           .rename(columns={"data": "ds"})
           .assign(unique_id="veiculos")[["unique_id", "ds", "y"]])

sf = StatsForecast(
    models=[
        AutoARIMA(season_length=12, alias="arima"),
        AutoETS(season_length=12, alias="ets"),
        SeasonalNaive(season_length=12, alias="snaive"),
    ],
    freq="MS", n_jobs=1,
)
cv_sf = sf.cross_validation(df=sf_df, h=12, step_size=12, n_windows=4)
cv_sf.head(3)| unique_id | ds | cutoff | y | arima | ets | snaive | |
|---|---|---|---|---|---|---|---|
| 0 | veiculos | 2022-05-01 | 2022-04-01 | 205916.0 | 182301.890625 | 202043.312500 | 192843.0 |
| 1 | veiculos | 2022-06-01 | 2022-04-01 | 203598.0 | 175854.000000 | 179201.000000 | 167547.0 |
| 2 | veiculos | 2022-07-01 | 2022-04-01 | 218950.0 | 175232.109375 | 191210.546875 | 164156.0 |
2.2 ETS - suavização exponencial
Enquanto ARIMA modela autocorrelação, ETS (Error-Trend-Seasonal) modela a série como nível + tendência + sazonalidade que se atualizam de forma ponderada (observações recentes pesam mais - daí “exponencial”).
Holt-Winters (intuição)
\[\ell_t = \alpha\, y_t + (1-\alpha)(\ell_{t-1}+b_{t-1}) \quad\text{(nível)}\] \[b_t = \beta(\ell_t-\ell_{t-1}) + (1-\beta) b_{t-1} \quad\text{(tendência)}\] \[s_t = \gamma(y_t-\ell_t) + (1-\gamma) s_{t-m} \quad\text{(sazonalidade)}\] O AutoETS testa as combinações (aditivo/multiplicativo, com/sem amortecimento) e escolhe por AICc - análogo ao AutoARIMA. Já está rodando junto no bloco acima.
DicaARIMA vs. ETS - regra prática
Não são rivais; são lentes diferentes. ETS brilha quando há tendência/sazonalidade claras e poucos dados. ARIMA brilha quando há autocorrelação rica nos resíduos. Em competições M, a combinação simples (média) dos dois costuma bater cada um isolado - combinar modelos é um almoço quase grátis.
2.3 ARIMA-Boost - o híbrido
Divide o trabalho: a parte fácil (linear, sazonal) vai para o SARIMA; a parte difícil (não-linearidades, efeitos de exógenas) vai para o boosting nos resíduos.
Estratégia ARIMA-Boost \[y_t = \underbrace{\hat{y}_t^{\text{ARIMA}}}_{\text{linear + sazonal}} + \underbrace{f_{\text{boost}}(X_t)}_{\text{resíduos não-lineares}} + \varepsilon_t\]
flowchart LR
    A["y_t"] --> B["SARIMA"]
    B --> C["ŷ ARIMA<br/>(tendência + sazonal)"]
    A --> D["resíduo = y − ŷ"]
    D --> E["Boosting<br/>nos resíduos"]
    C --> F["+"]
    E --> F
    F --> G["Previsão híbrida"]
    style B fill:#E50505,color:#fff
    style E fill:#FFCC00,color:#000
    style G fill:#3ACC9F,color:#fff
Código
from statsmodels.tsa.statespace.sarimax import SARIMAX

def cv_arima_boost(s, n_windows=4, h=12, order=(1,1,1), seas=(0,1,1,12)):
    X_all = construir_features(s)
    n = len(s)
    test_starts = [n - (n_windows - i) * h for i in range(n_windows)]
    rows = []
    for i, start in enumerate(test_starts):
        s_tr = s.iloc[:start]
        sarima = SARIMAX(s_tr, order=order, seasonal_order=seas).fit(disp=False)
        prev_arima = sarima.forecast(steps=h)

        resid = (s_tr - sarima.fittedvalues).rename("r")
        X_tr = X_all.loc[resid.index].dropna()
        r_tr = resid.loc[X_tr.index]

        boost = GradientBoostingRegressor(
            n_estimators=200, max_depth=3, learning_rate=0.05, random_state=42
        ).fit(X_tr, r_tr)

        X_te = X_all.iloc[start:start+h]
        rows.append(pd.DataFrame({
            "ds": X_te.index,
            "y": s.iloc[start:start+h].values,
            "arima_boost": prev_arima.values + boost.predict(X_te),
            "window": i,
        }))
    return pd.concat(rows, ignore_index=True)

cv_h = cv_arima_boost(df["y"])
cv_h.head(3)| ds | y | arima_boost | window | |
|---|---|---|---|---|
| 0 | 2022-05-01 | 205916 | 192068.858157 | 0 |
| 1 | 2022-06-01 | 203598 | 167554.070280 | 0 |
| 2 | 2022-07-01 | 218950 | 188948.617095 | 0 |
2.4 Comparando tudo
Usamos o esquema de validação da seção 1.4. Os modelos clássicos usam StatsForecast.cross_validation; o boosting e o híbrido replicam o mesmo corte à mão.
Código
def mase(y_true, y_pred, y_train, m=12):
    # erro do naive sazonal no treino: |y_t - y_{t-m}|
    naive = np.mean(np.abs(y_train[m:] - y_train[:-m]))
    return mean_absolute_error(y_true, y_pred) / naive

def metricas(y_true, y_pred, y_train):
    return {
        "MAE":  mean_absolute_error(y_true, y_pred),
        "RMSE": np.sqrt(mean_squared_error(y_true, y_pred)),
        "MASE": mase(y_true, y_pred, y_train),
    }

cv_sf2 = cv_sf.reset_index()
eval_df = (
    cv_sf2[["ds", "y", "arima", "ets", "snaive"]]
    .merge(cv_b[["ds", "boost"]], on="ds")
    .merge(cv_h[["ds", "arima_boost"]], on="ds")
)

y_train = df["y"].iloc[:-48].values
resumo = pd.DataFrame({
    nome: metricas(eval_df["y"], eval_df[nome], y_train)
    for nome in ["snaive", "ets", "arima", "boost", "arima_boost"]
}).T.sort_values("MASE")
resumo.round(1)| MAE | RMSE | MASE | |
|---|---|---|---|
| ets | 16051.5 | 20873.4 | 0.3 |
| arima_boost | 19514.4 | 23718.3 | 0.4 |
| boost | 21855.8 | 27281.6 | 0.5 |
| arima | 23680.5 | 27914.1 | 0.5 |
| snaive | 23886.9 | 30481.9 | 0.5 |
Código
fig, ax = plt.subplots(figsize=(12, 5))
ax.plot(df.index[-60:], df["y"].iloc[-60:], color=INSPER_GRAY,
        label="Observado", lw=1)
for nome, cor in [("arima", INSPER_RED), ("boost", INSPER_TURQUESA),
                  ("arima_boost", INSPER_AMARELO)]:
    ax.plot(eval_df["ds"], eval_df[nome], color=cor, label=nome, lw=1.6, alpha=0.85)
ax.set_title("Cross-validation em 4 janelas - produção de veículos",
             fontweight="bold")
ax.legend(loc="lower left")
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()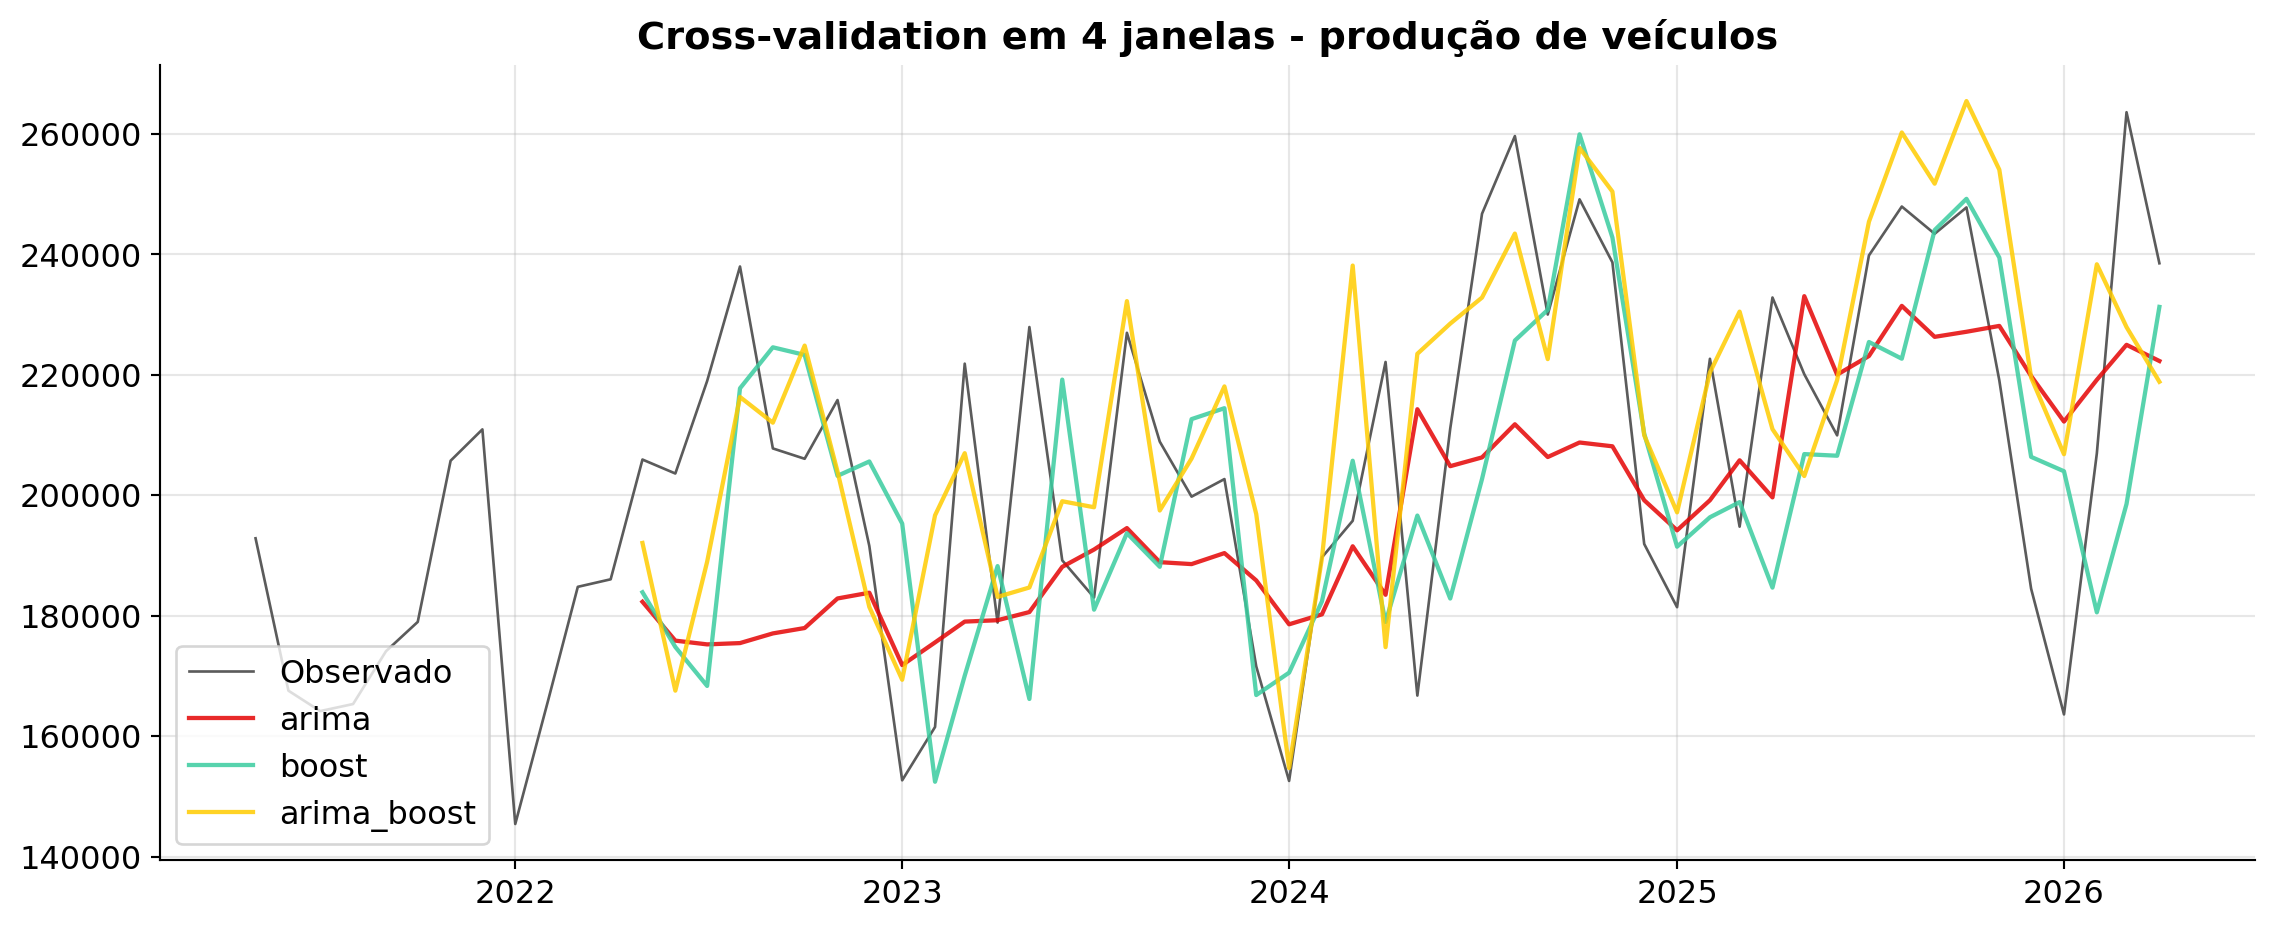
DicaLendo a tabela com olhar crítico
- Comparem sempre contra o
snaive. O MASE divide pelo erro do naive sazonal: MASE < 1 = ganhei do baseline; > 1 = perdi. Modelo sofisticado que não bate o naive não vale o custo operacional. - O choque da COVID distorce. As janelas que pegam 2020 punem qualquer modelo. A dummy
covidajuda os modelos de ML; o ARIMA puro sofre mais (precisaria de variável de intervenção). - “Mais sofisticado” ≠ “melhor”. Se o ARIMA-Boost não vence o ARIMA, é sinal de que o ARIMA já capturou o sinal e o boost só amplificou ruído. Validem sempre.
2.5 Comparação ampliada - ML, deep learning e foundation model
A tabela acima usa só os modelos que rodam leves no site. Mas a pergunta natural é: e os pesados - LightGBM, N-BEATS, Chronos - como se saem nesta mesma série? Rodamos offline (são dependências grandes: lightgbm, torch, neuralforecast, chronos-forecasting) exatamente o mesmo protocolo: SGS 1373, validação cruzada expanding de 4 janelas × 12 meses, MASE contra o SeasonalNaive.
| Modelo | MAE | RMSE | MASE |
|---|---|---|---|
| ETS (AutoETS) | 16.051 | 20.873 | 0,34 |
| ARIMA-Boost (híbrido) | 18.797 | 22.779 | 0,40 |
| Chronos (bolt-small, zero-shot) | 21.819 | 26.353 | 0,47 |
| GradientBoosting (sklearn) | 21.858 | 27.262 | 0,47 |
| AutoARIMA | 23.680 | 27.914 | 0,51 |
| SeasonalNaive (baseline) | 23.887 | 30.482 | 0,51 |
| LSTM (do zero, normalizado) | 24.385 | 29.212 | 0,52 |
| LightGBM | 25.689 | 33.201 | 0,55 |
| N-BEATS (treinado do zero) | 29.710 | 40.876 | 0,64 |
ImportanteO que essa tabela ensina (talvez a lição mais importante do lab)
- O modelo mais simples venceu. Um
AutoETS- três equações de suavização - bateu LightGBM, N-BEATS e o foundation model. Em séries univariadas, mensais, com ~168 observações, sazonalidade limpa e tendência suave, é exatamente o esperado: não há dados nem complexidade de sinal que justifiquem deep learning. - Chronos zero-shot foi competitivo sem ver um único ponto desta série (MASE 0,47, empatado com o GradientBoosting e bem acima do
snaive). Esse é o valor real dos foundation models: um baseline forte de graça, sem treino nem tuning - ótimo para prototipagem. - As redes do zero decepcionaram. O LSTM mal empata com o
SeasonalNaivee o N-BEATS foi o pior de todos - com ~168 pontos não há dados para a rede aprender (ela overfitta o ruído). Reforça a regra: deep learning pede muitos dados (ou muitas séries). - LightGBM perdeu para o GradientBoosting do sklearn aqui - não porque é pior, mas porque com poucos dados e sem tuning de hiperparâmetros o ganho do LightGBM não aparece. Em M5 (42 mil séries) a história se inverte.
Moral: suba a escada de complexidade só enquanto o ganho pagar o custo, e benchmark no seu próprio dado - nunca por reputação do modelo.
NotaCódigo de reprodução (não executa no site - dependências pesadas)
Mesmo df, construir_features e mase das células anteriores. Para rodar localmente: uv pip install lightgbm "torch --index-url https://download.pytorch.org/whl/cpu" chronos-forecasting neuralforecast.
Código
from lightgbm import LGBMRegressor
from neuralforecast import NeuralForecast
from neuralforecast.models import NBEATS
from chronos import BaseChronosPipeline
import torch

n, H, W = len(df), 12, 4
starts = [n - (W - i) * H for i in range(W)]
idx = df.index[starts[0]:]            # últimos 48 meses (4 janelas)

# --- regressores tabulares (mesma CV do GradientBoosting) ---
def cv_reg(make_model):
    X = construir_features(df["y"]).dropna()
    y = df["y"].loc[X.index]
    st = [len(X) - (W - i) * H for i in range(W)]
    return pd.concat([
        pd.Series(make_model().fit(X.iloc[:s], y.iloc[:s])
                  .predict(X.iloc[s:s+H]), index=X.index[s:s+H])
        for s in st
    ])

lgbm = cv_reg(lambda: LGBMRegressor(n_estimators=300, learning_rate=0.05,
                                    verbose=-1, random_state=42))

# --- N-BEATS (neuralforecast) ---
nf = NeuralForecast(
    models=[NBEATS(h=H, input_size=24, max_steps=400, scaler_type="standard")],
    freq="MS",
)
cv_nb = (nf.cross_validation(df=sf_df, n_windows=W, step_size=H)
           .reset_index().set_index("ds")["NBEATS"])

# --- Chronos zero-shot (foundation model) ---
pipe = BaseChronosPipeline.from_pretrained(
    "amazon/chronos-bolt-small", device_map="cpu", torch_dtype=torch.float32
)
ch = []
for s in starts:
    ctx = torch.tensor(df["y"].iloc[:s].values, dtype=torch.float32)
    _, mean = pipe.predict_quantiles(ctx, prediction_length=H,
                                     quantile_levels=[0.5])
    ch.append(pd.Series(mean.numpy().flatten()[:H], index=df.index[s:s+H]))
ch = pd.concat(ch)

# --- tabela final alinhada por data ---
E = pd.DataFrame({"y": df["y"].loc[idx]})
E["lightgbm"] = lgbm.reindex(idx)
E["nbeats"]   = cv_nb.reindex(idx)
E["chronos"]  = ch.reindex(idx)
# junte com eval_df (ets, arima, boost, arima_boost, snaive) e aplique `mase`
Fine-tuning do Chronos. O número acima é zero-shot (modelo congelado). O Chronos também aceita fine-tuning: você continua o treino do modelo pré-treinado por algumas épocas na sua própria série (ou no seu conjunto de séries), o que costuma reduzir o erro de forma relevante em domínios que diferem do pré-treino - ao custo de GPU e de perder a vantagem do “sem treino”. Há scripts oficiais no repositório do Chronos (
scripts/training). Para a entrega intermediária, o zero-shot já é um ótimo argumento de comparação; fine-tuning é um “se sobrar tempo / quiser impressionar”.
2.6 Redes neurais para séries
Quando há muitos dados, múltiplas séries relacionadas ou padrões não-lineares ricos, redes neurais entram em cena.
| Modelo | Ideia central | Quando usar |
|---|---|---|
| MLP | Camadas densas sobre uma janela de lags | Baseline neural simples |
| N-BEATS | Blocos que decompõem em tendência + sazonalidade (interpretável) | Forecasting univariado puro |
| NHITS | N-BEATS hierárquico multi-resolução | Horizontes longos; bateu Transformers em 2023 |
| LSTM / GRU | Memória de longo prazo via portas | Séries longas, dependências profundas |
| TCN | Convoluções dilatadas | Treina mais rápido que LSTM |
| DeepAR | Probabilístico, intervalos nativos | Muitas séries relacionadas |
| TFT | Transformer multi-horizonte com atenção interpretável | Multi-variável com covariáveis ricas |
N-BEATS - na prática
Na prática, o N-BEATS é uma rede feed-forward em que você entrega uma janela com as últimas \(L\) observações e ela devolve direto os próximos \(H\) valores. Você não escolhe ordens \((p,d,q)\), não diferencia, não monta features na mão: a rede aprende sozinha o mapeamento janela → futuro, inclusive padrões não-lineares.
Por dentro, ela soma a contribuição de vários “blocos”, onde cada bloco refina o que o anterior não conseguiu explicar (resíduo). Numa variante, esses blocos viram explicitamente tendência + sazonalidade, o que dá uma previsão interpretável (parecido com uma decomposição aprendida). O NHITS é a evolução: olha a série em várias resoluções e costuma ir melhor em horizontes longos.
flowchart LR
    I["Janela de entrada<br/>(últimos L meses)"] --> N["Rede N-BEATS<br/>(pilha de blocos)"]
    N --> O["Previsão<br/>(próximos H meses)"]
    style I fill:#5B5B5B,color:#fff
    style N fill:#E50505,color:#fff
    style O fill:#3ACC9F,color:#fff
Quando considerar: você tem muitas séries ou uma série longa e quer um modelo forte sem feature engineering manual. Caveat: é faminto por dados - aqui, com ~170 meses, ele perde feio (veja a tabela da seção 2.5).
LSTM - na prática
O LSTM lê a série passo a passo carregando uma memória (o estado da célula). A cada observação, três portas decidem o que esquecer da memória, que informação nova gravar e o que ler dela para a saída - é esse controle que deixa a rede “lembrar” de coisas distantes no tempo sem o gradiente sumir. Para prever, você passa a janela recente e a rede projeta os \(H\) passos à frente. Na prática: treina mais devagar (é sequencial), exige normalizar a série e precisa de bastante dado.
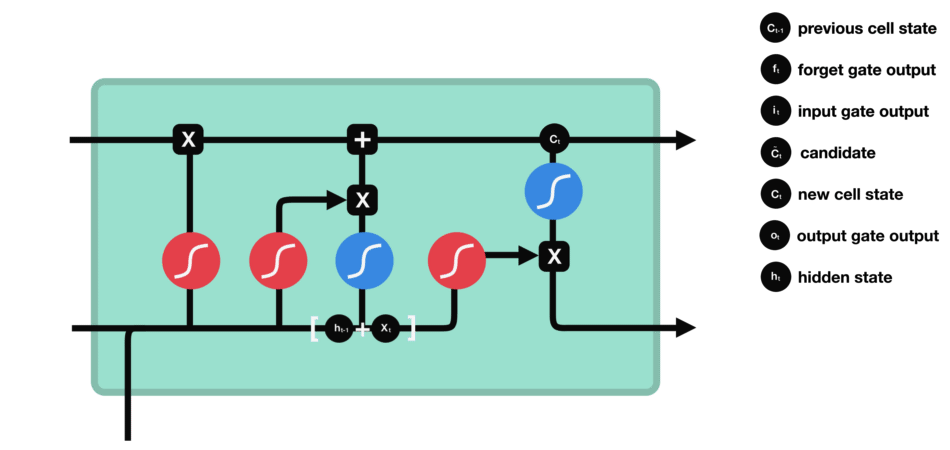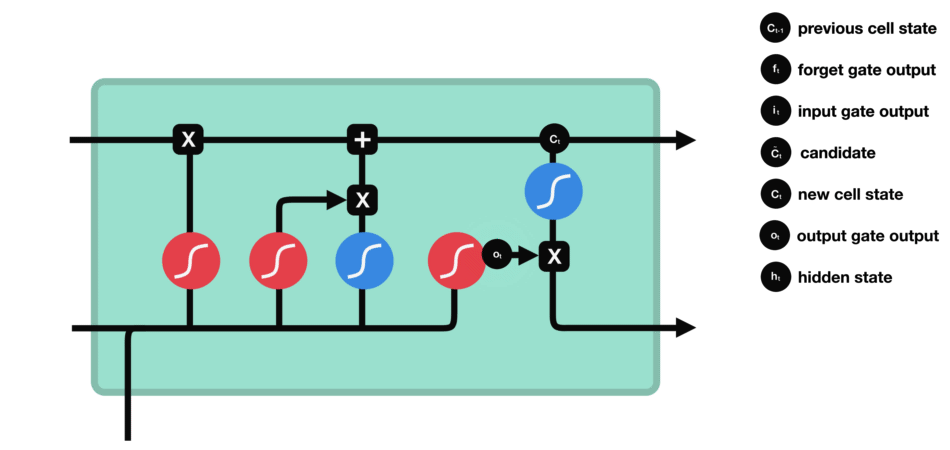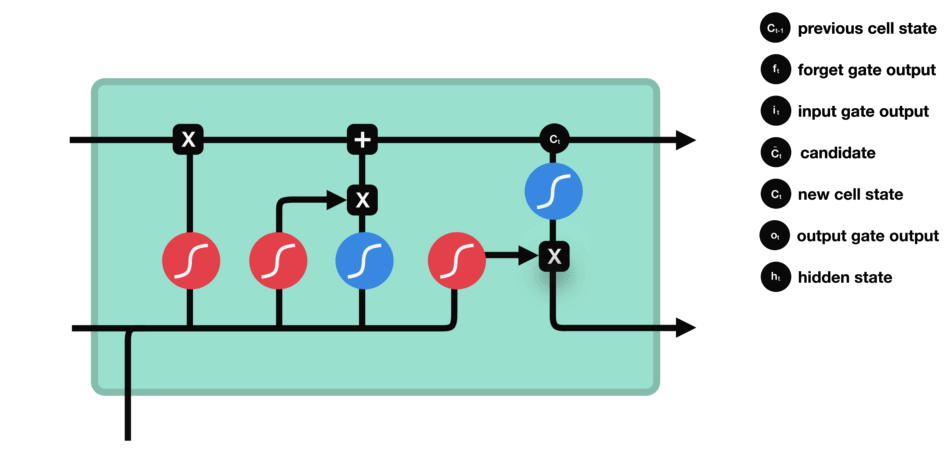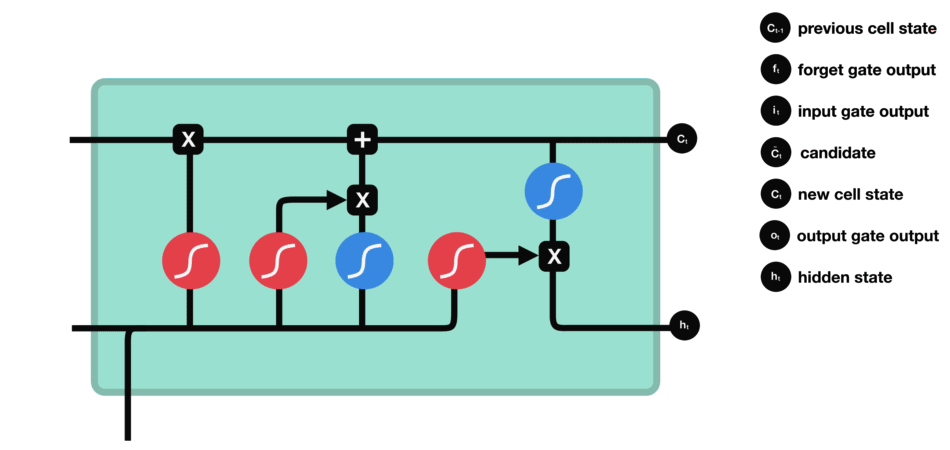
Crédito da figura: Michael Phi (Nguyen), Illustrated Guide to LSTM’s and GRU’s: A step by step explanation (2018) - usada aqui com fins didáticos. Para o material de referência sobre LSTMs, veja também Christopher Olah, Understanding LSTM Networks (2015).
Resultados nesta série (mesma CV, tabela da seção 2.5): o LSTM (normalizado, do zero) ficou em MASE 0,52 - praticamente empatado com o SeasonalNaive; o N-BEATS foi o pior (0,64). Com ~170 pontos não há dados para uma rede aprender; é o esperado, e o motivo de, neste lab, os modelos estruturais simples vencerem.
# Em DARTS, trocar de modelo é trocar uma linha:
# pip install u8darts[all]
from darts.models import NBEATSModel, NHiTSModel, TFTModel

modelo = NHiTSModel(input_chunk_length=24, output_chunk_length=12, n_epochs=50)
modelo.fit(serie[:-12])
prev = modelo.predict(n=12)
AvisoO paper que sacudiu a área
Zeng et al. (2023) - Are Transformers Effective for Time Series Forecasting? (2.500+ citações) mostrou que um modelo linear simples (DLinear) supera vários Transformers em benchmarks de longo horizonte. Mensagem: complexidade não é proxy de qualidade. Suba a escada: naive → ETS/ARIMA → boosting → neural → foundation, parando assim que o ganho não pagar o custo.
Benchmarks e competições
Antes de “qual modelo é o melhor?”, a resposta honesta é: depende da série, e a literatura mede isso com rigor. Vale conhecer as referências que o pessoal cita em entrevista e em comitê técnico.
As competições M (Makridakis) - a “Copa do Mundo” do forecasting
| Competição | Ano | Lição central |
|---|---|---|
| M3 | 2000 | Métodos simples (ETS) batiam complexos; combinação vence |
| M4 | 2018 | 100k séries; híbrido ES-RNN (estatístico + LSTM) venceu - fim do “ou estatístico ou ML” |
| M5 | 2020 | Vendas Walmart; LightGBM com feature engineering dominou o top-10 |
| M6 | 2022–23 | Financeiro (S&P 500); dificílimo bater o mercado - eficiência de mercado na prática |
| Benchmark | O que cobre | Link |
|---|---|---|
| Monash TSF Archive | 30+ datasets padronizados, baselines reprodutíveis | forecastingdata.org |
| GIFT-Eval (Salesforce) | Avaliação zero-shot de foundation models | HF Space |
| TFB (2024) | ~20 métodos, multidomínio, protocolo unificado | arXiv 2403.20150 |
| Kaggle forecasting | Competições reais; playbook prático | Bojer & Meldgaard (2021) |
NotaOs 3 consensos da literatura de benchmarks
- Combinação (ensemble) quase sempre ajuda. Média simples de 2–3 modelos diversos é robusta e barata.
- Boosting + bom feature engineering segue como referência industrial difícil de bater (M5, TFB).
- Não existe almoço grátis universal. O melhor modelo varia por frequência, horizonte e domínio - por isso benchmark no seu próprio dado é inegociável.
Foundation models
A grande virada de 2024–2025: modelos pré-treinados em bilhões de pontos de séries heterogêneas que fazem zero-shot forecasting - você passa a série e ele prevê, sem treinar nada. É o “GPT das séries temporais”.
Como eles funcionam
flowchart LR
    A["Pré-treino:<br/>milhões de séries<br/>(energia, varejo, clima, web...)"] --> B["Tokenização<br/>de valores numéricos"]
    B --> C["Transformer grande<br/>(decoder-only / encoder)"]
    C --> D["Modelo fundacional<br/>congelado"]
    D --> E["Sua série nova"]
    E --> F["Forecast zero-shot<br/>(sem fine-tuning)"]
    style A fill:#E50505,color:#fff
    style D fill:#FFCC00,color:#000
    style F fill:#3ACC9F,color:#fff
O truque conceitual: tratar previsão como modelagem de sequência (igual a um LLM prevendo a próxima palavra). Há duas escolas de “tokenização”:
- Quantização em vocabulário (Chronos): discretiza os valores em “tokens” e usa um T5 - literalmente a linguagem das séries.
- Patches contínuos (TimesFM, Moirai, PatchTST): fatia a série em pedaços e projeta cada pedaço num embedding, sem discretizar.
| Modelo | Quem fez | Característica |
|---|---|---|
| Chronos | Amazon (2024) | Tokeniza valores + T5; baseline zero-shot fortíssimo |
| TimesFM | Google (2024) | Decoder-only; treinado em ~100B pontos |
| Moirai | Salesforce (2024) | “Universal” - várias frequências e covariáveis |
| TimeGPT | Nixtla (2023–24) | API comercial; o mais fácil de usar (nixtla SDK) |
| Lag-Llama | ServiceNow/MILA (2024) | Probabilístico, transformer estilo Llama |
| Time-MoE | (2024) | Mixture-of-Experts, escala a bilhões de params |
| TTM | IBM (2024) | “Tiny” - leve, roda em CPU/dispositivo |
O Chronos (Amazon) é o mais fácil de testar: open-source, roda local na CPU, sem chave de API. É exatamente este que entrou na comparação da seção 2.5.
# Chronos (Amazon) - open-source, roda local, zero-shot
# pip install chronos-forecasting
import torch
from chronos import BaseChronosPipeline

pipe = BaseChronosPipeline.from_pretrained(
    "amazon/chronos-bolt-small", device_map="cpu", torch_dtype=torch.float32
)
ctx = torch.tensor(df["y"].values, dtype=torch.float32)
_, mean = pipe.predict_quantiles(            # zero-shot: nenhum treino
    ctx, prediction_length=12, quantile_levels=[0.5]
)
DicaZero-shot vs. fine-tuning do Chronos
O código acima é zero-shot: o modelo chega congelado e prevê direto - foi assim que ele tirou MASE 0,47 na seção 2.5, sem ver um único ponto da série. Para apertar mais, dá para fazer fine-tuning: continuar o treino do modelo pré-treinado por algumas épocas na sua própria série (ou conjunto de séries). Costuma ajudar quando o seu domínio difere bastante do que o Chronos viu no pré-treino - ao custo de GPU e de abrir mão da vantagem “sem treino”. Receita oficial em scripts/training no repo do Chronos. Para o trabalho intermediário, o zero-shot já é um ótimo ponto de comparação; fine-tuning fica como desafio extra.
NotaVantagens × desvantagens
✅ Vantagens
- Zero-shot: baseline competitivo sem dados de treino e sem tuning.
- Excelente para prototipagem rápida e para muitas séries heterogêneas (varejo multi-SKU, IoT).
- Lidam bem com séries curtas e com quebras estruturais (viram muitas no pré-treino).
❌ Desvantagens
- Caixa-preta: quase nenhuma interpretabilidade - ruim quando o cliente pergunta “por quê?”.
- Domínios atípicos: séries financeiras de alta frequência e padrões muito específicos ainda são caso difícil - o pré-treino pode não ter “visto” nada parecido.
- Custo/infra: modelos grandes pedem GPU; APIs (TimeGPT) têm custo e dependência externa.
- Não são mágica: em benchmarks como GIFT-Eval/TFB, um LightGBM bem ajustado ainda ganha em muitos casos com dados próprios suficientes.
Tendências (2024–2026)
- Foundation models viraram baseline real. Chronos, TimesFM, Moirai, TimeGPT, Time-MoE, TTM - zero-shot já entra como linha de comparação obrigatória.
- LLMs reaproveitados (Time-LLM, TEMPO) - reprogramam GPT/Llama via prompting numérico. Promissor mas ainda nichado.
- Lineares + boosting continuam imbatíveis em muitos casos práticos com dados próprios suficientes (M5, TFB).
Referências
Livros e tutoriais
- Hyndman, R.J. & Athanasopoulos, G. (2021). Forecasting: Principles and Practice, 3ª ed.
- Oudre, L. (2023). Apprentissage Statistique pour les Séries Temporelles - base do panorama de tarefas.
- Januschowski, T. et al. (2020). Criteria for Classifying Forecasting Methods. Int. J. Forecasting.
Competições e benchmarks
- Makridakis, S., Spiliotis, E., Assimakopoulos, V. (2022). The M5 accuracy competition: Results, findings and conclusions. Int. J. Forecasting.
- Makridakis, S. et al. (2020). The M4 Competition: 100,000 time series and 61 forecasting methods. Int. J. Forecasting.
- Makridakis, S. et al. (2023). The M6 forecasting competition. (financial forecasting).
- Bojer, C.S. & Meldgaard, J.P. (2021). Kaggle forecasting competitions: An overlooked learning opportunity. Int. J. Forecasting.
- Qiu, X. et al. (2024). TFB: Towards Comprehensive and Fair Benchmarking of Time Series Forecasting Methods.
- Monash TSF Archive · GIFT-Eval.
Deep learning para séries
- Oreshkin, B.N. et al. (2020). N-BEATS.
- Challu, C. et al. (2023). NHITS.
- Lim, B. et al. (2021). Temporal Fusion Transformers.
- Zeng, A. et al. (2023). Are Transformers Effective for Time Series Forecasting? - leitura obrigatória.
- Smyl, S. (2020). ES-RNN: hybrid exponential smoothing + RNN - vencedor do M4.
Foundation models e LLMs
- Ansari, A.F. et al. (2024). Chronos: Learning the Language of Time Series.
- Das, A. et al. (2024). A decoder-only foundation model for time-series forecasting (TimesFM).
- Woo, G. et al. (2024). Moirai.
- Garza, A. et al. (2023). TimeGPT-1 (Nixtla).
- Rasul, K. et al. (2024). Lag-Llama.
- Liang, Y. et al. (2024). Foundation Models for Time Series: A Tutorial and Survey.
- Jin, M. et al. (2024). Time-LLM · Cao, D. et al. (2024). TEMPO.
Bibliotecas
- statsforecast · mlforecast · neuralforecast (Nixtla).
- DARTS - catálogo unificado, inclui foundation models.
- sktime / aeon - classificação e regressão temporal.
- tsfresh - feature engineering automática.
- Chronos · TimeGPT/Nixtla.